দ্য কমপ্লিট ইঞ্জিনিয়ারিং হ্যান্ডবুক: প্রোডাকশন স্কেলেবিলিটির জন্য Data Structure এবং Algorithm
On this page
কোর ফিলোসফি (কেন আমরা এখানে?)
আপনি খুব যত্ন নিয়ে একটি দুর্দান্ত Web Application তৈরি করলেন। আপনার Localhost Environment-এ দশজন ইউজারের জন্য সবকিছু একদম রকেট স্পিডে কাজ করছে। প্রতিটি Request মিলি-সেকেন্ডে প্রসেস হচ্ছে, এবং Database কুয়েরিগুলো কোনো বিলম্ব ছাড়াই উত্তর দিচ্ছে। কিন্তু যেদিন আপনি আপনার অ্যাপ্লিকেশনটি Production সার্ভারে ডিপ্লয় করলেন এবং ট্রাফিক হঠাৎ বেড়ে এক লাখ ইউজার একযোগে Request পাঠালো, ঠিক তখনই এক ভয়াবহ বিপর্যয় ঘটল। আপনার Server-এর CPU এবং Memory ব্যবহার ১০০ শতাংশে পৌঁছে গেল, API রেসপন্স টাইম কয়েক সেকেন্ড পার হয়ে গেল, এবং শেষ পর্যন্ত পুরো সিস্টেম ক্র্যাশ করল। আপনি কি কখনো গভীরভাবে ভেবে দেখেছেন, কেন Localhost-এ নিখুঁতভাবে কাজ করা কোড Production-এর বাস্তব লোড সামলাতে গিয়ে এভাবে ভেঙে পড়ে?
আমাদের সফটওয়্যার ইঞ্জিনিয়ারিং ইন্ডাস্ট্রিতে একটি বিশাল ভুল ধারণা রয়েছে। অনেকেই মনে করেন, শুধুমাত্র কোনো একটি প্রোগ্রামিং ভাষার Syntax জানা, যেমন Loop চালানো বা If-Else কন্ডিশন লিখতে পারাই সফটওয়্যার ইঞ্জিনিয়ারিংয়ের মূল ভিত্তি। কিন্তু বাস্তব প্রোডাকশন সিস্টেমে শুধুমাত্র কোড লিখতে পারলেই Scalable সিস্টেম তৈরি করা যায় না। আপনার লেখা কোড যখন চলে, তখন কম্পিউটার কীভাবে Memory বা RAM-এর ভেতরে ডেটা সংরক্ষণ করছে এবং CPU কীভাবে সেই ডেটা প্রসেস করছে, সেই গভীর মেকানিজম না জানলে প্রোডাকশনে Request Bottleneck তৈরি হওয়া অবশ্যম্ভাবী। আপনি যত শক্তিশালী Hardware বা Cloud Server ব্যবহার করুন না কেন, অদক্ষ কোড আর্কিটেকচার পুরো সিস্টেমের কর্মক্ষমতাকে ধ্বংস করে দিতে পারে।
তাহলে Data Structure আসলে কী? সহজ কথায়, Data Structure হলো কম্পিউটারের Memory বা RAM-এর ভেতরে ডেটাকে অত্যন্ত দক্ষ ও গুছিয়ে রাখার একটি শিল্প। বিষয়টি বোঝার জন্য আমরা একটি বাস্তব জীবনের Analogy বিবেচনা করতে পারি। একটি অত্যন্ত অগোছালো ওয়ার্কশপ বা কারখানার কথা চিন্তা করুন, যেখানে হাজার হাজার যন্ত্রপাতি মেঝেতে এলোমেলোভাবে ছড়িয়ে-ছিটিয়ে আছে। সেই স্তূপ থেকে একটি নির্দিষ্ট স্ক্রু-ড্রাইভার খুঁজে বের করতে আপনার ত্রিশ মিনিট সময় নষ্ট হয়ে যাবে। এবার চিন্তা করুন একটি গুছিয়ে রাখা স্মার্ট টুলবক্সের কথা, যেখানে প্রতিটি যন্ত্রের জন্য আলাদা ও নির্দিষ্ট স্লট রয়েছে। সেই টুলবক্স থেকে আপনি চোখ বন্ধ করেও মাত্র কয়েক সেকেন্ডে সঠিক যন্ত্রটি তুলে নিতে পারবেন। Data Structure হলো আপনার কম্পিউটারের Memory-র জন্য সেই স্মার্ট টুলবক্স, যা ডেটাকে এমনভাবে সাজিয়ে রাখে যাতে প্রয়োজন মাত্রই দ্রুত খুঁজে পাওয়া এবং প্রসেস করা যায়।
অন্যদিকে, Algorithm হলো সেই গুছিয়ে রাখা ডেটার ওপর কাজ করার জন্য ধাপে ধাপে সাজানো লজিক্যাল ইনস্ট্রাকশন বা রেসিপি। আপনার কাছে পৃথিবীর সেরা টুলবক্স থাকতে পারে, কিন্তু সেই টুলস ব্যবহার করে কীভাবে একটি ইঞ্জিন মেরামত করতে হবে তার সঠিক পদক্ষেপ জানা না থাকলে কোনো কাজই হবে না। ঠিক একইভাবে, শুধুমাত্র ডেটা গুছিয়ে রাখলেই চলবে না, সেই ডেটা থেকে সঠিক তথ্য খুঁজে বের করা বা পরিবর্তন করার সবচেয়ে দ্রুততম লজিক্যাল পথটি বেছে নেওয়াই হলো Algorithm-এর কাজ। একটি উচ্চমানের Scalable সিস্টেম বা API তৈরি করার মূল চাবিকাঠি হলো সঠিক Data Structure-এর সাথে সবচেয়ে অপটিমাইজড Algorithm-এর নিখুঁত কম্বিনেশন। এই দুইয়ের মেলবন্ধন ছাড়া কোনো আধুনিক সফটওয়্যার আর্কিটেকচারই প্রোডাকশন গ্রেড হতে পারে না।
পারফরম্যান্স পরিমাপের মানদণ্ড (Big-O Notation এবং Trade-offs)
সফটওয়্যার ইঞ্জিনিয়ার হিসেবে যখন আমরা কোনো কোড বা লজিক লিখি, তখন সেই কোডটি কত দ্রুত কাজ করছে তা পরিমাপ করা অত্যন্ত জরুরি। কিন্তু আপনি যদি সেকেন্ড বা মিলি-সেকেন্ড দিয়ে আপনার কোডের গতি মাপতে যান, তবে সেটি হবে একটি বড় ইঞ্জিনিয়ারিং বোকামি। কারণ সময়ের এই পরিমাপ সম্পূর্ণভাবে নির্ভর করে হার্ডওয়্যারের ক্ষমতার ওপর। আপনার লেখা একটি কোড হয়তো আপনার সর্বাধুনিক শক্তিশালী ল্যাপটপে মাত্র দশ মিলি-সেকেন্ডে রান করছে, কিন্তু একই কোড যখন অন্য কোনো ইউজারের পুরোনো বা কম ক্ষমতার ডিভাইসে চলবে, তখন সেটি রান হতে এক সেকেন্ড সময় লেগে যেতে পারে। তাই আমাদের এমন একটি ইউনিভার্সাল বা সার্বজনীন পরিমাপক স্কেল প্রয়োজন, যা কোনো নির্দিষ্ট Hardware বা প্রসেসরের গতির ওপর নির্ভর করে না, বরং ইনপুট ডেটার আকার বৃদ্ধির সাথে সাথে কোডের কর্মক্ষমতা কীভাবে পরিবর্তিত হয় তা নির্দেশ করে।
এই ইউনিভার্সাল মানদণ্ডটি হলো Big-O Notation। এটি মূলত আমাদের জানায়, ইনপুট ডেটা বা nn-এর আকার যদি বাড়তে থাকে, তবে অ্যালগরিদমটি সম্পন্ন হতে প্রয়োজনীয় সময় বা মেমোরি কত দ্রুত হারে বৃদ্ধি পাবে। এখানে আমাদের দুটি প্রধান বিষয় নিয়ে চিন্তা করতে হয়: Time Complexity এবং Space Complexity। Time Complexity নির্দেশ করে কোডটি রান হতে কতটি লজিক্যাল অপারেশন বা ধাপ প্রয়োজন, আর Space Complexity নির্দেশ করে কোডটি রান হওয়ার সময় কম্পিউটারের Memory বা RAM-এ অতিরিক্ত কতটুকু জায়গা দখল করছে। প্রোডাকশন আর্কিটেকচারে এই দুইয়ের মধ্যে একটি ভারসাম্য বা Trade-off বজায় রাখা অত্যন্ত গুরুত্বপূর্ণ। অনেক সময় কোডের গতি বাড়ানোর জন্য আমাদের অতিরিক্ত Memory ব্যবহার করতে হয়, আবার কখনো মেমোরি বাঁচানোর জন্য কিছুটা বেশি প্রসেসিং টাইম মেনে নিতে হয়।
Big-O Notation-এর প্রধান কয়েকটি রূপ আমাদের প্রতিদিনের ইঞ্জিনিয়ারিং সিদ্ধান্তে প্রভাব ফেলে। এগুলো সহজ ভাষায় নিচে ব্যাখ্যা করা হলো:
- O(1) - Constant Time: এটি হলো সর্বশ্রেষ্ঠ পারফরম্যান্স। আপনার সিস্টেমে ডেটা দশটি থাকুক বা এক কোটি থাকুক, এই লজিকটি রান করতে সবসময় একদম একই সময় লাগবে। উদাহরণস্বরূপ, একটি Array থেকে তার Index নম্বর ব্যবহার করে সরাসরি কোনো ডেটা তুলে নেওয়ার সময় ডেটাসেটের আকারের ওপর নির্ভর করে না।
- O(n) - Linear Time: এক্ষেত্রে ইনপুট ডেটা যতগুণ বাড়বে, কোডটি রান করার সময়ও ঠিক ততগুণ বাড়বে। আপনি যদি একটি Array-এর শুরু থেকে শেষ পর্যন্ত Loop চালিয়ে কোনো একটি নির্দিষ্ট ডেটা খোঁজার চেষ্টা করেন, তবে এক কোটি ডেটার জন্য লুপটিকে সর্বোচ্চ এক কোটি বার ঘুরতে হতে পারে।
- O(log n) - Logarithmic Time: এটি অত্যন্ত স্মার্ট এবং দ্রুতগতির একটি পারফরম্যান্স প্যাটার্ন। এই পদ্ধতিতে প্রতি ধাপে খোঁজার জায়গা বা ডেটাসেটকে অর্ধেক করে কেটে বাদ দিয়ে দেওয়া হয়। ফলে ডেটার আকার দ্বিগুণ হলেও কাজের ধাপ বাড়ে মাত্র একটি। বড় ডেটাবেস বা সর্টেড লিস্টে কাজ করার জন্য এটি আদর্শ।
- O(n^2) - Quadratic Time: এটি হলো প্রোডাকশন সিস্টেমের নীরব ঘাতক। যখন আপনি কোনো কোডে Nested Loop ব্যবহার করেন, অর্থাৎ একটি লুপের ভেতরে আরেকটি লুপ চালান, তখন ডেটা কিছুটা বাড়লেই প্রসেসিং টাইম জ্যামিতিক হারে বেড়ে যায়। ডেটা এক হাজার হলে লুপ ঘুরবে দশ লাখ বার, যা মুহূর্তেই আপনার Server-কে ফ্রিজ করে দিতে পারে।
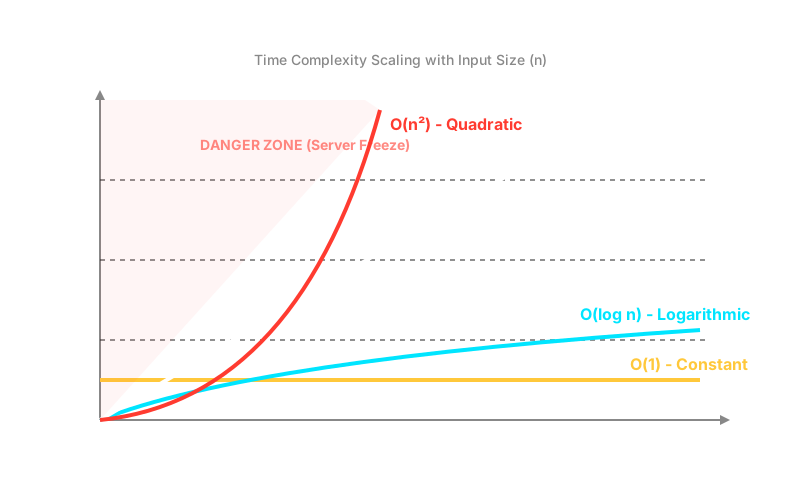
উপরের ডায়াগ্রামটি লক্ষ্য করুন। এখানে স্পষ্টভাবে ভিজ্যুয়ালাইজ করা হয়েছে কীভাবে ইনপুট ডেটা বা nn-এর মান বৃদ্ধির সাথে সাথে বিভিন্ন Big-O Complexity-এর কর্মক্ষমতা পরিবর্তিত হয়। প্রোডাকশন পরিবেশে আমাদের সর্বদা চেষ্টা থাকে কোডকে O(1) বা O(log n)-এর ভেতরে রাখার, এবং যেকোনো মূল্যে O(n^2) বা তার চেয়ে খারাপ লজিক পরিহার করার।
মেমোরি লেআউট এবং Linear Data Structures (ফাউন্ডেশন)
Data Structure গভীরভাবে বোঝার জন্য আমাদের প্রথমে জানতে হবে কম্পিউটারের Memory বা RAM আসলে কীভাবে কাজ করে। আপনি যখন কম্পিউটারে কোনো Variable বা ডেটা তৈরি করেন, তখন সেটি RAM-এর ভেতরে একটি নির্দিষ্ট জায়গায় গিয়ে জমা হয়। RAM-কে আপনি কোটি কোটি ছোট ছোট বাক্সের একটি দীর্ঘ সারি হিসেবে কল্পনা করতে পারেন। প্রতিটি বাক্সে এক Byte করে ডেটা রাখা যায় এবং প্রতিটি বাক্সের একটি নিজস্ব ও অদ্বিতীয় নম্বর বা Memory Address থাকে, ঠিক যেমন শহরের প্রতিটি বাড়ির একটি নির্দিষ্ট হোল্ডিং নম্বর থাকে। যখন CPU কোনো ডেটা পড়তে বা লিখতে চায়, তখন সে সরাসরি সেই Memory Address ধরে যোগাযোগ করে।
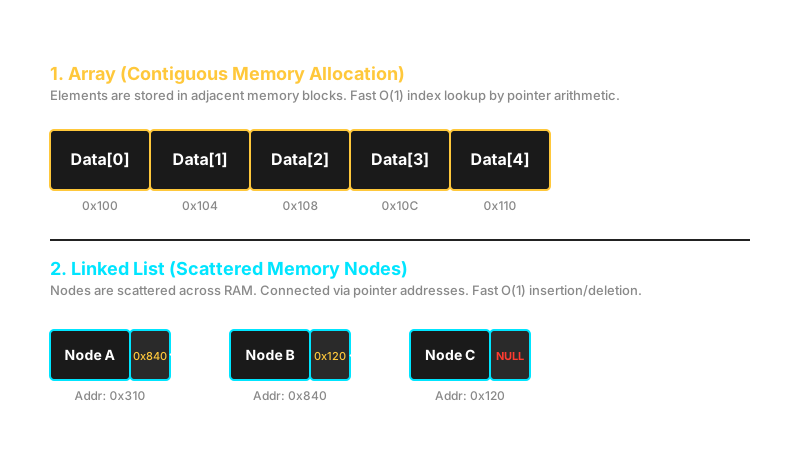
এই মেমোরি লেআউটের ওপর ভিত্তি করে আমরা যে মৌলিক Data Structure-টি সবচেয়ে বেশি ব্যবহার করি, তা হলো Array। Array হলো মেমোরির ভেতরে একদম টানা এবং সিরিয়াল ব্লক বা পরপর সাজানো বাক্সের সমষ্টি। আপনি যখন মেমোরিতে একটি Array ঘোষণা করেন, তখন সিস্টেম আপনার জন্য মেমোরির একটি নির্দিষ্ট স্থান থেকে পরপর কয়েকটি ব্লক বরাদ্দ করে। বিষয়টি বোঝার জন্য আমরা একটি সিনেমার হলের Analogy চিন্তা করতে পারি। সিনেমার হলে যখন আপনি বন্ধুদের সাথে পাশাপাশি বসার জন্য একসাথে পাঁচটি আসন বুকিং করেন, তখন টিকিট কাউন্টার আপনাকে একই সারির পরপর পাঁচটি আসন বরাদ্দ দেয়। Array ঠিক এভাবেই মেমোরিতে টানা জায়গা দখল করে অবস্থান করে।
Array-তে কোনো একটি ইনডেক্স ধরে ডেটা পড়া বা Read করার কাজ O(1) বা Constant Time-এ ঘটে। কারণ মেমোরিতে ডেটাগুলো পরপর থাকে এবং কম্পিউটার একটি সাধারণ গাণিতিক সূত্র ব্যবহার করে যেকোনো ইনডেক্সের মেমোরি অ্যাড্রেস সরাসরি বের করে ফেলতে পারে। সূত্রটি হলো: Target Address=Base Address+(Index×Size of Element)Target Address=Base Address+(Index×Size of Element)। কিন্তু Array-এর একটি বড় দুর্বলতা হলো মাঝখান থেকে ডেটা ডিলিট বা ইনসার্ট করা। আপনি যদি একটি Array-এর মাঝখানে নতুন কোনো ডেটা ঢোকাতে চান, তবে সেই স্থানের পেছনের সমস্ত ডেটাকে এক ঘর করে ডানদিকে সরিয়ে জায়গা খালি করতে হবে। এক কোটি ডেটার Array হলে এই সরাসরির কাজটি অত্যন্ত ধীরগতির এবং এটি O(n) Time Complexity তৈরি করে।
এই সীমাবদ্ধতা দূর করার জন্যই আমরা ব্যবহার করি Linked List। Linked List-এর ক্ষেত্রে ডেটাগুলো মেমোরির ভেতরে Array-এর মতো পরপর বা টানা ব্লকে থাকার কোনো প্রয়োজন নেই। মেমোরির যেখানেই ফাঁকা জায়গা পাওয়া যায়, সেখানেই একটি ডেটা ব্লক বা Node বসে যেতে পারে। প্রতিটি Node-এর ভেতরে দুটি জিনিস থাকে: একটি হলো আসল ডেটা, এবং অপরটি হলো পরবর্তী Node-এর Memory Address বা Pointer। এই আর্কিটেকচারটি বোঝার জন্য আমরা একটি ট্রেজার হান্ট বা গুপ্তধন খোঁজার খেলার Analogy ব্যবহার করতে পারি। খেলায় আপনি যখন প্রথম ক্লু বা চিরকুটটি পান, সেখানে লেখা থাকে পরবর্তী চিরকুটটি কোথায় লুকানো আছে। সেই লোকেশনে গিয়ে আপনি দ্বিতীয় চিরকুটটি পান, যা আপনাকে তৃতীয় লোকেশনের পথ দেখায়। Linked List ঠিক এই চেইন পদ্ধতিতে কাজ করে।
Array এবং Linked List-এর মধ্যে কোনটি আপনি প্রোডাকশনে ব্যবহার করবেন, তা নির্ভর করে আপনার Use Case-এর ওপর। যদি আপনার সিস্টেমে বারবার ইনডেক্স ধরে ডেটা পড়ার প্রয়োজন বেশি থাকে, তবে Array হলো সেরা পছন্দ। কিন্তু যদি আপনার সিস্টেমে প্রতিনিয়ত মাঝখান থেকে ডেটা ইনসার্ট বা ডিলিট করার প্রয়োজন হয় এবং ডেটার আকার আগে থেকে জানা না থাকে, তবে Linked List আপনাকে অনেক বেশি পারফরম্যান্স সুবিধা দেবে, কারণ এখানে ডেটা সরানোর কোনো প্রয়োজন হয় না, শুধু Pointer-এর ঠিকানা বদলে দিলেই কাজ শেষ হয়।
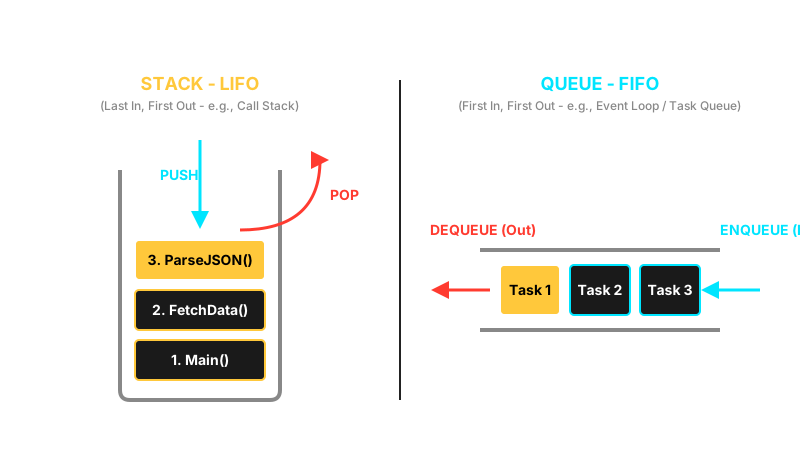
Linear Data Structure-এর জগতে আরও দুটি অত্যন্ত গুরুত্বপূর্ণ কনসেপ্ট হলো Stack এবং Queue। Stack কাজ করে LIFO (Last In, First Out) মডেলে। এর একটি চমৎকার Analogy হলো ডাইনিং টেবিলে সাজিয়ে রাখা প্লেটের স্তূপ। আপনি যখন প্লেটগুলো ধুয়ে একটির ওপর আরেকটি সাজিয়ে রাখেন, তখন সবার শেষে যে প্লেটটি আপনি সবার ওপরে রেখেছেন, খাওয়ার সময় সেই উপরের প্লেটটিই সবার আগে তুলে নিতে হয়। সফটওয়্যার ইঞ্জিনিয়ারিংয়ে এর ব্যবহার প্রচুর। যেমন, ওয়েব ব্রাউজারের Back বাটন, কোড এক্সিকিউশনের Call Stack, এবং যেকোনো টেক্সট এডিটরের Undo-Redo ফিচার সম্পূর্ণভাবে Stack-এর LIFO আর্কিটেকচারে কাজ করে।
অন্যদিকে, Queue কাজ করে FIFO (First In, First Out) মডেলে। এর বাস্তব Analogy হলো ব্যাংকের ক্যাশ কাউন্টারে বা সিনেমার টিকিট কাউন্টারে দাঁড়িয়ে থাকা মানুষের লাইন। যে ব্যক্তি সবার আগে লাইনে এসে দাঁড়াবেন, তিনি সবার আগে সেবা নিয়ে কাউন্টার ত্যাগ করবেন। ব্যাকএন্ড এবং সিস্টেম আর্কিটেকচারে Queue একটি অপরিহার্য উপাদান। Node.js-এর Event Loop, মাইক্রোসার্ভিস আর্কিটেকচারের Background Job Processing, এবং বিপুল পরিমাণ রিকোয়েস্ট সামলানোর জন্য ব্যবহৃত Task Queue বা Message Broker (যেমন RabbitMQ বা Kafka) এই FIFO নীতির ওপর ভিত্তি করেই স্কেল করে।
দ্রুততম ডেটা লুকআপ (Hash Table এবং Map)
প্রোডাকশন সফটওয়্যার ইঞ্জিনিয়ারিংয়ে আমরা যখন বিশাল আকারের ডেটাসেট নিয়ে কাজ করি, তখন আমাদের প্রধান লক্ষ্য থাকে কত দ্রুত কোনো একটি নির্দিষ্ট ডেটা খুঁজে বের করা যায়। আপনি যদি এক কোটি ইউজারের একটি ডেটাবেস থেকে কোনো একজন ইউজারের ইমেইল অ্যাড্রেস বা প্রোফাইল মাত্র এক মিলি-সেকেন্ডের মধ্যে খুঁজে বের করতে চান, তবে Array বা Linked List দিয়ে সেটি সম্ভব নয়। এই ধরনের অতি দ্রুত লুকআপ বা খোঁজার কাজের জন্য ইঞ্জিনিয়ারদের সবচেয়ে শক্তিশালী অস্ত্র হলো Hash Table বা Map। Hash Table যেকোনো সাইজের ডেটাবেস বা লিস্ট থেকে মাত্র O(1) বা Constant Time-এ ডেটা খুঁজে বের করার ম্যাজিক দেখাতে পারে।
এই ম্যাজিকের পেছনের মূল শক্তিটি হলো Hashing এবং Hash Function। Hash Function হলো একটি বিশেষ ধরনের ম্যাথমেটিক্যাল অ্যালগরিদম, যা যেকোনো String, নাম্বার বা চাবিকে (Key) ইনপুট হিসেবে গ্রহণ করে এবং একটি নির্দিষ্ট গাণিতিক ক্যালকুলেশন করে সেটিকে একটি পূর্ণসংখ্যা বা Memory Index-এ রূপান্তর করে। উদাহরণস্বরূপ, আপনি যখন "user_1029" চাবিটি Hash Table-এ পাঠাবেন, তখন Hash Function একটি গাণিতিক সূত্র ব্যবহার করে বলে দেবে যে মেমোরির ঠিক ৪২ নম্বর স্লটে এই ইউজারের ডেটা রাখা আছে। পরবর্তীতে যখন আপনি আবার "user_1029" এর ডেটা দেখতে চাইবেন, সিস্টেম কোনো Loop না চালিয়ে সরাসরি Hash Function ব্যবহার করে ৪২ নম্বর স্লট থেকে ডেটাটি আপনার সামনে হাজির করবে।
// একটি সিম্পল Hash Function-এর উদাহরণ যা String Key-কে Array Index-এ রূপান্তর করেfunction simpleHash(key: string, arraySize: number): number {    let hash = 0;    for (let i = 0; i < key.length; i++) {        // প্রতিটি অক্ষরের ASCII কোডের সাথে গাণিতিক হিসাব করা হচ্ছে        hash = (hash + key.charCodeAt(i) * 31) % arraySize;    }    return hash;}
const tableSize = 100;const index = simpleHash("user_profile_dhaka", tableSize);console.log(`Data will be stored at index: ${index}`);
তবে Hash Table-এর এই অপূর্ব সিস্টেমে একটি বড় ইঞ্জিনিয়ারিং চ্যালেঞ্জ রয়েছে, যাকে বলা হয় Hash Collision। যেহেতু আমাদের মেমোরি বা Array স্লটের সংখ্যা সীমাবদ্ধ, কিন্তু ইনপুট হিসেবে আসা Key-এর সংখ্যা অসীম হতে পারে, তাই মাঝেমধ্যেই এমন ঘটনা ঘটে যখন দুটি সম্পূর্ণ আলাদা Key-কে Hash Function একই মেমোরি স্লট বা ইনডেক্স বরাদ্দ করে দেয়। উদাহরণস্বরূপ, "dhaka" এবং "sylhet" এই দুটি আলাদা শব্দের হ্যাশ ক্যালকুলেশন করে যদি উভয়ের রেজাল্টই ১৫ নম্বর স্লট আসে, তখন তাকে Hash Collision বলা হয়। এই পরিস্থিতি সঠিক লজিক দিয়ে হ্যান্ডেল না করলে সিস্টেম ক্র্যাশ করতে পারে বা ডেটা হারিয়ে যেতে পারে।
সফটওয়্যার আর্কিটেকচারে Hash Collision সমাধানের জন্য মূলত দুটি অত্যন্ত জনপ্রিয় এবং কার্যকরী পদ্ধতি ব্যবহার করা হয়:
- Chaining (চেইনিং): এই পদ্ধতিতে Hash Table-এর প্রতিটি মেমোরি স্লটে সরাসরি একটি ডেটা না রেখে, সেখানে একটি Linked List-এর Head বা শুরু ঝুলিয়ে দেওয়া হয়। যখনই কোনো মেমোরি স্লটে Collision ঘটে এবং একাধিক ডেটা একই ইনডেক্সে এসে পড়ে, তখন নতুন ডেটাটিকে সেই স্লটের Linked List-এর সাথে একটি নতুন Node হিসেবে চেইন করে যুক্ত করে দেওয়া হয়। ডেটা খোঁজার সময় প্রথমে Hash Function দিয়ে ইনডেক্স বের করা হয়, তারপর সেই স্লটের ছোট Linked List-টিতে কয়েকটি ধাপ লুপ চালিয়ে সঠিক ডেটাটি খুঁজে নেওয়া হয়।
- Open Addressing (ওপেন অ্যাড্রেসিং): এই পদ্ধতিতে মেমোরি স্লটে কোনো Linked List ব্যবহার করা হয় না। যখন কোনো একটি স্লটে নতুন ডেটা রাখার সময় দেখা যায় স্লটটি আগে থেকেই অন্য কোনো ডেটা দ্বারা দখল হয়ে আছে, তখন সিস্টেম স্বয়ংক্রিয়ভাবে পরবর্তী ফাঁকা স্লটটির খোঁজ করতে শুরু করে। এটি করার জন্য Linear Probing (পরপর এক ঘর করে এগিয়ে ফাঁকা স্লট খোঁজা) বা Quadratic Probing (গাণিতিক লাফ দিয়ে ফাঁকা স্লট খোঁজা) ব্যবহার করা হয়। যে স্লটটি প্রথমে ফাঁকা পাওয়া যায়, সেখানেই নতুন ডেটাটিকে বসিয়ে দেওয়া হয়।
Non-Linear Structures (স্কেল করার আসল শক্তি)
আমরা এতক্ষণ যে Data Structure-গুলো নিয়ে আলোচনা করেছি, যেমন Array, Linked List, Stack, বা Queue, সেগুলো সবই ছিল Linear Data Structure। অর্থাৎ এখানে ডেটাগুলো একটি সরলরেখা বা সোজা লাইনে পরপর সাজানো থাকে। কিন্তু বাস্তব পৃথিবীর অনেক জটিল সমস্যা এবং বিশাল ডেটাসেটকে একটি সোজা লাইনে সমাধান করা সম্ভব নয়। যখন আমাদের সিস্টেমে ডেটার মধ্যে হায়েরার্কি বা একটির অধীনে আরেকটি ডেটার সম্পর্ক তৈরি করার প্রয়োজন হয়, তখন আমাদের Non-Linear Data Structure-এর জগতে প্রবেশ করতে হয়। এই জগতের সবচেয়ে গুরুত্বপূর্ণ এবং শক্তিশালী দুটি স্তম্ভ হলো Tree এবং Graph।
Tree এবং বিশেষ করে Binary Search Tree (BST) হলো এমন একটি আর্কিটেকচার যা ডেটাকে হায়েরার্কি অনুযায়ী সাজিয়ে রাখে। এর একটি চমৎকার Analogy হলো কোনো একটি বড় কর্পোরেট কোম্পানির অর্গানোগ্রাম বা আমাদের পরিবারের ফ্যামিলি ট্রি। কোম্পানির অর্গানোগ্রামে সবার ওপরে থাকেন একজন CEO, তার অধীনে থাকেন কয়েকজন ডিরেক্টর, তাদের অধীনে ম্যানেজার এবং তাদের অধীনে সাধারণ ইঞ্জিনিয়ারগণ। Tree Data Structure ঠিক এভাবেই কাজ করে, যেখানে সবার উপরের ডেটাটিকে বলা হয় Root Node, এবং তার নিচের শাখা-প্রশাখাগুলোকে বলা হয় Child Node।
কেন আধুনিক Relational Database এবং অপারেটিং সিস্টেমের File System সাধারণ Array ব্যবহার না করে Tree ব্যবহার করে? এর প্রধান কারণ হলো খোঁজার বা Search করার অসম্ভব দ্রুত গতি। একটি Binary Search Tree (BST)-তে একটি বিশেষ নিয়ম মানা হয়: যেকোনো Node-এর বাম দিকের শাখায় সবসময় ছোট ডেটা থাকবে, এবং ডান দিকের শাখায় সবসময় বড় ডেটা থাকবে। এর ফলে আপনি যখন কোনো ডেটা খুঁজবেন, তখন প্রতি ধাপে আপনি নিশ্চিতভাবে বলতে পারবেন ডেটাটি বামে আছে নাকি ডানে। এই লজিকের কারণে প্রতি ধাপে খোঁজার ডেটাসেট ঠিক অর্ধেক হয়ে যায়, যা আমাদের O(log n) Time Complexity প্রদান করে।
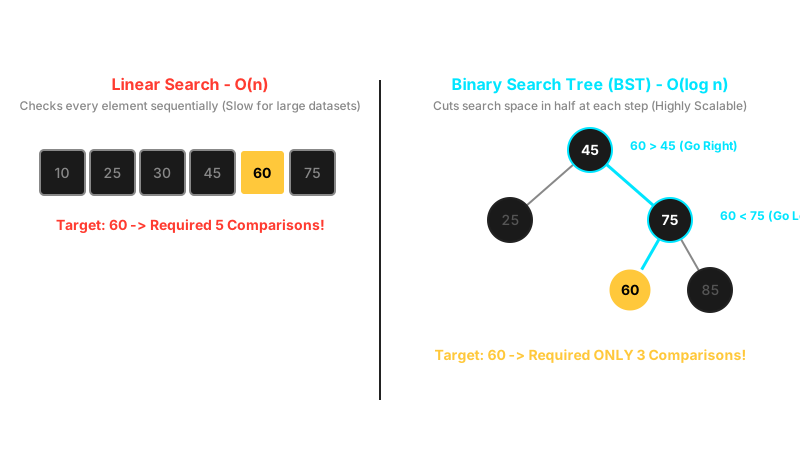
উপরের ডায়াগ্রামটি থেকে আপনি বুঝতে পারবেন, এক কোটি ডেটার একটি সাধারণ Array-তে Linear Search চালিয়ে শেষ ডেটাটি খুঁজে পেতে এক কোটি বার লুপ ঘুরাতে হতো। অথচ একটি ব্যালেন্সড Binary Search Tree বা BST ব্যবহার করে একই এক কোটি ডেটার ভেতর থেকে যেকোনো ডেটা খুঁজে বের করতে সর্বোচ্চ মাত্র ২৪ থেকে ৩০টি ধাপের প্রয়োজন হয়। প্রোডাকশন সিস্টেমে এই পারফরম্যান্স পার্থক্যটিই নির্ধারণ করে আপনার API কি মিলি-সেকেন্ডে উত্তর দেবে নাকি টাইমআউট হয়ে ক্র্যাশ করবে।
Tree-এর গণ্ডি পেরিয়ে আমরা যখন আরও জটিল ও বাস্তবমুখী নেটওয়ার্ক লজিক নিয়ে কাজ করি, তখন আমাদের প্রয়োজন হয় Graph Data Structure। Tree হলো Graph-এরই একটি বিশেষ রূপ, যেখানে কোনো সাইকেল বা লুপ থাকতে পারে না এবং সবার একটি নির্দিষ্ট Root থাকে। কিন্তু Graph-এ এমন কোনো সীমাবদ্ধতা নেই। Graph মূলত দুটি জিনিস নিয়ে গঠিত: Node (বা Vertex), যা কোনো একটি বস্তু বা স্থানকে নির্দেশ করে, এবং Edge, যা দুটি Node-এর মধ্যকার সম্পর্ক বা সংযোগের পথ নির্দেশ করে।
বাস্তব সফটওয়্যার ইঞ্জিনিয়ারিংয়ে Graph-এর ব্যবহার সর্বত্র বিদ্যমান। উদাহরণস্বরূপ, Facebook বা LinkedIn-এর সোশ্যাল মিডিয়া ফ্রেন্ড লিস্ট একটি বিশাল Graph। এখানে প্রতিটি ইউজার হলো একটি করে Node, এবং দুজনের মধ্যকার বন্ধুত্ব হলো একটি Edge। যখন আপনি "Friends of Friends" বা মিউচুয়াল ফ্রেন্ড বের করতে চান, তখন ব্যাকএন্ডে Graph Traversal অ্যালগরিদম কাজ করে। একইভাবে, Google Maps বা Uber-এর মতো রাইড-শেয়ারিং অ্যাপ্লিকেশনে পুরো শহরের রাস্তাঘাটকে একটি Graph হিসেবে মেমোরিতে রাখা হয়, যেখানে মোড়গুলো হলো Node এবং রাস্তাগুলো হলো Edge। এক স্থান থেকে অন্য স্থানে যাওয়ার সবচেয়ে ছোট এবং দ্রুততম রাস্তাটি (Shortest Path Calculation) বের করার জন্য Dijkstra বা A* এর মতো Graph অ্যালগরিদম ব্যবহার করা হয়। এছাড়া ইন্টারনেট এবং নেটওয়ার্ক রাউটিং প্রোটোকলগুলো সম্পূর্ণভাবে Graph আর্কিটেকচারের ওপর ভিত্তি করে ডেটা প্যাকেট আদান-প্রদান করে।
কোর অ্যালগরিদমিক টেকনিক এবং প্যারাডাইম
ডেটাকে সঠিকভাবে মেমোরিতে সাজানোর পর আমাদের পরবর্তী কাজ হলো সেই ডেটার ওপর বিভিন্ন লজিক বা অপারেশন চালানো। এই কাজের জন্য আমাদের কিছু কোর অ্যালগরিদমিক টেকনিক এবং সমস্যা সমাধানের প্যারাডাইম বা চিন্তাধারা আয়ত্ত করতে হয়। সফটওয়্যার ইঞ্জিনিয়ারিংয়ে আমরা সবচেয়ে বেশি যে দুটি কাজের মুখোমুখি হই, তা হলো Searching (ডেটা খোঁজা) এবং Sorting (ডেটা সাজানো)।
Searching-এর ক্ষেত্রে আমরা ইতোমধ্যে দেখেছি যে Linear Search হলো সবচেয়ে ধীরগতির পদ্ধতি, যেখানে লুপ চালিয়ে এক এক করে ডেটা মেলাতে হয়, যার Complexity O(n)। কিন্তু আপনার ডেটাসেট যদি আগে থেকেই ছোট থেকে বড় ক্রমানুসারে সাজানো বা Sorted থাকে, তবে আপনি ব্যবহার করতে পারেন Binary Search। এটি একটি অত্যন্ত শক্তিশালী অ্যালগরিদম, যা প্রতি ধাপে মাঝখানের ডেটার সাথে টার্গেট ডেটা মেলায় এবং এক লাফে ডেটাসেটের অর্ধেক অংশ বাদ দিয়ে দেয়। இதன் ফলে O(log n) সময়েই যেকোনো ডেটা খুঁজে পাওয়া সম্ভব হয়।
এবার আসুন Sorting বা ডেটা সাজানোর বিষয়ে কথা বলি। প্রোডাকশন সিস্টেমে ডেটা সাজিয়ে রাখা অত্যন্ত জরুরি, কারণ সর্টেড ডেটা ছাড়া Binary Search বা দ্রুতগতির কুয়েরি চালানো অসম্ভব। ছোটখাটো ডেটার জন্য সাধারণ সর্টিং অ্যালগরিদম কাজ করলেও, লাখ লাখ বা কোটি কোটি ডেটাবেস রেকর্ড সর্ট করার জন্য আমাদের উন্নত অ্যালগরিদম প্রয়োজন, যার মধ্যে সবচেয়ে জনপ্রিয় হলো QuickSort এবং MergeSort।
- QuickSort: এটি একটি Divide and Conquer অ্যালগরিদম। এটি ডেটাসেট থেকে যেকোনো একটি ডেটাকে Pivot হিসেবে বেছে নেয় এবং সেই Pivot-এর চেয়ে ছোট সব ডেটাকে বামে আর বড় সব ডেটাকে ডানে পাঠিয়ে দেয়। এরপর বাম ও ডান অংশকে আলাদাভাবে একই পদ্ধতিতে সর্ট করে। এর গড় Time Complexity হলো O(n log n) এবং এটি মেমোরিতে অতিরিক্ত জায়গা বা Space খুব কম ব্যবহার করে। তবে ডেটা যদি আগে থেকেই উল্টোভাবে সাজানো থাকে এবং সঠিক Pivot নির্বাচন করা না হয়, তবে এর Worst Case পারফরম্যান্স O(n^2) হয়ে যেতে পারে।
- MergeSort: এটিও Divide and Conquer নীতির ওপর কাজ করে। এটি পুরো ডেটাসেটকে মাঝখান থেকে কেটে ছোট ছোট ভাগে ভাগ করতে থাকে যতক্ষণ না প্রতিটি ভাগে মাত্র একটি করে ডেটা অবশিষ্ট থাকে। এরপর সেই ছোট ভাগগুলোকে ক্রমানুসারে জোড়া লাগিয়ে বা Merge করে একটি সম্পূর্ণ সর্টেড লিস্ট তৈরি করে। এর সবচেয়ে বড় সুবিধা হলো, ডেটা যেমনই থাকুক না কেন, এটি সবসময় নিশ্চিতভাবে O(n log n) সময়েই কাজ শেষ করবে। তবে এর Trade-off হলো, ডেটাগুলোকে জোড়া লাগানোর সময় এর অতিরিক্ত মেমোরি বা O(n) Space Complexity প্রয়োজন হয়।
কোনো একটি নতুন বা জটিল ইঞ্জিনিয়ারিং সমস্যার মুখোমুখি হলে আমরা কীভাবে চিন্তা করব? সফটওয়্যার ইঞ্জিনিয়ারিংয়ে সমস্যা সমাধানের জন্য মূলত ৩টি বড় চিন্তাধারা বা Algorithmic Paradigms রয়েছে:
- Brute Force (ব্রুট ফোর্স): এটি হলো কোনো স্মার্টনেস বা অপটিমাইজেশন ছাড়া সমস্যার সমাধান করার সবচেয়ে সাধারণ পদ্ধতি। এই পদ্ধতিতে একটি সমস্যার যতগুলো সম্ভাব্য সমাধান বা রাস্তা থাকতে পারে, তার সবগুলো একে একে চেষ্টা করে দেখা হয়। এটি কোড করা সহজ এবং এটি সবসময় সঠিক উত্তর দেয়, কিন্তু প্রোডাকশন সিস্টেমে এটি অত্যন্ত ধীরগতির এবং এর Time Complexity প্রায়ই O(n^2) বা O(2^n) হয়ে যায়।
- Greedy Algorithm (গ্রিডি অ্যালগরিদম): এই চিন্তাধারায় ভবিষ্যতের কথা বা সামগ্রিক ফলের কথা চিন্তা না করে, বর্তমান মুহূর্তে দাঁড়িয়ে যে সিদ্ধান্তটিকে সবচেয়ে সেরা বা লাভজনক মনে হয়, সেটিই গ্রহণ করা হয়। প্রতি ধাপে Locally Optimal সিদ্ধান্ত নিয়ে একটি Globally Optimal সমাধানে পৌঁছানোর চেষ্টা করা হয়। যেমন, কোনো নেটওয়ার্কে সবচেয়ে কম খরচে ডেটা পাঠানোর পথ খোঁজার সময় প্রতি মোড়ে দাঁড়িয়ে সবচেয়ে ছোট রাস্তাটি বেছে নেওয়াই হলো Greedy লজিক। এটি অত্যন্ত দ্রুত কাজ করে, তবে সব ধরনের সমস্যায় এটি ১০০% সঠিক উত্তর নাও দিতে পারে।
- Dynamic Programming বা DP (ডাইনামিক প্রোগ্রামিং): এটি হলো একটি অত্যন্ত শক্তিশালী ও স্মার্ট ইঞ্জিনিয়ারিং প্যারাডাইম। যখন কোনো একটি বড় ও জটিল সমস্যাকে অনেকগুলো ছোট ছোট একই ধরনের সমস্যায় (Overlapping Subproblems) ভেঙে সমাধান করা যায়, তখন DP ব্যবহার করা হয়। এর মূল মন্ত্র হলো: "যে ক্যালকুলেশন আপনি একবার করেছেন, তা পুনরায় করবেন না।" ছোট সমস্যাগুলোর সমাধান মেমোরিতে একটি Array বা Map-এর ভেতর ধরে রাখা বা Caching (Memoization) করা হয়। পরবর্তীতে একই ক্যালকুলেশনের প্রয়োজন হলে প্রসেসরকে আবার হিসাব করতে না দিয়ে সরাসরি মেমোরি থেকে আগের রেজাল্টটি নিয়ে নেওয়া হয়। এর ফলে যে সমস্যার সমাধান করতে Brute Force-এ কয়েক হাজার বছর লেগে যেতে পারে, Dynamic Programming ব্যবহার করে তা মাত্র কয়েক সেকেন্ডে সমাধান করা সম্ভব হয়।
প্রোডাকশন ইঞ্জিনিয়ারিং এবং রিয়েল-ওয়ার্ল্ড ইউজ কেস
তাত্ত্বিক আলোচনার পর এবার আমরা দেখব কীভাবে এই Data Structure এবং Algorithm-এর জ্ঞান আমাদের প্রতিদিনের প্রোডাকশন ইঞ্জিনিয়ারিং এবং রিয়েল-ওয়ার্ল্ড সিস্টেমে সরাসরি প্রয়োগ করা হয়। আমরা দুটি অত্যন্ত গুরুত্বপূর্ণ প্রোডাকশন ইউজ কেস নিয়ে বিস্তারিত আলোচনা করব: Database Indexing এবং Caching Architecture।
প্রথমেই কথা বলা যাক ডেটাবেস ইনডেক্সিং বা Database Indexing নিয়ে। আপনি যখন একটি Relational Database যেমন MySQL বা PostgreSQL ব্যবহার করেন এবং সেখানে কোটি কোটি ইউজারের রেকর্ড থাকে, তখন SELECT * FROM users WHERE email = 'example@test.com' কুয়েরিটি কীভাবে মাত্র কয়েক মিলি-সেকেন্ডে উত্তর দেয়? আপনি যদি ইমেইল কলামের ওপর Index তৈরি না করে রাখেন, তবে ডেটাবেস ইঞ্জিনকে Hard Disk বা SSD থেকে প্রতিটি রো বা রেকর্ড একে একে মেমোরিতে এনে পরীক্ষা করতে হবে। একে বলা হয় Full Table Scan। ট্রাফিক বেশি থাকা অবস্থায় এক কোটি রেকর্ডের ওপর Full Table Scan চললে সার্ভারের প্রসেসর এবং মেমোরি মুহূর্তেই ওভারলোড হয়ে পুরো ডেটাবেস ক্র্যাশ করবে।
এই সমস্যা সমাধানের জন্য ডেটাবেস ইঞ্জিনগুলো B-Tree এবং B+ Tree নামক বিশেষ Balanced Tree Data Structure ব্যবহার করে। যখন আপনি কোনো কলামের ওপর Index তৈরি করেন, তখন ডেটাবেস সেই কলামের ডেটাগুলোকে একটি B+ Tree আকারে সাজিয়ে মেমোরি বা ডিস্কের একটি আলাদা স্থানে সংরক্ষণ করে। B+ Tree-এর বৈশিষ্ট্য হলো এর প্রতিটি Node-এ অনেকগুলো করে ডেটা এবং Child Pointer থাকতে পারে, যা Tree-এর উচ্চতাকে অত্যন্ত কম রাখে। ফলে কোটি কোটি রেকর্ডের ভেতর থেকেও যেকোনো ডেটা খুঁজে বের করতে ডেটাবেসকে মাত্র ৩ থেকে ৪টি ডিস্ক রিড (Disk Read) অপারেশন করতে হয়, যা লজিক্যালি O(log n) পারফরম্যান্স নিশ্চিত করে।
আমাদের দ্বিতীয় প্রোডাকশন ইউজ কেসটি হলো Caching Architecture। যেকোনো হাই-ট্রাফিক স্কেলেবল সিস্টেমে ডেটাবেসের ওপর লোড কমানোর জন্য এবং ইউজারকে অতি দ্রুত রেসপন্স দেওয়ার জন্য আমরা Cache Memory (যেমন Redis বা Memcached) ব্যবহার করি। কিন্তু মেমোরি বা RAM-এর জায়গা অত্যন্ত সীমিত ও ব্যয়বহুল। তাই আমাদের এমন একটি স্মার্ট Cache সিস্টেম তৈরি করতে হয়, যা সবচেয়ে প্রয়োজনীয় ডেটাগুলো মেমোরিতে রাখবে এবং মেমোরি ভরে গেলে অপ্রয়োজনীয় বা পুরোনো ডেটাগুলো স্বয়ংক্রিয়ভাবে মুছে ফেলবে। এই কাজের জন্য ইন্ডাস্ট্রির সবচেয়ে জনপ্রিয় অ্যালগরিদম হলো LRU Cache (Least Recently Used)।
একটি প্রোডাকশন-গ্রেড LRU Cache তৈরি করতে হলে আমাদের এমন একটি আর্কিটেকচার প্রয়োজন যেখানে দুটি কাজই O(1) বা Constant Time-এ হতে হবে:
- যেকোনো Key দিয়ে ডেটা খুঁজে বের করা (Lookup)।
- কোনো নতুন ডেটা আসলে বা পুরোনো ডেটা মুছে ফেলার সময় মেমোরি আপডেট করা (Eviction & Insertion)।
শুধুমাত্র Array বা Linked List দিয়ে এটি করা সম্ভব নয়। তাই ইঞ্জিনিয়াররা এখানে একটি অসাধারণ কম্বিনেশন ব্যবহার করেন: Hash Map এবং Doubly Linked List। Hash Map আমাদের O(1) সময়ে ডেটা খুঁজে বের করার নিশ্চয়তা দেয়, আর Doubly Linked List আমাদের O(1) সময়ে যেকোনো অবস্থান থেকে Node মুছে ফেলার এবং নতুন Node যুক্ত করার সুবিধা দেয়।
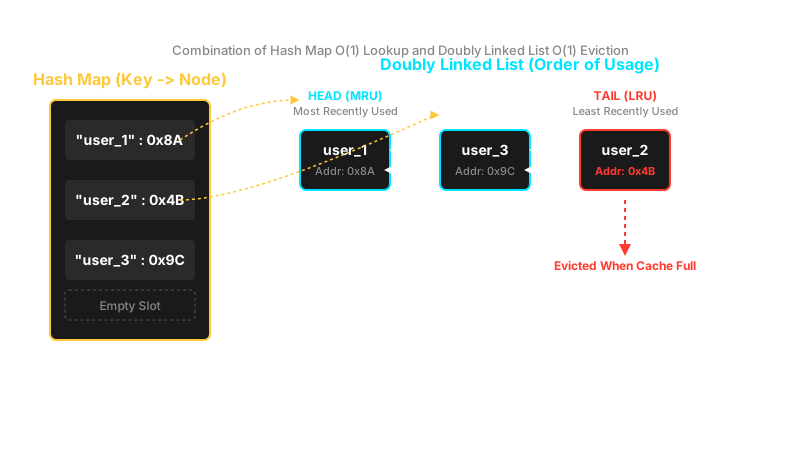
উপরের ডায়াগ্রামটি লক্ষ্য করুন। এখানে Hash Map-এর প্রতিটি Key সরাসরি Doubly Linked List-এর একটি নির্দিষ্ট Node-এর মেমোরি অ্যাড্রেস বা Pointer ধারণ করে আছে। যখনই কোনো ডেটা Read বা Write করা হয়, তখন সেই Node-টিকে Doubly Linked List-এর একদম শুরুতে বা Head-এ নিয়ে আসা হয় (Most Recently Used)। আর যখন মেমোরি পূর্ণ হয়ে যায়, তখন একদম শেষে বা Tail-এ থাকা Node-টিকে (Least Recently Used) মাত্র O(1) সময়ে কেটে বাদ দিয়ে দেওয়া হয়।
নিচে একটি প্রোডাকশন-রেডি, সম্পূর্ণ টাইপ-সেফ TypeScript কোড ব্লক দেওয়া হলো, যেখানে Hash Map এবং Doubly Linked List ব্যবহার করে একটি কার্যকরী LRU Cache ইমপ্লিমেন্ট করে দেখানো হয়েছে:
// Doubly Linked List-এর প্রতিটি Node-এর আর্কিটেকচারclass CacheNode<K, V> {    public key: K;    public value: V;    public prev: CacheNode<K, V> | null = null;    public next: CacheNode<K, V> | null = null;
    constructor(key: K, value: V) {        this.key = key;        this.value = value;    }}
// কমপ্লিট LRU Cache ইমপ্লিমেন্টেশনexport class LRUCache<K, V> {    private capacity: number;    private cacheMap: Map<K, CacheNode<K, V>>;    private head: CacheNode<K, V>;    private tail: CacheNode<K, V>;
    constructor(capacity: number) {        this.capacity = capacity;        this.cacheMap = new Map();
        // ডামি Head এবং Tail নোড তৈরি করা হচ্ছে যাতে Edge Case হ্যান্ডেল করা সহজ হয়        this.head = new CacheNode<K, V>({} as K, {} as V);        this.tail = new CacheNode<K, V>({} as K, {} as V);        this.head.next = this.tail;        this.tail.prev = this.head;    }
    // যেকোনো Node-কে Linked List থেকে বিচ্ছিন্ন করার O(1) লজিক    private removeNode(node: CacheNode<K, V>): void {        const prevNode = node.prev;        const nextNode = node.next;
        if (prevNode && nextNode) {            prevNode.next = nextNode;            nextNode.prev = prevNode;        }    }
    // যেকোনো Node-কে Linked List-এর একদম শুরুতে (Head-এর পরে) যুক্ত করার O(1) লজিক    private addToHead(node: CacheNode<K, V>): void {        node.prev = this.head;        node.next = this.head.next;
        if (this.head.next) {            this.head.next.prev = node;        }        this.head.next = node;    }
    // ডেটা পড়ার ও(1) মেথড    public get(key: K): V | null {        if (!this.cacheMap.has(key)) {            return null;        }
        const node = this.cacheMap.get(key)!;        // যেহেতু ডেটাটি এইমাত্র ব্যবহার হলো, তাই এটিকে সরিয়ে Head-এ নিয়ে আসা হচ্ছে        this.removeNode(node);        this.addToHead(node);
        return node.value;    }
    // ডেটা লেখার ও(1) মেথড    public put(key: K, value: V): void {        if (this.cacheMap.has(key)) {            // ডেটা আগে থেকেই থাকলে ভ্যালু আপডেট করে Head-এ নিয়ে আসা হচ্ছে            const existingNode = this.cacheMap.get(key)!;            existingNode.value = value;            this.removeNode(existingNode);            this.addToHead(existingNode);        } else {            // নতুন ডেটার জন্য নতুন Node তৈরি করা হচ্ছে            const newNode = new CacheNode(key, value);            this.cacheMap.set(key, newNode);            this.addToHead(newNode);
            // ক্যাপাসিটি অতিক্রম করলে সবচেয়ে পুরোনো ডেটা (Tail-এর আগের Node) মুছে ফেলা হচ্ছে            if (this.cacheMap.size > this.capacity) {                const lruNode = this.tail.prev;                if (lruNode && lruNode !== this.head) {                    this.removeNode(lruNode);                    this.cacheMap.delete(lruNode.key);                }            }        }    }}
// প্রোডাকশন টেস্ট এক্সিকিউশনconst userCache = new LRUCache<string, string>(2);userCache.put("user_1", "Alice Profile");userCache.put("user_2", "Bob Profile");
console.log(userCache.get("user_1")); // Alice Profile (user_1 এখন Most Recently Used)
// নতুন ডেটা ঢোকানোর ফলে ক্যাপাসিটি পূর্ণ হয়ে যাবে এবং user_2 (Least Recently Used) মেমোরি থেকে মুছে যাবেuserCache.put("user_3", "Charlie Profile");console.log(userCache.get("user_2")); // null (ডেটাটি Cache থেকে Evicted হয়ে গেছে)
রিক্যাপ এবং প্রোডাকশন চেকলিস্ট
আমাদের এই দীর্ঘ এবং গভীর আলোচনার মাধ্যমে আমরা একটি বিষয় অত্যন্ত স্পষ্টভাবে বুঝতে পেরেছি: একজন জুনিয়র ডেভেলপার থেকে একজন দক্ষ সিস্টেম আর্কিটেক্ট হওয়ার মূল পার্থক্যটি লুকিয়ে আছে চিন্তার গভীরতায়। জুনিয়র ডেভেলপাররা চিন্তা করেন কোডটি কীভাবে কাজ করবে এবং আউটপুট দেবে। আর একজন আর্কিটেক্ট চিন্তা করেন কোডটি যখন এক লাখ বা এক কোটি বার এক্সিকিউট হবে, তখন মেমোরি লেআউট কেমন হবে, নেটওয়ার্ক লেটেন্সি কত হবে, এবং প্রসেসরের ওপর কতটুকু চাপ পড়বে। Data Structure এবং Algorithm শুধুমাত্র চাকরির ইন্টারভিউ পাশ করার কোনো তাত্ত্বিক বিষয় নয়; এটি হলো আপনার সফটওয়্যার ইঞ্জিনিয়ারিং ক্যারিয়ারের সবচেয়ে শক্তিশালী ভিত্তি, যা আপনাকে স্কেলেবল, দ্রুতগতির এবং নির্ভরযোগ্য প্রোডাকশন সিস্টেম তৈরি করার ক্ষমতা প্রদান করে।
ভবিষ্যতে যখনই আপনি কোনো নতুন সিস্টেমের আর্কিটেকচার ডিজাইন করবেন বা কোনো জটিল প্রবলেম সলভ করবেন, তখন সিদ্ধান্ত নেওয়ার জন্য নিচের ডেভেলপার ডিসিশন চেকলিস্টটি সবসময় মনে রাখবেন:
- Array ব্যবহার করবেন যখন: আপনার ডেটার আকার আগে থেকেই নির্দিষ্ট থাকে, মেমোরি ব্যবহারের ক্ষেত্রে সর্বোচ্চ অপটিমাইজেশন প্রয়োজন হয়, এবং ইনডেক্স নম্বর ধরে বারবার ডেটা পড়ার (O(1) Lookup) প্রয়োজন সবচেয়ে বেশি থাকে।
- Linked List ব্যবহার করবেন যখন: আপনার সিস্টেমে প্রতিনিয়ত ডেটার আকার পরিবর্তিত হয়, এবং তালিকার মাঝখান থেকে বা শুরু থেকে দ্রুত ডেটা ইনসার্ট বা ডিলিট করার প্রয়োজন হয়।
- Hash Table / Map ব্যবহার করবেন যখন: যেকোনো বিশাল ডেটাসেট থেকে কোনো একটি নির্দিষ্ট Key বা চাবি ধরে একদম মিলি-সেকেন্ডে বা O(1) সময়ে ডেটা খুঁজে বের করার প্রয়োজন হয়।
- Tree / Binary Search Tree (BST) ব্যবহার করবেন যখন: ডেটার মধ্যে হায়েরার্কি বা ক্রমানুসারে সম্পর্ক বজায় রাখতে হয়, এবং সর্টেড ডেটার ওপর দ্রুত Range Query বা সার্চ চালানোর প্রয়োজন হয়।
- Graph ব্যবহার করবেন যখন: বাস্তব পৃথিবীর কোনো নেটওয়ার্ক, সোশ্যাল মিডিয়া কানেকশন, রাস্তাঘাটের ম্যাপ বা জটিল রুট ক্যালকুলেশনের লজিক ইমপ্লিমেন্ট করতে হয়।
- Queue ব্যবহার করবেন when: আপনার সিস্টেমে আসা হাজার হাজার Request বা Background Job-কে সিরিয়াল অনুযায়ী বা FIFO (First In, First Out) পদ্ধতিতে একে একে প্রসেস করার প্রয়োজন হয়।
- Stack ব্যবহার করবেন যখন: আপনার লজিকে LIFO (Last In, First Out) আর্কিটেকচার প্রয়োজন হয়, যেমন হিস্ট্রি ট্র্যাকিং, সিনট্যাক্স পার্সিং, বা Undo-Redo মেকানিজম তৈরি করা।
আপনার ইঞ্জিনিয়ারিং যাত্রা শুভ হোক। সঠিক আর্কিটেকচারাল সিদ্ধান্তের মাধ্যমে আপনার তৈরি প্রতিটি সিস্টেম হয়ে উঠুক প্রোডাকশন-রেডি এবং হাইলি স্কেলেবল।