Deep Dive: গবেষণা গুগলের, বাজিমাৎ ওপেনআই-এর - জেনারেটিভ এআই-এর আন্ডার-দ্য-হুড আর্কিটেকচার
On this page
সাধারণ প্রযুক্তি ব্যবহারকারী থেকে শুরু করে অনেক জুনিয়র সফটওয়্যার ইঞ্জিনিয়ারদের মধ্যেও একটি সাধারণ ধারণা রয়েছে যে, আজকের Generative AI বা Large Language Model (LLM) বিপ্লবের সম্পূর্ণ কৃতিত্ব OpenAI-এর। আমরা যখন ChatGPT, Claude কিংবা Gemini-এর মতো শক্তিশালী মডেলগুলোর সাথে কথা বলি, তখন মনে হয় এই প্রযুক্তির জন্ম হয়েছে ওপেনআই-এর নিজস্ব ল্যাবে। কিন্তু আপনি যদি এই প্রযুক্তির Under-the-hood আর্কিটেকচারে প্রবেশ করেন, তবে দেখতে পাবেন এর পেছনের আসল কারিগর আসলে অন্য কেউ। এই পুরো রেভোলিউশনের মূল মেরুদণ্ড লুকিয়ে আছে ২০১৭ সালে প্রকাশিত গুগলের একটি ঐতিহাসিক Research Paper-এর মধ্যে।
আজকের এই ডিপ-ডাইভ সেশনে আমরা বিশ্লেষণ করব কীভাবে গুগলের আবিষ্কার করা একটি যুগান্তকারী আর্কিটেকচার প্রযুক্তি দুনিয়ার হিসাব-নিকাশ বদলে দিল, কেন গুগল নিজে ফার্স্ট-মুভার অ্যাডভান্টেজ নিতে ব্যর্থ হলো, এবং কীভাবে OpenAI সেই ওপেন-সোর্স প্রযুক্তি ব্যবহার করে টেক দুনিয়ার সবচেয়ে বড় ভ্যালু ক্যাপচার বা আইডিয়া হাইজ্যাক সম্পন্ন করল। এই আর্টিকেলের শেষে আপনার জন্য সকল অরিজিনাল রিসার্চ পেপার এবং টেকনিক্যাল ডকুমেন্টেশনের রেফারেন্স লিংক যুক্ত করে দেওয়া হয়েছে।
ইন্ট্রোডাকশন: টেক দুনিয়ার সেই ঐতিহাসিক মোড়
২০১৭ সালের মাঝামাঝি সময়। গুগলের ব্রেইন টিম এবং গুগল রিসার্চের আটজন বিজ্ঞানী মিলে একটি গবেষণাপত্র প্রকাশ করলেন, যার শিরোনাম ছিল Attention Is All You Need। সেই সময়ে এই পেপারটি একাডেমিক মহলে বেশ সাড়া ফেললেও সাধারণ টেক ইন্ডাস্ট্রিতে এটি যে কত বড় ভূমিকম্প তৈরি করতে যাচ্ছে, তা অনেকে অনুমান করতে পারেননি।
এই গবেষণাপত্রেই বিশ্ব প্রথমবারের মতো পরিচিত হয় Transformer Architecture-এর সাথে। আপনি আজকে যে চ্যাটজিপিটি ব্যবহার করছেন, তার নামের শেষের "T" অক্ষরটি কিন্তু এই Transformer-কে নির্দেশ করে (Generative Pre-trained Transformer)। অর্থাৎ, চ্যাটজিপিটি যে কোর ইঞ্জিনের ওপর ভর করে আপনার জটিল কোড ডিবাগ করছে বা ন্যাচারাল ল্যাঙ্গুয়েজে উত্তর দিচ্ছে, সেই ইঞ্জিনটি সম্পূর্ণ গুগলের ল্যাবে তৈরি। গুগল তাদের এই যুগান্তকারী আবিষ্কারকে নিজেদের মধ্যে কুক্ষিগত না রেখে ডেভলপার কমিউনিটির জন্য ওপেন-সোর্স করে দেয়, আর ঠিক এই পয়েন্ট থেকেই শুরু হয় টেক ইতিহাসের অন্যতম বড় স্ট্র্যাটেজিক শিফট।
ফাউন্ডেশনাল মেন্টাল মডেল এবং অ্যানালজি
টেকনিক্যাল আর্কিটেকচারে প্রবেশের আগে পুরো ঘটনাটিকে একটি বাস্তব জীবনের Analogy দিয়ে বোঝার চেষ্টা করা যাক। ধরুন, একটি অত্যন্ত সুপরিচিত এবং বিশ্বসেরা রেস্তোরাঁ চেইন (Google) তাদের নিজস্ব ল্যাবে বছরের পর বছর গবেষণা করে সম্পূর্ণ নতুন এবং অসাধারণ স্বাদের একটি বিরিয়ানির রেসিপি (Transformer Architecture) আবিষ্কার করল। এই রেসিপিটি এতটাই উন্নত ছিল যে খুব কম খরচে এবং দ্রুততম সময়ে লাখ লাখ মানুষের জন্য খাবার তৈরি করা সম্ভব।
কিন্তু সেই রেস্তোরাঁ চেইনটি তাদের নিজস্ব নিয়মিত খাবারের মান নষ্ট হওয়ার ভয়ে এবং ব্যবসায়িক ঝুঁকির কারণে নতুন রেসিপিটি নিজেদের মেন্যুতে যুক্ত করতে গড়িমসি করছিল। এর পরিবর্তে তারা রেসিপিটি একটি উন্মুক্ত রান্নার বইয়ে প্রকাশ করে দিল, যেন দুনিয়ার যে কেউ এটি দেখতে পায়।
ঠিক তখনই একটি ছোট কিন্তু অত্যন্ত উচ্চাকাঙ্ক্ষী ক্যাটারিং স্টার্টআপ (OpenAI) সেই উন্মুক্ত রেসিপিটি সংগ্রহ করল। তারা বুঝতে পারল, রেসিপিটি সাধারণ হলেও এর আসল ম্যাজিক লুকিয়ে আছে বিশাল আকারের রান্নাঘর (Supercomputing Power) এবং বিপুল পরিমাণ কাঁচামালের (Big Data) ব্যবহারে। তারা দ্রুত বিশাল ইনফ্রাস্ট্রাকচার তৈরি করে সেই রেসিপি দিয়ে সুস্বাদু বিরিয়ানি রান্না করে সরাসরি কাস্টমারদের টেবিলে পরিবেশন (ChatGPT Launch) করা শুরু করল। কাস্টমাররা খাবারের স্বাদে মুগ্ধ হয়ে মনে করল এই অসাধারণ রেসিপি এবং রান্নার পুরো কৃতিত্বই সেই নতুন স্টার্টআপের। বাস্তবে রেসিপিটি ছিল গুগলের, কিন্তু সঠিক সময়ে স্কেল করে এক্সিকিউশন করার মাধ্যমে বাজার দখল করে নিল ওপেনআই।
আন্ডার-দ্য-হুড আর্কিটেকচার: কী ছিল সেই "Transformer" প্রযুক্তিতে?
কেন গুগলের এই আবিষ্কার এত গুরুত্বপূর্ণ ছিল? এটি বোঝার জন্য আমাদের দেখতে হবে ট্রান্সফরমার আসার আগে এআই মডেলগুলো কীভাবে কাজ করত। ২০১৭ সালের আগে ন্যাচারাল ল্যাঙ্গুয়েজ প্রসেসিং বা NLP-এর জন্য মূলত ব্যবহার করা হতো RNN (Recurrent Neural Networks) এবং LSTM (Long Short-Term Memory) আর্কিটেকচার।
পুরানো এই RNN মডেলগুলোর সবচেয়ে বড় সীমাবদ্ধতা ছিল Sequential Processing বা ধাপে ধাপে ডাটা প্রসেস করা। আপনি যদি একটি ২০ শব্দের বাক্য ইনপুট দেন, তবে রিকারেন্ট নেটওয়ার্ক প্রথম শব্দ থেকে শুরু করে একে একে শেষ শব্দ পর্যন্ত যেত। এই প্রক্রিয়ায় দুটি বড় ইঞ্জিনিয়ারিং বটলনেক তৈরি হতো:
প্রথমত, এটি ছিল অত্যন্ত স্লো। যেহেতু প্রতিটি টোকেন তার আগের টোকেনের প্রসেসিং শেষ হওয়ার ওপর নির্ভর করত, তাই এখানে GPU-এর প্যারালাল প্রসেসিং পাওয়ার ব্যবহার করা যেত না। এর Time Complexity এবং মেমোরি বটলনেক ছিল মারাত্মক। দ্বিতীয়ত, বাক্যের দৈর্ঘ্য বড় হলেই মডেলটি আগের শব্দের রেফারেন্স বা Long-term Context ভুলে যেত, যাকে বলা হয় Vanishing Gradient সমস্যা।
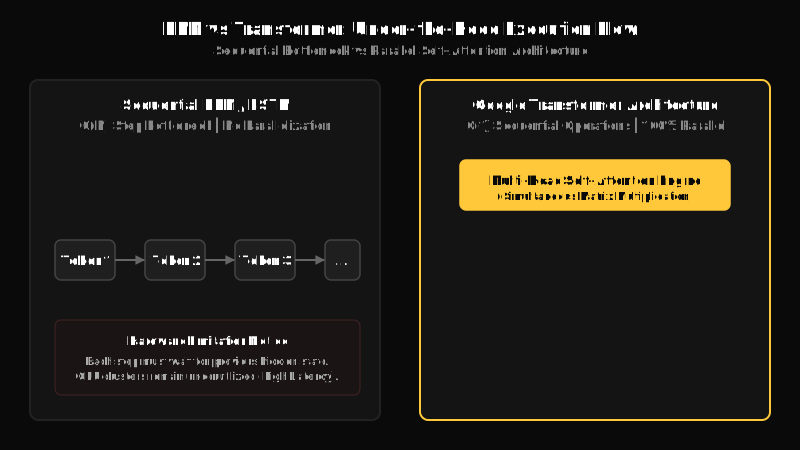
গুগলের বিজ্ঞানীরা এই সমস্যার সমাধানে নিয়ে এলেন Self-Attention Mechanism। রিকারেন্ট নেটওয়ার্কের মতো একটার পর একটা শব্দ প্রসেস না করে, ট্রান্সফরমার আর্কিটেকচার পুরো বাক্যের সবগুলি শব্দকে একই সাথে (Parallel Processing) মেমোরিতে লোড করে। সেলফ-অ্যাটেনশন মেকানিজম একটি বাক্যের প্রতিটি শব্দের সাথে অন্য প্রতিটি শব্দের সম্পর্ক বা Attention Weight গাণিতিকভাবে হিসাব করে নেয়।
উদাহরণস্বরূপ, "সার্ভারটি ক্র্যাশ করেছে কারণ এটি ওভারলোডেড ছিল" এই বাক্যে "এটি" শব্দটি যে আসলে "সার্ভারটি"-কে নির্দেশ করছে, রিকারেন্ট নেটওয়ার্ক তা বুঝতে হিমশিম খেত। কিন্তু গুগলের সেলফ-অ্যাটেনশন মেকানিজম হাই-ডাইমেনশনাল ভেক্টর স্পেসের মাধ্যমে চোখের পলকে এই সম্পর্ক ম্যাপ করে ফেলতে পারে। এর ফলে প্রসেসিং স্পিড বহুগুণ বেড়ে যায় এবং আধুনিক GPU বা TPU ক্লাস্টারে একে স্কেল করা অবিশ্বাস্য রকমের সহজ হয়ে ওঠে। এই বিষয়ে আরও বিস্তারিত জানা যাবে গুগলের অরিজিনাল Google Research Blog Post থেকে।
স্টেপ-বাই-স্টেপ এক্সিকিউশন ট্রেস এবং কোড মেকানিজম
আপনি যখন চ্যাটজিপিটি বা জেমিনিতে একটি প্রম্পট দেন, তখন আন্ডার-দ্য-হুড কীভাবে এই ডাটা ফ্লো কাজ করে, তা একটি এক্সিকিউশন ট্রেস দিয়ে বোঝা যাক। আমরা যদি ইঞ্জিনের ভেতরের মেমোরি লেআউট এবং পাইপলাইন ট্রেস করি, তবে নিচের ধাপগুলো দেখতে পাব:
ধাপ ১ - Tokenization: আপনার ইনপুট টেক্সটটি প্রথমে ছোট ছোট টুকরো বা টোকেনে বিভক্ত হয়। প্রতিটি টোকেন একটি নির্দিষ্ট নিউম্যারিক আইডিতে রূপান্তর হয়।
ধাপ ২ - Embedding & Positional Encoding: যেহেতু ট্রান্সফরমার আর্কিটেকচার সব শব্দ একসাথে প্যারালালি প্রসেস করে, তাই শব্দের ক্রম বা অর্ডারিং মনে রাখার জন্য গুগলের বিজ্ঞানীরা Positional Encoding ব্যবহার করেন। প্রতিটি টোকেনের এমবেডিং ভেক্টরের সাথে তার অবস্থানের একটি গাণিতিক সিগনেচার যুক্ত করে হাই-ডাইমেনশনাল ভেক্টর তৈরি করা হয়।
ধাপ ৩ - Multi-Head Self-Attention: এটিই গুগলের মূল ম্যাজিক ব্লক। এখানে প্রতিটি টোকেনের জন্য তিনটি ভেক্টর তৈরি হয়: Query (Q), Key (K), এবং Value (V)। এই ভেক্টরগুলোর Matrix Multiplication-এর মাধ্যমে মডেল হিসাব করে কোন টোকেনের প্রতি কতটুকু গুরুত্ব বা অ্যাটেনশন দিতে হবে। একাধিক অ্যাটেনশন হেড প্যারালালি কাজ করে বাক্যের সিনট্যাক্স, গ্রামার এবং কনটেক্সট আলাদাভাবে ক্যাপচার করে।
ধাপ ৪ - Feed-Forward Network & Normalization: অ্যাটেনশন ব্লক থেকে পাওয়া ডাটা প্রতিটি লেয়ারে Feed-Forward Neural Network এবং Layer Normalization-এর মধ্য দিয়ে গিয়ে আরও রিফাইন হয়।
ধাপ ৫ - Output Generation (Softmax): সবশেষে, মডেলটি তার ভোকাবুলারির সমস্ত টোকেনের ওপর একটি Probability Distribution তৈরি করে এবং পরবর্তী সবচেয়ে সম্ভাব্য টোকেনটি প্রেডিক্ট করে। এই পুরো সাইকেলটি প্রতি মিলি-সেকেন্ডে হাজার হাজার বার লুপ করে আপনার স্ক্রিনে উত্তর জেনারেট করে।
গুগলের ভুল নাকি অতিরিক্ত সতর্কতা?
এখন সবচেয়ে বড় প্রশ্ন হলো, যে প্রযুক্তি গুগল নিজে আবিষ্কার করল, সেটি দিয়ে কেন তারা চ্যাটজিপিটির মতো কোনো প্রোডাক্ট সবার আগে বাজারে ছাড়তে পারল না? এটি কি তাদের ইঞ্জিনিয়ারিং ব্যর্থতা ছিল? মোটেই না। এটি ছিল মূলত কর্পোরেট কালচার এবং বিজনেস মডেলের কনফ্লিক্ট।
প্রথম কারণ ছিল রেপুটেশন রিস্ক এবং হ্যালুসিনেশন ভীতি। একটি মাল্টি-বিলিয়ন ডলারের পাবলিক কোম্পানি হিসেবে গুগলের বিশ্বজুড়ে বিশাল বিশ্বাসযোগ্যতা রয়েছে। এই লার্জ ল্যাঙ্গুয়েজ মডেলগুলোর একটি বড় সমস্যা হলো Hallucination বা অত্যন্ত আত্মবিশ্বাসের সাথে ভুল তথ্য প্রদান করা। গুগলের লিডারশিপ ভয় পাচ্ছিল যে, যদি তারা একটি অপূর্ণাঙ্গ চ্যাটবট পাবলিকলি রিলিজ করে এবং সেটি ভুল বা বায়াসড উত্তর দেয়, তবে গুগলের সার্চ ইঞ্জিনের বিশ্বাসযোগ্যতা মারাত্মকভাবে ক্ষুণ্ন হবে।
দ্বিতীয় এবং সবচেয়ে বড় কারণ ছিল Innovator's Dilemma বা বিজনেস মডেল ক্যানিবালাইজেশন। গুগলের মূল আয় আসে তাদের সার্চ ইঞ্জিন এবং অ্যাডভার্টাইজমেন্ট ব্যবসা থেকে। আপনি যখন গুগলে কিছু সার্চ করেন, তখন আপনাকে বিভিন্ন ওয়েবসাইটের লিংক দেখানো হয় এবং সেই সাথে বিজ্ঞাপন প্রদর্শিত হয়। এখন গুগল যদি এমন একটি চ্যাটবট এনে দেয় যা সরাসরি আপনার প্রশ্নের উত্তর দিয়ে দেবে, তবে ইউজাররা আর লিঙ্কে ক্লিক করবে না বা বিজ্ঞাপন দেখবে না। নিজেদের শত কোটি ডলারের বিজ্ঞাপন ব্যবসাকে নিজেদের হাতেই ধ্বংস করার ঝুঁকিতে যেতে গুগল অত্যন্ত দ্বিধাগ্রস্ত ছিল।
ওপেনআই-এর এন্ট্রি এবং মাস্টারস্ট্রোক
গুগল যখন তাদের ল্যাবে বসে মডেলের সেফটি এবং রেভিনিউ মডেল নিয়ে অতিরিক্ত বিশ্লেষণে ব্যস্ত ছিল, ঠিক তখনই মাঠে নামে OpenAI। তারা গুগলের এই ওপেন-সোর্স ট্রান্সফরমার আর্কিটেকচারের সত্যিকারের পটেনশিয়াল বুঝতে পেরেছিল। ওপেনআই একটি সহজ সূত্রে বিশ্বাস করেছিল যাকে বলা হয় Scaling Laws। তারা বুঝতে পেরেছিল, এই ট্রান্সফরমার মডেলের প্যারামিটার এবং ট্রেনিং ডাটা যদি এক্সপোনেনশিয়ালি বাড়ানো যায়, তবে মডেলের মধ্যে স্বয়ংক্রিয়ভাবে অসাধারণ সব লজিক্যাল এবং রিজনিং ক্ষমতা তৈরি হবে।
তারা একে একে প্রকাশ করল GPT-1 Technical Paper (2018) (১১৭ মিলিয়ন প্যারামিটার), GPT-2 (১.৫ বিলিয়ন প্যারামিটার), এবং ঐতিহাসিক GPT-3 Technical Paper (2020) (১৭৫ বিলিয়ন প্যারামিটার)। কিন্তু ওপেনআই-এর আসল মাস্টারস্ট্রোক শুধু মডেল তৈরিতে ছিল না, তাদের মাস্টারস্ট্রোক ছিল প্রোডাক্ট ডেলিভারি এবং ইউজার ইন্টারফেস ডিজাইনে।
২০২২ সালের নভেম্বরে তারা যখন ChatGPT রিলিজ করে, তখন তারা কোনো জটিল API বা টেকনিক্যাল কনসোল দেয়নি। তারা সাধারণ মানুষের জন্য অত্যন্ত পরিচিত এবং সহজ একটি চ্যাট ইন্টারফেস উন্মুক্ত করে দেয়। যে কেউ কোনো টেকনিক্যাল জ্ঞান ছাড়াই এর সাথে কথা বলতে পারত। এই একটি পদক্ষেপেই তারা পুরো সিলিকন ভ্যালিকে চমকে দিয়ে ফার্স্ট-মুভার অ্যাডভান্টেজ দখল করে নেয়।
Important
UI/UX এবং অ্যাক্সেসিবিলিটি অ্যাডভান্টেজ: প্রযুক্তি বা কোর ইনফ্রাস্ট্রাকচার আন্ডার-দ্য-হুড যতই শক্তিশালী হোক না কেন, এন্ড-ইউজারের জন্য যদি একটি সিম্পল এবং স্বজ্ঞাত ইন্টারফেস তৈরি করা না যায়, তবে সেই প্রযুক্তি ম্যাস-অ্যাদপশন পায় না। চ্যাটজিপিটি-এর ইন্টারফেসের সরলতাই ছিল এর এক্সপোনেনশিয়াল গ্রোথের অন্যতম বড় চাবিকাঠি।
এটি কি চুরি, নাকি ওপেন-সোর্সের নিয়ম?
সাধারণ মানুষের মনে প্রশ্ন জাগতে পারে, গুগলের আবিষ্কার করা প্রযুক্তি দিয়ে ওপেনআই ব্যবসা করছে, এটিকে কি আইনি ভাষায় "চুরি" বলা যায়? এর উত্তর হলো, আইনি দৃষ্টিকোণ থেকে এটিকে কোনোভাবেই চুরি বলা যাবে না।
গুগল তাদের "Attention Is All You Need" পেপারের সাথে যে কোড এবং আর্কিটেকচার প্রকাশ করেছিল, তা ওপেন-সোর্স লাইসেন্সের আওতায় ছিল। ওপেন-সোর্স সংস্কৃতির মূল নিয়মই হলো, যে কেউ এই প্রযুক্তি ব্যবহার করতে পারবে, মডিফাই করতে পারবে, এবং চাইলে তা দিয়ে বাণিজ্যিক প্রোডাক্টও তৈরি করতে পারবে। ওপেনআই ঠিক সেই আইনি এবং ওপেন-সোর্স নিয়মের মধ্য থেকেই কাজ করেছে।
তবে ব্যবসায়িক এবং কৌশলগত দৃষ্টিকোণ থেকে এটিকে টেক ইতিহাসের অন্যতম বড় "আইডিয়া হাইজ্যাক" বা "Value Capture Failure" বলা হয়। গবেষণা ও উদ্ভাবনের পেছনে কোটি কোটি ডলার এবং বছরের পর বছর সময় ব্যয় করল গুগলের বিজ্ঞানী দল, আর সেই প্রযুক্তির চূড়ান্ত বাণিজ্যিক সুবিধা এবং মার্কেট লিডারশিপ নিয়ে গেল তুলনামূলকভাবে একটি ছোট স্টার্টআপ।
এই ঘটনার আরও একটি বড় ট্র্যাজেডি হলো Talent Drain। গুগলের যে আটজন বিজ্ঞানী এই ঐতিহাসিক ট্রান্সফরমার পেপারটি লিখেছিলেন, চ্যাটজিপিটি রিলিজ হওয়ার পরবর্তী কয়েক বছরের মধ্যে তাদের সবাই গুগল ছেড়ে চলে যান। তারা গুগলের ধীরগতির কর্পোরেট সিদ্ধান্তে হতাশ হয়ে নিজেরা আলাদা এআই স্টার্টআপ প্রতিষ্ঠা করেন। যেমন, Ashish Vaswani এবং Niki Parmar মিলে প্রতিষ্ঠা করেন Essential AI, Aidan Gomez প্রতিষ্ঠা করেন বর্তমানের অন্যতম সফল এআই কোম্পানি Cohere, এবং Noam Shazeer প্রতিষ্ঠা করেন Character.ai যা পরবর্তীতে আবার গুগল তাদের ইকোসিস্টেমে ফিরিয়ে আনে।
গুগলের প্যানিক মোড এবং বর্তমান এআই যুদ্ধ
চ্যাটজিপিটি লঞ্চ হওয়ার মাত্র কয়েক সপ্তাহের মধ্যে এটি ইতিহাসের দ্রুততম ১ মিলিয়ন এবং পরবর্তীতে ১০০ মিলিয়ন অ্যাক্টিভ ইউজারে পৌঁছানোর রেকর্ড গড়ে। এই অভূতপূর্ব সাফল্যে গুগলের হেডকোয়ার্টারে নড়েচড়ে বসে লিডারশিপ। গুগলের সিইও সুন্দর পিচাই কোম্পানির ভেতরে "Code Red" বা সর্বোচ্চ জরুরি অবস্থা জারি করেন। গুগলের প্রতিষ্ঠাতা ল্যারি পেজ এবং সের্গেই ব্রিন অবসর ভেঙে আবার ল্যাবে ফিরে আসেন।
গুগল বুঝতে পারে তারা রেসে অনেক পিছিয়ে পড়েছে। তড়িঘড়ি করে ২০২৩ সালের শুরুতে তারা বাজারে রিলিজ করে তাদের প্রথম চ্যাটবট "Bard"। কিন্তু তাড়াহুড়ো করে রিলিজ করার কারণে লঞ্চ ইভেন্টেই Bard জেমস ওয়েব স্পেস টেলিস্কোপ নিয়ে একটি ভুল উত্তর দিয়ে বসে, যার ফলে একদিনেই গুগলের শেয়ার বাজার থেকে ১০০ বিলিয়ন ডলারের বেশি মার্কেট ভ্যালু মুছে যায়।
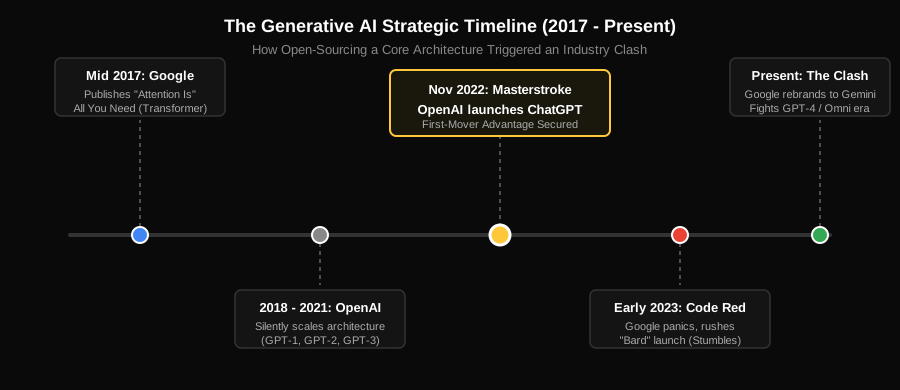
পরবর্তীতে গুগল তাদের ভুল বুঝতে পেরে নিজেদের পুরো এআই স্ট্র্যাটেজি ঢেলে সাজায়। তারা তাদের বিভিন্ন বিক্ষিপ্ত এআই টিমকে (Google Brain এবং DeepMind) একত্রিত করে তৈরি করে Google DeepMind। Bard-কে সম্পূর্ণ রিব্র্যান্ডিং করে প্রকাশ করা হয় Gemini Technical Architecture।
বর্তমানে গুগলের Gemini মডেলগুলো ওপেনআই-এর GPT-4 এবং Omni মডেলগুলোর সাথে সমানে সমানে পাল্লা দিচ্ছে। গুগলের সবচেয়ে বড় সুবিধা হলো তাদের বিশাল ডেটা ইকোসিস্টেম (YouTube, Search, Android) এবং নিজস্ব চিপ ইনফ্রাস্ট্রাকচার (TPU), যা দিয়ে তারা এখন হারানো মার্কেট শেয়ার পুনরুদ্ধার করার চেষ্টা চালিয়ে যাচ্ছে।
Warning
অ্যানালিসিস প্যারালাইসিস এবং মার্কেট টাইমিং: প্রোডাকশন সিস্টেমে ১০০% পারফেকশন এবং জিরো-রিস্ক নিশ্চিত করার অপেক্ষায় বসে থাকলে ফার্স্ট-মুভার অ্যাডভান্টেজ সম্পূর্ণ হাতছাড়া হয়ে যেতে পারে। সফটওয়্যার ইঞ্জিনিয়ারিংয়ে দ্রুত প্রোডাক্ট বাজারে ছেড়ে রিয়েল-ওয়ার্ল্ড ইউজার ফিডব্যাক লুপ তৈরি করা স্ট্যাটিক পারফেকশনের চেয়ে অনেক বেশি কার্যকর।
উপসংহার ও প্রোডাকশন ডিসিশন রুলস
গবেষণা গুগলের আর বাজিমাৎ ওপেনআই-এর - এই পুরো ঐতিহাসিক ঘটনাটি সফটওয়্যার ইঞ্জিনিয়ার, সিস্টেম আর্কিটেক্ট এবং টেকনোলজি লিডারদের জন্য অত্যন্ত গুরুত্বপূর্ণ কিছু শিক্ষা রেখে গেছে। প্রযুক্তি দুনিয়ায় শুধুমাত্র যুগান্তকারী আইডিয়া বা থিওরিটিক্যাল ইনোভেশন থাকা কখনোই সফলতার গ্যারান্টি দেয় না। সঠিক সময়ে সেই আইডিয়াকে স্কেল করা এবং ইউজার-ফ্রেন্ডলি প্রোডাক্টে রূপান্তর করাই আসল গেম চেঞ্জার।
একজন সফটওয়্যার আর্কিটেক্ট বা ডেভলপার হিসেবে আপনার দৈনন্দিন প্রজেক্ট এবং সিস্টেম ডিজাইনে এই ডিপ-ডাইভ থেকে নেওয়া নিচের তিনটি Production Decision Rules প্রয়োগ করতে পারেন:
১. ইকোসিস্টেম রেডিনেস নিশ্চিত করুন: আপনি যদি কোনো ইনোভেশন বা কোর লাইব্রেরি ওপেন-সোর্স করতে চান, তবে সেটি রিলিজ করার আগেই তার ওপর ভিত্তি করে বাণিজ্যিক প্রোডাক্ট বা ইকোসিস্টেম তৈরির প্রস্তুতি আপনার নিজের হাতে থাকতে হবে। অন্যথায় আপনার উদ্ভাবিত ভ্যালু অন্য কেউ ক্যাপচার করে নেবে।
২. আইডিয়েশন বনাম এক্সিকিউশন ব্যালেন্স: ইঞ্জিনিয়ারিংয়ে Over-engineering বা পারফেকশনের জন্য অনন্তকাল অপেক্ষা করবেন না। একটি Minimum Viable Product (MVP) বা বেসিক কিন্তু ফাংশনাল ভার্সন দ্রুত প্রোডাকশনে ডিপ্লয় করুন। ইউজার কীভাবে আপনার সিস্টেম ব্যবহার করছে, সেই রিয়েল-ওয়ার্ল্ড ডাটাই আপনাকে সঠিক আর্কিটেকচারাল রিফাইনেমেন্ট করতে সাহায্য করবে।
৩. অ্যাক্সেসিবিলিটি এবং ইউজার এক্সপেরিয়েন্সকে প্রাধান্য দিন: আপনার ব্যাকএন্ডের কোড যত পরিষ্কারই হোক বা ডাটাবেজ যত দ্রুতই কাজ করুক না কেন, এন্ড-ইউজার যদি একটি সহজ ইন্টারফেসের মাধ্যমে সেই ভ্যালু কনজিউম করতে না পারে, তবে পুরো সিস্টেমটি ব্যর্থ। ওপেনআই-এর মতো জটিল আন্ডার-দ্য-হুড আর্কিটেকচারকে সবসময় একটি সিম্পল এবং স্বজ্ঞাত ইন্টারফেসের পেছনে আবৃত রাখার চেষ্টা করুন।
রেফারেন্স এবং ফার্দার রিডিং (References & Further Reading)
আপনি যদি এই আর্কিটেকচার এবং এআই রেভোলিউশনের টেকনিক্যাল বিষয়গুলো নিয়ে আরও গভীরভাবে গবেষণা করতে চান, তবে নিচের অফিসিয়াল হোয়াইটপেপার এবং ডকুমেন্টেশনগুলো পড়তে পারেন:
- Attention Is All You Need (arXiv:1706.03762): ২০১৭ সালে প্রকাশিত গুগলের সেই মূল ঐতিহাসিক Research Paper, যেখানে প্রথম Transformer আর্কিটেকচার এবং Self-Attention মেকানিজম ব্যাখ্যা করা হয়েছে।
- Google Research Blog: Transformer A Novel Neural Network Architecture: গুগল ব্রেইন টিমের নিজস্ব অফিসিয়াল ব্লগ পোস্ট, যেখানে অত্যন্ত সহজ ভাষায় ট্রান্সফরমার আর্কিটেকচারের কাজের ধরন ও প্যারালাল প্রসেসিং সুবিধা তুলে ধরা হয়েছে।
- Improving Language Understanding by Generative Pre-Training (GPT-1 Paper): ওপেনআই-এর প্রথম গবেষণাপত্র যেখানে তারা গুগলের ট্রান্সফরমার ব্যবহার করে Pre-training এবং Fine-tuning কনসেপ্ট প্রমাণ করে।
- Language Models are Few-Shot Learners (GPT-3 Paper - arXiv:2005.14165): ওপেনআই-এর ১৭৫ বিলিয়ন প্যারামিটার মডেলের পেপার, যা প্রমাণ করেছিল Scaling Laws কীভাবে জেনারেটিভ এআই-এর ম্যাজিক তৈরি করে।
- just Gemini: A Family of Highly Capable Multimodal Models (arXiv:2312.11805): ওপেনআই-এর সাথে প্রতিযোগিতায় ফিরে আসার পর গুগলের রিলিজ করা সর্বাধুনিক Gemini আর্কিটেকচারের অফিসিয়াল টেকনিক্যাল রিপোর্ট।
- The Illustrated Transformer by Jay Alammar: আন্ডার-দ্য-হুড ডাটা ফ্লো, ম্যাট্রিক্স মাল্টিপ্লিকেশন এবং অ্যাটেনশন হেড কীভাবে কাজ করে তা ভিজ্যুয়ালি বোঝার জন্য সফটওয়্যার ইঞ্জিনিয়ারদের মাঝে সবচেয়ে জনপ্রিয় ব্লগ।