Messenger-এর "Delete Conversation" ফিচার আসলে Under-the-Hood কীভাবে কাজ করে?
On this page
সাধারণ ডেভেলপারদের মধ্যে একটি প্রচলিত ধারণা রয়েছে যে, কোনো চ্যাট অ্যাপ্লিকেশনে "Delete Conversation" বাটনে ক্লিক করা মানেই backend থেকে সরাসরি database-এর ওপর একটি DELETE কোয়েরি চালিয়ে দেওয়া। আপনি যদি ছোটখাটো কোনো প্রজেক্ট তৈরি করেন, তবে এই ব্রুট-ফোর্স পদ্ধতি কাজ করতে পারে। কিন্তু যখন আপনি মেসেঞ্জারের মতো high-throughput distributed systems নিয়ে কাজ করবেন, যেখানে প্রতি সেকেন্ডে লাখ লাখ রিকোয়েস্ট প্রসেস হয়, সেখানে hard delete চালানো বা প্রতিটি ইউজারের জন্য আলাদা করে data duplication করা একটি মারাত্মক engineering disaster ডেকে আনতে পারে।
চলুন শুরুতে বোঝার চেষ্টা করি, কেন সাধারণ বা naive approach-গুলো production environment-এ পুরোপুরি ব্যর্থ হয়।
-
Hard Delete Fallacy: আপনি যখন কোনো চ্যাট ডিলিট করেন এবং সিস্টেম যদি সরাসরি ডিলিট কোয়েরি চালায়, তবে আপনার ডিলিট রিকোয়েস্টের কারণে আপনার এবং আপনার সাথে চ্যাট করা অপর ইউজারের ইনবক্স থেকে পুরো ডাটা মুছে যাবে। এটি কোনোভাবেই গ্রহণযোগ্য নয়, কারণ এতে business recall এবং user experience দুটোই সম্পূর্ণ নষ্ট হয়।
-
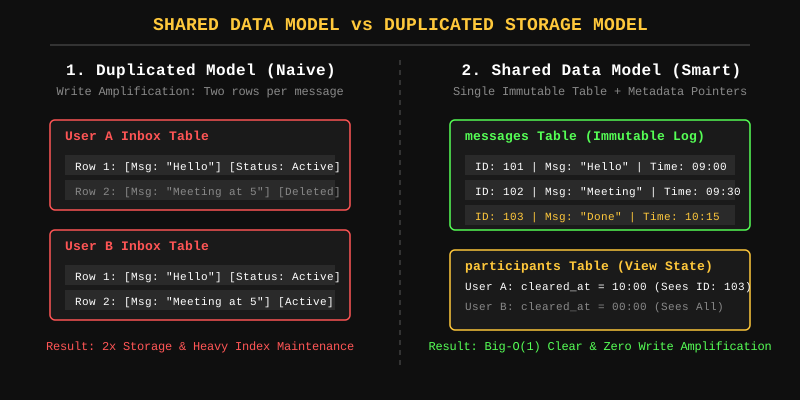
Data Duplication Anti-Pattern: এই সমস্যা সমাধানের জন্য অনেক ডেভেলপার প্রতিটি ইউজারের জন্য আলাদা database row তৈরি করার কথা ভাবেন। কিন্তু যখনই আপনি প্রতিটি মেসেজের জন্য দুটি করে row তৈরি করবেন, তখনই সিস্টেমে write amplification ঘটবে।
-
Impact on Production: ডাটা ডুপ্লিকেশনের ফলে storage costs অস্বাভাবিক হারে বৃদ্ধি পায়। এছাড়া database index অত্যন্ত ভারী হয়ে যায় এবং query latency এক্সপোনেনশিয়ালি বেড়ে গিয়ে পুরো সিস্টেমকে ধীরগতির করে তোলে।
-
The Core Solution: এই জটিল সমস্যার সমাধান করতে মেসেঞ্জারের মতো স্কেলাবল সিস্টেমগুলো smart metadata management এবং timestamp-based view filtering ব্যবহার করে। এর ফলে কোনো মেসেজ ডিলিট না করেই Big-O(1) storage complexity-তে পুরো সমস্যার একটি অপটিমাইজড সমাধান নিশ্চিত করা সম্ভব হয়।
Foundational Mental Model এবং একটি রিয়েল-ওয়ার্ল্ড অ্যানালজি
লো-লেভেল আর্কিটেকচারে ঢোকার আগে আমাদের একটি কোর কনসেপ্ট পরিষ্কার করতে হবে, আর তা হলো Shared Immutable Data vs. User-Specific View State। এর মূল দর্শন হলো, মূল ডাটা বা মেসেজ লগ সবসময় অপরিবর্তিত থাকবে, আমরা কেবল ইউজারের read query-র বাউন্ডারি বা সীমানা পরিবর্তন করে দেব।
বিষয়টি সহজে বোঝার জন্য আমরা একটি বাস্তব জীবনের অ্যানালজি ব্যবহার করতে পারি।
-
The Setup: মনে করুন, আপনার অফিসের দেওয়ালে একটি বিশাল shared noticeboard রয়েছে, যেখানে প্রতিদিনের বিভিন্ন প্রাতিষ্ঠানিক নোটিশ টাঙানো হয়।
-
The Problem: কয়েক মাসের পুরনো নোটিশগুলো দেখে আপনার কাজের মনোযোগ নষ্ট হচ্ছে, কিন্তু আপনার সহকর্মীর রানিং প্রজেক্টের জন্য সেই পুরনো নোটিশগুলো অত্যন্ত প্রয়োজন।
-
The Naive Fixes: এই পরিস্থিতিতে আপনি যদি বোর্ড থেকে নোটিশগুলো ছিঁড়ে ফেলেন (Hard Delete), তবে আপনার সহকর্মী বিপদে পড়বেন। আবার আপনাদের দুজনের জন্য আলাদা দুটি বিশাল নোটিশবোর্ড তৈরি করাও (Data Duplication) একটি অপচয় এবং অবাস্তব সমাধান।
-
The Smart Solution: এর চেয়ে অনেক স্মার্ট সমাধান হলো, আপনি চোখে একটি বিশেষ visor বা চশমা পরে নেবেন, যার মধ্যে একটি ফিল্টার লজিক সেট করা থাকবে: "আজ সকাল ১০টার আগের কোনো নোটিশ আমাকে দেখাবে না"। এতে করে নোটিশবোর্ডে পুরনো নোটিশ ঠিকই থাকবে, কিন্তু আপনার চোখ কেবল সকাল ১০টার পরের নোটিশগুলোই দেখতে পাবে।
-
Application to Software: আমাদের সফটওয়্যার আর্কিটেকচারে database হলো সেই shared noticeboard, আর ইউজারের profile metadata-তে থাকা timestamp হলো আপনার চশমার ফিল্টার।
Under-The-Hood Architecture (The Core Deep Dive)
এখন চলুন আমরা সরাসরি database engine-এর ভেতরে প্রবেশ করি। এই আর্কিটেকচারটি ঠিকমতো কাজ করানোর জন্য আমাদের relational বা NoSQL document store-কে প্রধানত দুটি আলাদা লেয়ারে বিভক্ত করতে হবে।
A. messages Table (The Immutable Log)
এটি হলো আমাদের মূল মেসেজ স্টোরেজ, যা একটি append-only টেবিল হিসেবে কাজ করে। সাধারণ অপারেশনে এই টেবিলে কখনো কোনো UPDATE বা DELETE কোয়েরি চালানো হয় না। এই টেবিলের core columns-গুলো হলো: message_id (UUID), conversation_id (Indexed UUID), sender_id (UUID), payload (Text/Blob), এবং created_at (Timestamp)।
B. conversation_participants Table (The View State Engine)
এটি হলো আমাদের সিস্টেমের আসল ম্যাজিক বক্স, যা প্রতিটি ইউজারের পার্সোনাল স্টেট এবং ভিউ বাউন্ডারি ট্র্যাক করে। এই টেবিলের core columns-গুলোর মধ্যে রয়েছে conversation_id, user_id, last_read_timestamp, এবং সবচাইতে গুরুত্বপূর্ণ cleared_at_timestamp (যা একটি invisible wall বা অদৃশ্য দেয়াল হিসেবে কাজ করে)।
The Query Mechanics
যখন কোনো ইউজার তার ইনবক্স লোড করে বা কোনো নির্দিষ্ট চ্যাট থ্রেড ওপেন করে, তখন আমাদের backend engine কখনোই সাধারণ SELECT * কোয়েরি চালায় না। এর বদলে সিস্টেম একটি filtered read query এক্সিকিউট করে। কোয়েরির SQL logic-টি দেখতে ঠিক নিচের মতো হয়:
SELECT message_id, sender_id, payload, created_atFROM messagesWHERE conversation_id = 'conv_12345' AND created_at > ( SELECT cleared_at_timestamp FROM conversation_participants WHERE conversation_id = 'conv_12345' AND user_id = 'user_A' )ORDER BY created_at ASC;Index Optimization (B-Tree / LSM-Tree)
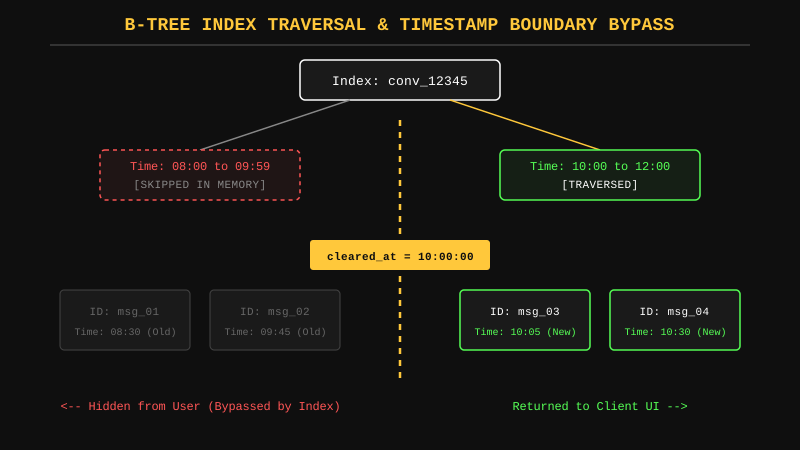
টেবিল থেকে কোটি কোটি মেসেজের মধ্যে এই কোয়েরি দ্রুত চালানোর জন্য full table scan এড়ানো অত্যন্ত জরুরি। এর জন্য আমরা (conversation_id, created_at)-এর ওপর একটি composite index তৈরি করি। যখন কোয়েরিটি ডাটাবেজে হিট করে, তখন database engine তার B-Tree বা LSM-Tree ইনডেক্স ধরে Big-O(log N) time complexity-তে ট্রি ট্রাভার্স করে। ইনডেক্সিং অর্ডারের কারণে cleared_at_timestamp-এর আগের সব পুরনো মেসেজ মেমোরি লেভেলেই বাইপাস হয়ে যায়, যা query execution-কে করে তোলে আলোর মতো দ্রুতগতিসম্পন্ন।
Step-by-Step Execution Trace ও Code Mechanics
আপনি যখন অ্যাপের ইন্টারফেসে "Delete Conversation" বাটনে চাপ দেন, তখন আসলে under-the-hood কী ঘটে, চলুন তার একটি step-by-step execution trace দেখে নেওয়া যাক।
-
Step 1: User Triggers "Delete Conversation": ক্লায়েন্ট অ্যাপ্লিকেশন থেকে backend-এর
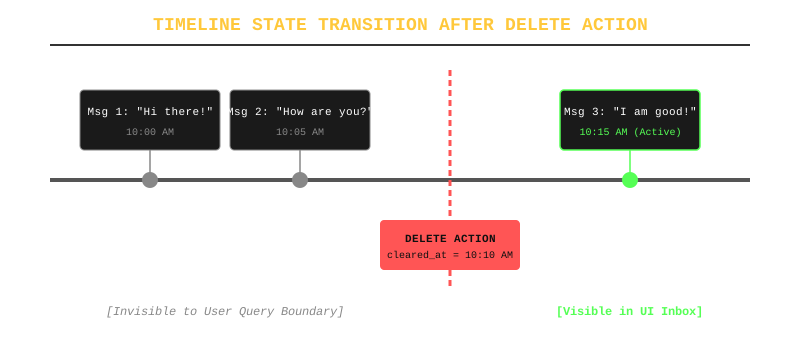
POST /api/v1/conversations/{id}/clearএন্ডপয়েন্টে একটি রিকোয়েস্ট পাঠানো হয়। এই রিকোয়েস্ট পাওয়ার পর database-এরmessagesটেবিলে কোনো হাত দেওয়া হয় না। সিস্টেম কেবলconversation_participantsটেবিলে উক্ত ইউজারেরcleared_at_timestamp-এর ভ্যালু আপডেট করে বর্তমান সময়ের timestamp বসিয়ে দেয়। একই সাথে, দ্রুত read performance নিশ্চিত করতে Redis বা application cache থেকে পুরনো মেটাডাটা evict করা হয়। -
Step 2: The Inbox List Re-render: টাইমস্ট্যাম্প আপডেট হওয়ার সাথে সাথে যখন ইনবক্স রেন্ডার করার জন্য filtered query রান করা হয়, তখন
cleared_at_timestamp-এর চেয়ে বড় কোনো মেসেজ না থাকায় query result count0আসে। এর ফলে অ্যাপ্লিকেশনের UI থেকে চ্যাট উইন্ডোটি সম্পূর্ণ হাইড হয়ে যায় বা ব্ল্যাংক দেখায়। -
Step 3: New Message Arrival: কিছুক্ষণ পর অপর ইউজার যদি আপনাকে একটি নতুন মেসেজ পাঠায়, তবে সেই নতুন মেসেজটি যথারীতি
messagesটেবিলে append হয়। এরপর একটি message broker (যেমন Kafka বা RabbitMQ) হয়ে আপনার ডিভাইসে push notification পাঠানো হয়। -
Step 4: The Re-emergence in Inbox: আপনি যখন অ্যাপটি ওপেন করেন, তখন আবার আমাদের filtered query রান হয়। যেহেতু নতুন মেসেজের
created_atটাইমস্ট্যাম্প আপনার ফিল্টার বাউন্ডারি অর্থাৎcleared_at_timestamp-এর চেয়ে বড়, তাই এই মেসেজটি কোয়েরি রেজাল্টে ফেরত আসে। UI সাথে সাথে চ্যাট বক্সটি রি-অ্যাক্টিভেট করে ইউজারকে কেবল নতুন মেসেজটি দেখায়, আর পুরনো সব মেসেজ সেই invisible wall-এর পেছনেই আটকা থেকে যায়।
Important
Soft Delete vs. Timestamp Boundary
প্রতিটি মেসেজে আলাদাভাবে is_deleted ফ্ল্যাগ বসানো (Soft Delete) একটি অত্যন্ত ধীরগতির এবং ব্যয়বহুল প্রক্রিয়া, কারণ এতে প্রতিটি row আপডেট করতে হয়। এর বদলে একটি সিঙ্গেল cleared_at_timestamp মেটাডাটা আপডেট করা Big-O(1) time complexity নিশ্চিত করে, যা সিস্টেমের write amplification শূন্যে নামিয়ে আনে।
Edge Cases, Pitfalls এবং Architectural Trade-offs
একটি স্কেলাবল আর্কিটেকচার ডিজাইন করার সময় কেবল হ্যাপি পাথ (happy path) চিন্তা করলেই চলে না। extreme production load এবং মেমোরি সীমাবদ্ধতার মধ্যে আমাদের কিছু গুরুত্বপূর্ণ edge cases এবং trade-offs মাথায় রাখতে হয়।
A. Storage Growth vs. Garbage Collection (GDPR Compliance)
সমস্যা: আমরা যদি মূল মেসেজগুলো কখনোই ডিলিট না করি এবং অনন্তকাল ধরে ডাটা জমাতে থাকি, তবে storage cost আকাশছোঁয়া হয়ে যাবে। এছাড়া বিভিন্ন দেশের privacy law (যেমন ইউরোপের GDPR compliance) অনুযায়ী ইউজারের ডিলিট করা ডাটা আজীবন রেখে দেওয়া আইনত দণ্ডনীয়।
সমাধান: এই সমস্যা সমাধানে আমাদের ব্যাকগ্রাউন্ড asynchronous garbage collection (GC) বা cron job চালাতে হয়। এই জবটি নিয়মিত চেক করে, যখন কোনো কনভারসেশনের উভয় ইউজারের cleared_at টাইমস্ট্যাম্প কোনো নির্দিষ্ট মেসেজের created_at-এর চেয়ে বড় হয়ে যায় (অর্থাৎ দুজনের কেউই আর মেসেজটি দেখতে চান না), কেবল তখনই সেই মেসেজগুলোকে disk থেকে hard delete করা হয়।
Warning
The Compliance & Privacy Trap
আপনার সিস্টেমে যদি automated data retention policy এবং dual-deletion purge মেকানিজম না থাকে, তবে timestamp-based filtering ব্যবহার করলেও আপনি বড় ধরনের লিগ্যাল রিস্কের মুখে পড়বেন। ইউজারের প্রাইভেসি সুরক্ষায় background GC implement করা বাধ্যতামূলক।
B. Index Bloating ও Performance Degradation
সমস্যা: লাখ লাখ ডিলিট করা মেসেজ টেবিলে জমতে থাকলে, ইনডেক্স ট্রাভার্স করার সময় database engine-কে প্রচুর মৃত বা invisible node বাইপাস করতে হয়। এর ফলে read latency ধীরে ধীরে বৃদ্ধি পেতে পারে।
সমাধান: এই performance degradation ঠেকাতে database partitions এবং time-series bucketing ব্যবহার করা হয়। নির্দিষ্ট সময় পার হয়ে যাওয়া পুরনো ডাটাগুলোকে আমরা active index থেকে সরিয়ে cold storage-এ পাঠিয়ে দিই, যাতে গরম বা active index সবসময় ছোট এবং দ্রুতগতির থাকে।
C. Clock Skew in Distributed Servers
সমস্যা: distributed systems-এ পৃথিবীর বিভিন্ন রিজিয়নে ছড়িয়ে থাকা সার্ভারগুলোর ঘড়ির মধ্যে মিলি-সেকেন্ডের পার্থক্য বা clock skew থাকতে পারে। এর ফলে timestamp mismatch হয়ে race condition তৈরি হতে পারে, যেখানে নতুন মেসেজও ভুলবশত invisible wall-এর পেছনে হাইড হয়ে যেতে পারে।
সমাধান: এই ধরনের race condition এড়াতে কখনোই লোকাল সার্ভার টাইম ব্যবহার করা যাবে না। এর বদলে database-generated UTC timestamp অথবা Google TrueTime ও Snowflake ID-র মতো centralized monotonically increasing time-source ব্যবহার করতে হবে।
Tip
Query Optimization Pro-Tip
ডাটাবেজে composite index তৈরি করার সময় সবসময় Leftmost Prefix Rule মেনে চলুন। আমাদের কোয়েরি প্যাটার্ন অনুযায়ী (conversation_id, created_at) ইনডেক্সে conversation_id-কে অবশ্যই আগে রাখতে হবে এবং created_at-কে পরে রাখতে হবে। এতে করে ডাটাবেজ প্রথমে সঠিক চ্যাট থ্রেডটি আইসোলেট করে, তারপর টাইমস্ট্যাম্প বাউন্ডারি ফিল্টার করে।
Summary এবং Production Decision Rules
পুরো Deep Dive থেকে আমাদের কোর লেসন হলো: স্কেলাবল সিস্টেম তৈরিতে ব্রুট-ফোর্স ডাটাবেজ অপারেশনের বদলে সবসময় স্মার্ট মেটাডাটা এবং কোয়েরি বাউন্ডারি ব্যবহার করতে হবে। আপনি যখন আপনার পরবর্তী প্রজেক্টের আর্কিটেকচার ডিজাইন করবেন, তখন নিচের production decision matrix-টি গাইডলাইন হিসেবে ব্যবহার করতে পারেন:
| আর্কিটেকচারাল মডেল | কখন ব্যবহার করবেন? | মূল সুবিধা ও অসুবিধা (Trade-offs) |
|---|---|---|
| Duplicated Data Model | ছোট স্কেলের অ্যাপ্লিকেশন অথবা যেখানে সম্পূর্ণ আইসোলেটেড E2E (End-to-End) এনক্রিপশন প্রয়োজন। | প্রতি ইউজারের সম্পূর্ণ ডাটা কন্ট্রোল থাকে, কিন্তু write amplification এবং storage cost অত্যন্ত বেশি। |
| Row-Level Soft Delete | যখন ইউজার কোনো নির্দিষ্ট সিঙ্গেল মেসেজ ডিলিট (যেমন: Unsend বা Delete for everyone) করতে চায়। | নির্দিষ্ট মেসেজ টার্গেট করা সহজ, কিন্তু পুরো চ্যাট ক্লিয়ার করার ক্ষেত্রে এটি database-এর ওপর প্রচণ্ড চাপ তৈরি করে। |
| Timestamp-Based View Filtering | যখন ইউজার পুরো চ্যাট থ্রেড বা ইনবক্স ফিড এক ক্লিকে ক্লিয়ার করতে চায়। | Zero write amplification এবং Big-O(1) complexity নিশ্চিত করে। তবে ব্যাকগ্রাউন্ডে garbage collection এবং timestamp synchronicity পরিচালনা করতে হয়। |
আশা করি, এখন থেকে আপনি যখনই কোনো high-throughput অ্যাপ্লিকেশনের ডাটাবেজ বা চ্যাট সিস্টেম ডিজাইন করবেন, তখন এই timestamp-based bounded filtering লজিকটি আপনার সিস্টেমকে আরও নির্ভুল এবং পারফরম্যান্ট করতে সাহায্য করবে। হ্যাপি কোডিং!