Distributed Locks Under the Hood: Redlock, Fencing Tokens and the Split-Brain Problem
On this page
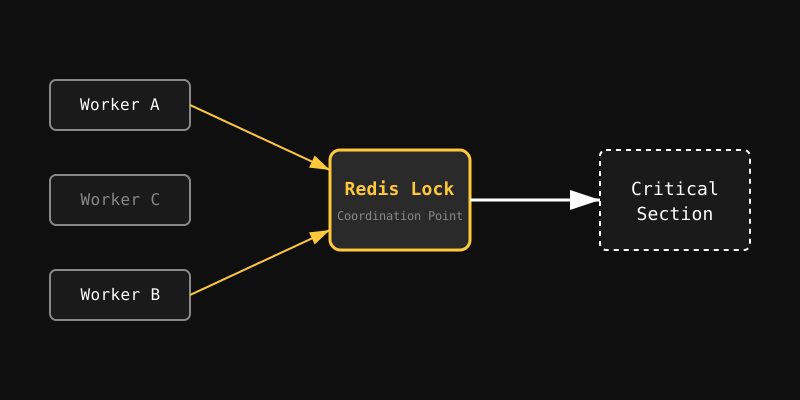
একটি Production System কল্পনা করুন যেখানে একই সময়ে কয়েকটি Node.js Server চলছে। ধরুন, প্রতি রাতে আপনার সিস্টেমে একটি Background Job চলে যার কাজ হলো generateMonthlyInvoices() Execute করা। হঠাৎ দেখলেন একই সময়ে দুটি Server একই Job Execute করে ফেলেছে এবং একজন Customer এর Invoice দুইবার তৈরি হয়ে গেছে। অথবা Payment Processing System এ একই Payment দুইবার Process হয়ে গেছে, কিংবা একটি Shared Inventory Row দুটি আলাদা Worker একই সময়ে Update করে ফেলেছে। এই ধরনের পরিস্থিতিতে একজন Engineer এর মাথায় সবার আগে যে Obvious Solution আসে তা হলো, এই Critical Section এর আগে একটি Redis Lock বসিয়ে দেওয়া। আপাতদৃষ্টিতে মনে হতে পারে Worker A এবং Worker B এর মাঝখানে একটি Redis Coordination Point বসিয়ে দিলেই Problem Solved। কিন্তু আসল প্রশ্নটি হলো, যদি Worker A Lock নেওয়ার পরেও কাজ শেষ করতে না পারে এবং Lock এর TTL Expire হয়ে যায়, তখন আসলে কী ঘটবে? এই একটি মাত্র প্রশ্ন থেকেই Distributed Systems এর সবচেয়ে জটিল একটি Architecture এর Journey শুরু হয়।
The Real Objective Behind Locking
আমাদের প্রথমেই বুঝতে হবে যে একটি Lock আসলে ঠিক কী Solve করতে চায়। এখানে কোড নিয়ে চিন্তা করার আগে Engineering Requirement Define করা বেশি জরুরি। আমাদের মূল উদ্দেশ্য হলো একই সময়ে শুধুমাত্র একজন Valid Worker যেন Critical Operation করতে পারে। এর পাশাপাশি কোনো Worker Crash করলে অন্য Worker যেন Eventually কাজ করতে পারে এবং Infrastructure Failure হলেও System যেন Unsafe State এ না যায়। এই তিনটি প্রপার্টি মূলত Safety, Liveness এবং Fault Tolerance হিসেবে পরিচিত। Safety নিশ্চিত করে যে একই সময়ে দুজন Worker যেন Protected Resource এর ওপর Conflicting Operation না করতে পারে। Liveness নিশ্চিত করে যে একজন Worker Crash করলে তার জন্য পুরো System যেন Permanently আটকে না থাকে। আর Fault Tolerance নিশ্চিত করে যে Redis Node, Network অথবা Application Instance Fail করলেও System এর Behaviour যেন Predictable থাকে। Lock শুধুমাত্র Concurrency Control করে না, এর সঙ্গে Failure Recovery ও Design করতে হয়।
Horizontal Scaling এর কারণে একই Application এর একাধিক Instance চলাটাই স্বাভাবিক এবং একই Job বা Resource নিয়ে একাধিক Worker কাজ করতেই পারে। Database Transaction সবসময় পুরো Distributed Workflow Protect করতে পারে না, তাই Redis Lock কে প্রাথমিকভাবে একটি সহজ Solution মনে হয়। কিন্তু Lock Expire হওয়ার পর পুরনো Worker যদি তখনও কাজ চালিয়ে যায়, তখন নতুন Worker Lock পেলেও পুরনো Worker এর Stale Operation পুরো System এর মারাত্মক ক্ষতি করতে পারে।
Mental Model Context
Process Alive থাকা আর Lock Alive থাকা সম্পূর্ণ আলাদা দুটি বিষয়। একটি Worker Memory তে Alive থাকতে পারে, তার Network Connection Active থাকতে পারে, কিন্তু তার Lock এর Authority অনেক আগেই শেষ হয়ে যেতে পারে।
From Locks to Time-Bound Leases
পুরো বিষয়টিকে সহজভাবে বোঝার জন্য আমরা একটি Warehouse এর Single Access Card এর অ্যানালজি ব্যবহার করতে পারি। ধরুন একটি Warehouse এর ভেতরে একটি বিশেষ Room আছে যেখানে একই সময়ে শুধুমাত্র একজন Operator ঢুকতে পারবে। একজন Operator একটি Access Card নিয়ে ভেতরে কাজ শুরু করল, কিন্তু Security System বলছে এই Access Card ঠিক ত্রিশ মিনিট পর Automatically Invalid হয়ে যাবে। এখন Operator যদি পয়তাল্লিশ মিনিট ধরে কাজ করে, তবে ত্রিশ মিনিট পর দ্বিতীয় Operator নতুন Card পেয়ে Room এ ঢুকে যাবে। প্রথম Operator কিন্তু তখনও ভেতরেই কাজ করছে। Security System আসলে Guarantee করেনি যে Room এর ভেতরে শুধুমাত্র একজন থাকবে, সে শুধু Guarantee করেছিল যে একটি নির্দিষ্ট সময় পর্যন্ত প্রথম Operator এর Access Valid থাকবে। ঠিক এখান থেকেই Lease কনসেপ্টটির উৎপত্তি হয়।
যখন আমরা Redis এ SET resource:123 worker-token NX PX 30000 কমান্ড চালাই, তখন NX নিশ্চিত করে যে Key আগে থেকে না থাকলে তবেই Set হবে এবং PX 30000 নিশ্চিত করে যে ত্রিশ সেকেন্ড পর Key Expire করবে। Reader হিসেবে আপনার মনে হতে পারে এটি Perfect Solution, কারণ একজন Lock নিলে অন্যজন ঢুকতে পারবে না। কিন্তু যদি Worker A Lock নেওয়ার পর Process Crash করে, এবং Lock এর কোনো Expiry না থাকে, তবে সেই Lock Forever থেকে যাবে এবং Worker B আর কখনোই Resource Acquire করতে পারবে না। এই কারণেই TTL বা Time To Live প্রয়োজন হয়। কিন্তু Long TTL ব্যবহার করলে Crash Recovery অনেক Slow হয়ে যায়, আবার Short TTL ব্যবহার করলে Work Outliving The Lease এর সম্ভাবনা তৈরি হয়। TTL আসলে Lock কে একটি Time-Bound Ownership দেয়, যাকে আমরা Lease বলি। Lease মানে হলো এই Resource এর ওপর আপনার Authority আছে, কিন্তু সেটি Indefinite নয়, বরং নির্দিষ্ট সময় পর্যন্ত Valid। Worker এর Perspective থেকে মনে হয় সে Lock Acquire করেছে, কিন্তু System এর Perspective থেকে তার Authority শুধুমাত্র Lease Expire হওয়া পর্যন্তই সীমাবদ্ধ।
The Race Condition in Lock Release
Lease কনসেপ্টটি বুঝতে পারার পর আমাদের Lock Release মেকানিজমের ভেতরের Race Condition নিয়ে আলোচনা করতে হবে। ধরুন Worker A একটি Lock Acquire করল এবং তারপর কোনো কারণে অনেকক্ষণ Pause হয়ে থাকল। ত্রিশ সেকেন্ড পর Lock Expire করে গেল এবং Worker B একটি নতুন Lock Acquire করল। ঠিক এই সময়ে Worker A আবার Resume করল এবং সরাসরি DEL resource:123 Command Execute করে দিল। এখানে মারাত্মক একটি ঘটনা ঘটল, Worker A আসলে নিজের Lock Delete করছে না, সে Worker B এর নতুন Lock Delete করে দিচ্ছে। এর ফলে Worker B এর Lock Disappear হয়ে যায় এবং System সম্পূর্ণ Unsafe State এ চলে যায়।
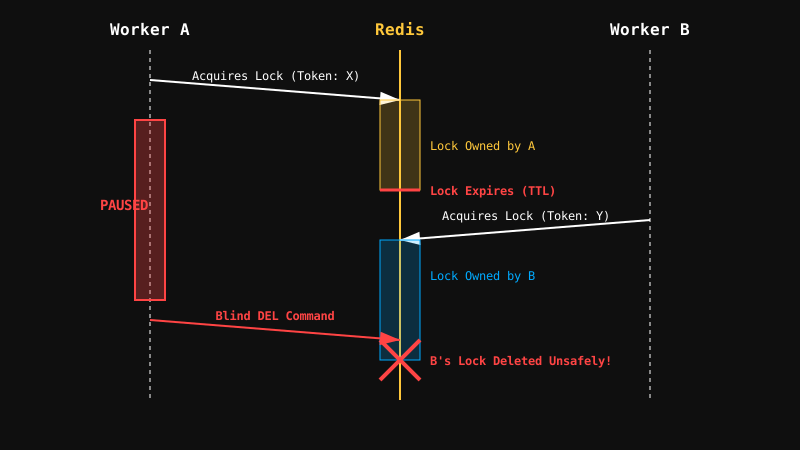
এই ধরনের Production Bug এড়ানোর জন্যই Lock এর সঙ্গে একটি Unique Ownership Token বা Random Lock Token ব্যবহার করা প্রয়োজন। Lock Value হিসেবে একটি Random String সেট করা হয় এবং Release করার সময় Logic চেক করে দেখে যে বর্তমান Lock এর Value এবং Worker এর Token একই কি না। যদি মিলে যায় তবেই Delete করা হয়, অন্যথায় Operation Reject করা হয়। সাধারণত Lua Script বা Atomic Conditional Operation ব্যবহার করে এই Release Process Safely Handle করা হয়:
if redis.call("get", KEYS[1]) == ARGV[1] then return redis.call("del", KEYS[1])else return 0endকিন্তু এখানে একটি অত্যন্ত সূক্ষ্ম পার্থক্য মাথায় রাখতে হবে, Random Lock Token মূলত Ownership Identify করে, কিন্তু এটি Stale Worker কে Prevent করতে পারে না।
Dangerous Assumption
Random Lock Token আপনাকে শুধুমাত্র Safe Unlock এর গ্যারান্টি দেয়। এটি কখনোই গ্যারান্টি দেয় না যে আপনার Worker এর Execution Context এখনও Valid আছে।
Redis Failover and the Split-Brain Problem
এখন পর্যন্ত আমাদের Architecture একটি Single Redis Instance এর ওপর নির্ভরশীল ছিল, কিন্তু Production System এ Redis নিজেই Fail করতে পারে। ধরুন আপনার Architecture এ একটি Redis Primary এবং একটি Redis Replica আছে। Worker A Primary Node থেকে Lock নিল, কিন্তু ঠিক তারপরেই Primary Node Crash করল। Lock এর Data Replica তে Synchronize বা Replicate হওয়ার আগেই Replica Node টি নতুন Primary হিসেবে Promote হয়ে গেল। এই অবস্থায় Worker B নতুন Primary Node এ Request পাঠিয়ে সফলভাবে Lock Acquire করে ফেলল। এখন Worker A ভাবছে সে Lock এর মালিক, এবং Worker B ও ভাবছে সে Lock এর মালিক। এটি Distributed Locking এর সবচেয়ে Dangerous Failure Mode, যাকে Split-Brain Problem বলা হয়।
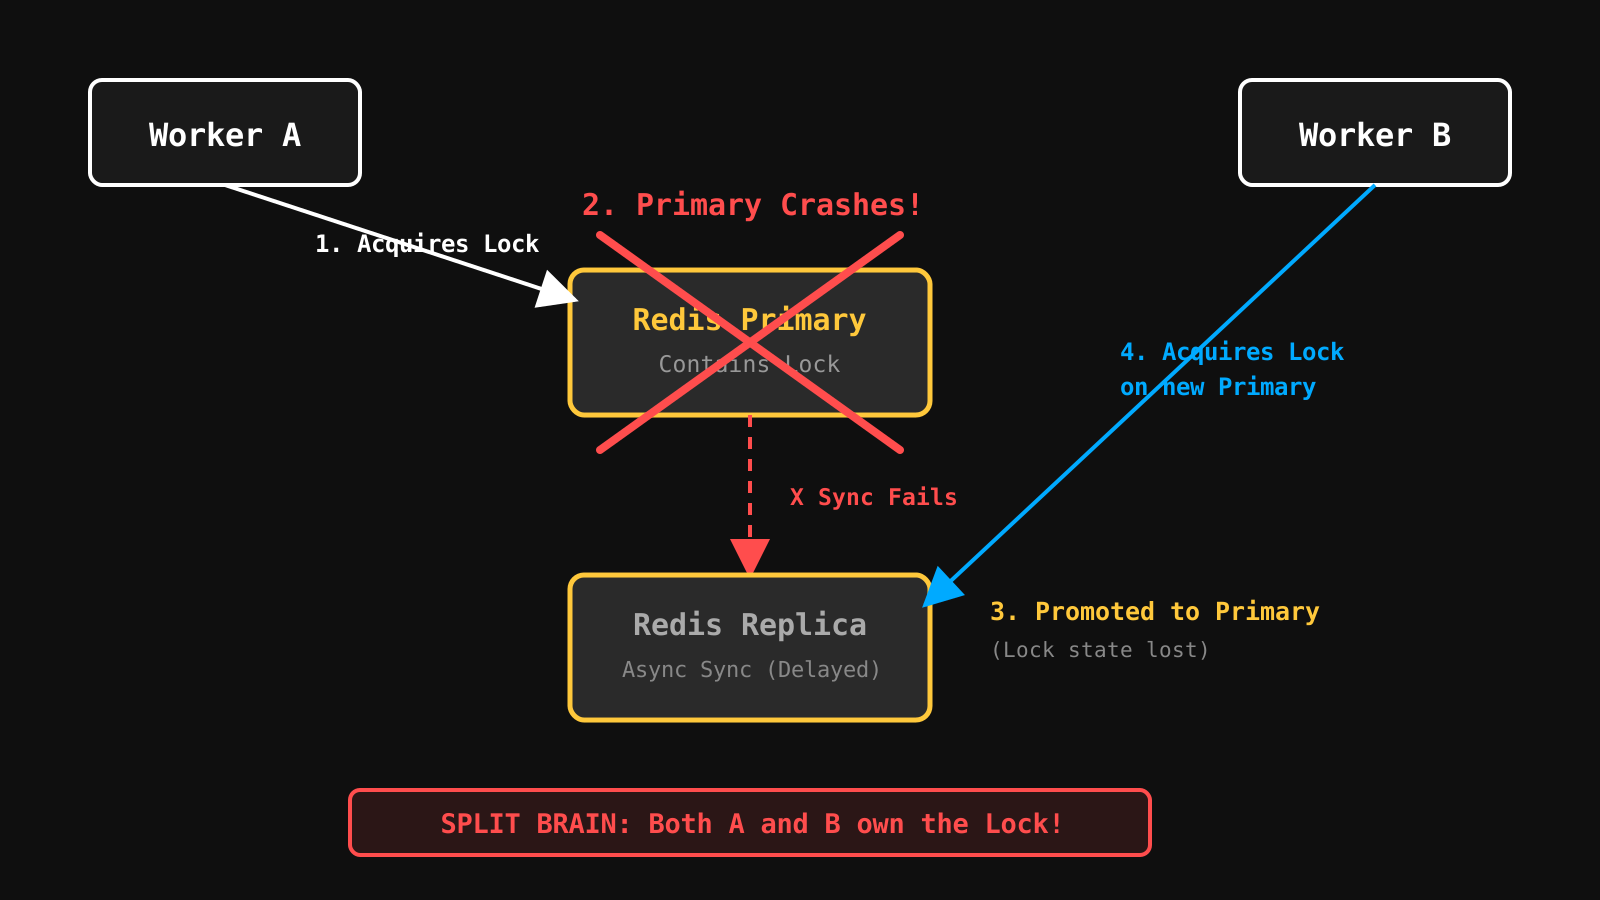
এখানে একটি গুরুত্বপূর্ণ Engineering Principle Establish করা প্রয়োজন, High Availability মানেই Correctness নয়। Redis Replica Failover আপনার System কে Available রাখতে সাহায্য করে ঠিকই, কিন্তু Lock State যদি Perfectly Preserved না হয়, তবে Availability বাড়ানোর এই Process টিই আপনার System এর Safety Break করতে পারে। আমরা আসলে এমন একটি Locking Mechanism চাই যেখানে Infrastructure Fail করলেও দুজন Worker কখনোই Simultaneously Valid Owner হতে পারবে না।
Redlock and the Illusion of Time
Single Redis Node এর Failure Handle করার জন্য Redlock Algorithm এর আবির্ভাব ঘটে। Redlock মূলত একটি Redis এর বদলে একাধিক Independent Redis Instance ব্যবহার করে। ধরুন আপনার কাছে পাঁচটি Independent Redis Node আছে। একজন Worker এই পাঁচটি Node এই Lock Acquire করার চেষ্টা করবে এবং Majority বা অন্তত তিনটি Node এ সফলভাবে Lock পেলে তবেই সেটিকে Valid Lock হিসেবে ধরে নেওয়া হবে। যদি দুজন Worker একই সময়ে Lock পেতে চায়, তবে তাদের Majority Set এর মধ্যে অন্তত একটি Common Node থাকবেই, যার ফলে Distributed Quorum ধারণাটি কাজ করে। কিন্তু শুধু Majority পেলেই হবে না, Acquisition এর জন্য যে সময় ব্যয় হয়েছে সেটিও অত্যন্ত গুরুত্বপূর্ণ।
Redlock এর Acquisition Flow অনুযায়ী, Worker প্রথমে একটি Start Timestamp রেকর্ড করে এবং এক এক করে পাঁচটি Node এ Lock Try করে। Majority পাওয়ার পর সে চেক করে দেখে যে Lock Acquire করতে মোট কত সময় লেগেছে। যদি Elapsed Time অতিক্রান্ত হওয়ার পরও Validity Remaining থাকে, তবেই Lock Acquired বলে গণ্য হয়। কিন্তু এখানেই Redlock এর সবচেয়ে বড় Hidden Assumption লুকিয়ে আছে, আর সেটি হলো Time। Redlock এর Validity পুরোপুরি Time Measurement এর ওপর নির্ভরশীল, কিন্তু Real Production Environment এ Network Delay, Clock Drift, Process Scheduling, Garbage Collection Pause, CPU Starvation, VM Pause, Container Throttling বা Network Partition এর মতো অসংখ্য ঘটনা ঘটতে পারে। একজন Worker নিজের Perspective থেকে ভাবতে পারে তার Lock এখনও Valid, কিন্তু Distributed System এর অন্য অংশের Perspective থেকে সেই Lease অনেক আগেই Expire হয়ে যেতে পারে।
Redlock Vulnerability
Majority Intersection একা পুরো Correctness Problem Solve করতে পারে না। Distributed Systems এ Timing এবং Network Delay সবসময় Unpredictable থাকে।
The Most Dangerous Failure: Paused Worker
পুরো Distributed Locking Architecture এর সবচেয়ে Central Failure Scenario হলো Paused Worker। ধরুন Worker A সফলভাবে Lock Acquire করে কাজ শুরু করল। হঠাৎ করে Worker A একটি দীর্ঘ Garbage Collection Pause, CPU Starvation, VM Suspension বা Network Stall এর শিকার হয়ে Pause হয়ে গেল। এই Pause চলাকালীন সময়ে তার Lock এর Lease Expire হয়ে গেল। সিস্টেমের নিয়ম অনুযায়ী Worker B নতুন Lock Acquire করে তার কাজ সফলভাবে শেষ করল। কিছুক্ষণ পর Worker A এর Pause শেষ হলো এবং সে আবার Resume করল। Worker A কিন্তু জানে না যে সে Pause হয়েছিল, সে এখনও ভাবছে Lock টি তারই আছে এবং সে তার পুরনো Operation ডাটাবেজে Write করতে গেল।
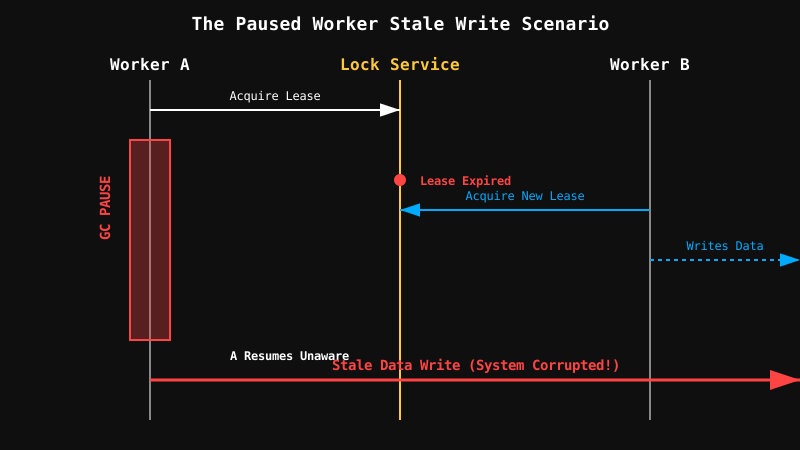
এখানে আসল সমস্যাটি হলো, পুরনো Worker কে কেউ থামায়নি। Lock Expire হওয়া মানে এই নয় যে Worker A এর Process Automatically Stop হয়ে যাবে। Lock Release বা Expiry শুধুমাত্র System এর State পরিবর্তন করে, কিন্তু Running Code Execution কে Physically Kill করতে পারে না। এটি Distributed Systems এর একটি Fundamental Truth।
Fencing Tokens: The Ultimate Correctness Guarantee
Paused Worker এর এই ভয়াবহ সমস্যা সমাধানের জন্য আমাদের Fencing Token কনসেপ্টটি Introduce করতে হবে। ধরুন Worker A যখন Lock নেয়, তখন সে শুধুমাত্র একটি Lock পায় না, বরং Lock Service তাকে একটি Monotonically Increasing Number দেয়, যেমন Token 33। কিছুক্ষণ পর Lease Expire হওয়ার পর Worker B যখন নতুন Lock নেয়, সে পায় Token 34। এখন Resource নিজে জানে যে তার কাছে আসা Last Accepted Token হলো 34। Worker A যদি Pause থেকে ফিরে এসে Token 33 দিয়ে Write করার চেষ্টা করে, তবে Resource দেখবে 33 বর্তমান 34 এর চেয়ে ছোট, তাই সে সরাসরি Operation Reject করে দেবে। অন্যদিকে Worker B এর Token 34 হওয়ায় সেটি অনায়াসেই Accept হয়ে যাবে।
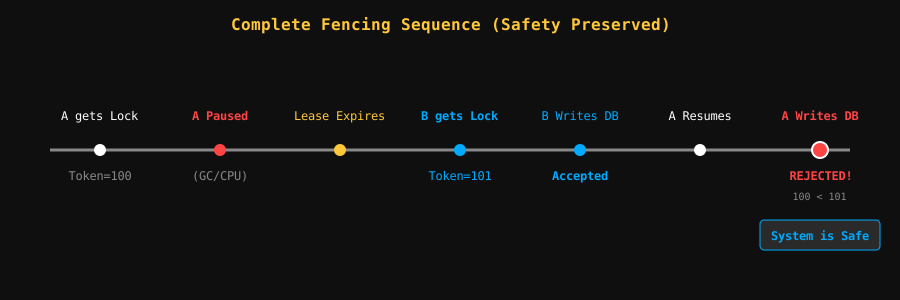
এখানে মূল Idea হলো, পুরনো Worker এর Process Alive থাকলেও তার Authority এখন Obsolete হয়ে গেছে। Random Lock Token এবং Fencing Token এর মধ্যে পার্থক্যটি খুব পরিষ্কারভাবে বোঝা জরুরি। Random Lock Token শুধুমাত্র Uniqueness দিতে পারে, কিন্তু Ordering দিতে পারে না। Fencing Token এর একটি Ordering থাকে, যা প্রমাণ করে কোন Owner টি Newer। Random Lock Token উত্তর দেয় Who Owns This Lock, আর Fencing Token উত্তর দেয় Which Owner Is Newer।
Fencing Rule
Token জেনারেট করা নিজেই একটি Coordination Problem। Database Sequence, ZooKeeper Version বা কোনো Consensus-Backed Counter ব্যবহার করে এই Monotonically Increasing Token তৈরি করতে হয়।
Database-Level Fencing Enforcement
Fencing Token কে সঠিকভাবে কাজে লাগানোর জন্য একটি Common Architectural Mistake এড়িয়ে চলতে হবে। Lock Service থেকে Token নিয়ে Worker যদি সরাসরি Database এ Write করে এবং Database যদি Token সম্পর্কে কিছুই না জানে, তবে Fencing Token দিয়ে কোনো লাভ নেই। Correct Architecture হলো, Database বা Resource কে নিজেই Stale Operation Reject করতে হবে।
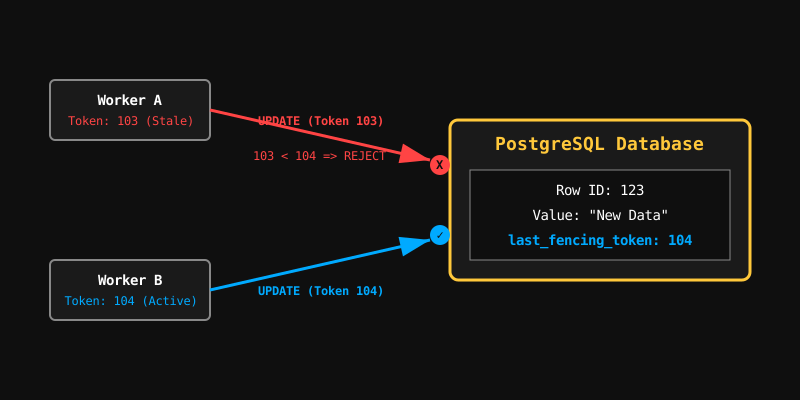
একটি Practical PostgreSQL Example চিন্তা করুন। আমরা একটি Table তৈরি করতে পারি যেখানে id, value এবং last_fencing_token নামের Column থাকবে। Worker যখন Write করবে, সে তার Token টিও পাঠাবে। Query টি দেখতে অনেকটা এরকম হবে:
UPDATE resourcesSET value = $1, last_fencing_token = $2WHERE id = $3 AND last_fencing_token < $2;এখানে Database নিজেই চেক করছে যে Incoming Token টি Current Token এর চেয়ে বড় কি না। যদি Worker A Token 103 নিয়ে আসে, কিন্তু Database এর Current Token 104 থাকে, তবে Condition Match করবে না এবং Update Fail করবে। Database আপডেট এমন হতে হবে যেন Stale Worker Application লেভেলে Bug তৈরি করলেও Database লেভেলে তা Rejected হয়। Correctness-Critical Validation সবসময় Authoritative Resource এর কাছেই Enforce করা উচিত।
Architectural Recap and Production Checklist
Network Partition বা Node Failure এর সময় Safety এবং Availability এর Trade-off বুঝতে পারা একজন Elite Architect এর কাজ। Distributed Lock কখনোই শুধুমাত্র একটি "Lock Acquired" Boolean নয়, এর সাথে Failure Model ও জড়িত থাকে। Long-Running Operation এর ক্ষেত্রে Worker Heartbeat দিয়ে Lease Extend করতে পারে, কিন্তু Lease Renewal Premature Expiry কমাতে পারলেও Stale Worker Problem কে Eliminate করতে পারে না। Distributed Systems এ Failed Request Retry হওয়া খুব স্বাভাবিক একটি ঘটনা, তাই Lock এর সঙ্গে Fencing, Idempotency এবং Atomic Resource Update কে একসঙ্গে Design করতে হয়।
সব জায়গায় Redis Lock ব্যবহার করা ঠিক নয়। Unique Constraint, Database Transaction, SELECT ... FOR UPDATE, Advisory Lock বা Optimistic Concurrency Control এর মতো Database এর Native Mechanism গুলো অনেক ক্ষেত্রেই Better Coordination প্রদান করতে পারে। যদি শুধুমাত্র Duplicate Work কমানো উদ্দেশ্য হয়, তবে Simple Redis Lock যথেষ্ট। কিন্তু Correctness Critical হলে Fencing অবশ্যই প্রয়োজন।
Production এ কোনো Distributed Lock Design করার আগে নিচের চেকলিস্টটি অবশ্যই মিলিয়ে নিতে হবে:
- আপনি ঠিক কোন Resource টি Protect করছেন?
- Worker Crash করলে বা Work চলাকালীন Lease Expire হলে কী হবে?
- Stale Worker কি এখনও Execute এবং Write করতে পারে?
- Fencing Token কে Generate করছে এবং Resource কি সেটি Validate করছে?
- Network Partition, Redis Failover, Process Pause বা Client Retry এর সময় সিস্টেমের Behaviour কেমন হবে?
- Operation টি Idempotent করা সম্ভব কি না এবং Database নিজেই এই Problem Solve করতে পারে কি না?
Lock বলে দেয় কে Critical Section এ ঢুকতে পারবে, Lease বলে দেয় সেই Permission কতক্ষণ Valid, Redlock Multiple Node ব্যবহার করে Distributed Lease Establish করার চেষ্টা করে, আর Fencing Token নিশ্চিত করে পুরনো Stale Worker যেন কোনোভাবেই Resource Corrupt করতে না পারে। A lock does not stop a paused process, a TTL does not kill a stale worker, and a random lock ID does not establish ordering। Production Distributed Systems এ এই লেয়ারগুলোকে আলাদা করে চিনতে পারাটাই সবচেয়ে গুরুত্বপূর্ণ Engineering Skill।