How Database Connection Pools Actually Work Under the Hood (A Deep Dive)
On this page
ধরুন আপনার একটি হাই-ট্রাফিক production application চলছে। হঠাৎ করে আপনি দেখলেন API response time 50ms থেকে লাফ দিয়ে 3 বা 4 seconds হয়ে গেছে। সিস্টেমের অ্যালার্ট বাজতে শুরু করেছে। আপনার প্রথম চিন্তা হতে পারে, "নিশ্চয়ই Database slow হয়ে গেছে।"
আপনি দ্রুত Database-এর ড্যাশবোর্ড চেক করলেন। কিন্তু দেখলেন Database-এর CPU usage স্বাভাবিক, Memory-ও ঠিক আছে, এবং Disk I/O-তে কোনো অস্বাভাবিকতা নেই। এরপর আপনি Application server-এর দিকে তাকালেন, সেখানেও CPU বা Memory-তে কোনো বড় স্পাইক নেই।
তাহলে request আসলে কোথায় আটকে আছে?
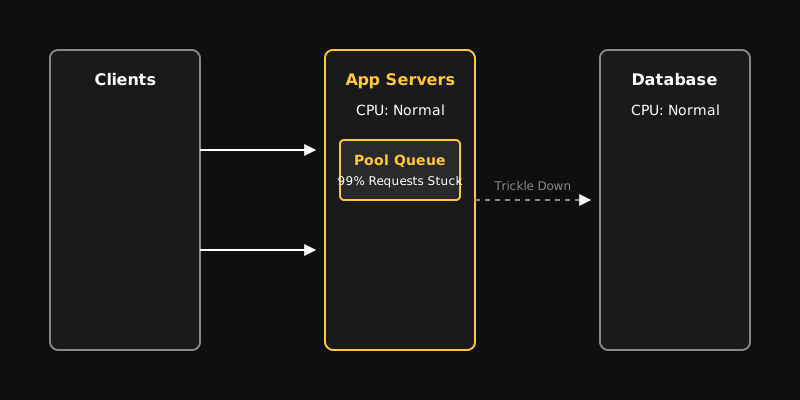
এখান থেকেই আমাদের আজকের deep dive শুরু হবে। অনেক সময় application-এর আসল bottleneck Database-এর query execution টাইম নয়, বরং Database Connection পাওয়ার জন্য request-এর waiting টাইম। আজ আমরা ধাপে ধাপে দেখব Database Connection Pool আসলে কীভাবে কাজ করে, কেন এটি scale করা কঠিন, এবং কীভাবে আপনি আপনার সিস্টেমের এই hidden bottleneck খুঁজে বের করবেন।
Mental Model: Database Connection আসলে কী?
Database Connection-কে শুধু একটি সাধারণ TCP socket ভাবলে পুরো বিষয়টি পরিষ্কার হবে না। Application যখন Database-এর সঙ্গে নতুন একটি Connection তৈরি করে, তখন পর্দার আড়ালে অনেকগুলো expensive operation ঘটে।
প্রথমে একটি TCP 3-way handshake সম্পন্ন হয়। সিকিউরিটির জন্য এরপর TLS handshake সম্পন্ন হয় যেখানে সার্টিফিকেট ভ্যালিডেশন এবং সিমেট্রিক কি নেগোসিয়েশন ঘটে। তারপর Database-লেভেলে authentication এবং authorization চলে। Authentication সফল হলে Database নিজের মেমোরিতে এই সেশনের জন্য dedicated memory context allocate করে।
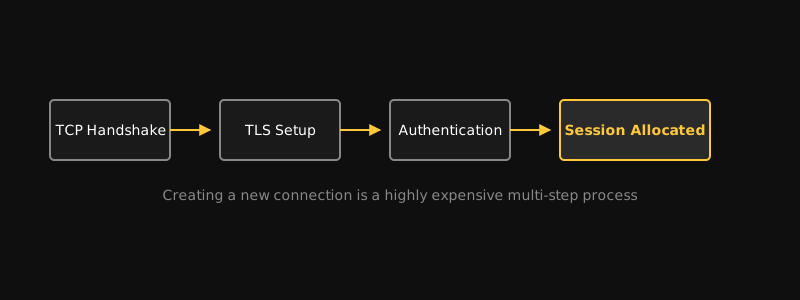
এই পুরো প্রক্রিয়াটি অত্যন্ত সময়সাপেক্ষ এবং resource-intensive। প্রতিটি request-এর জন্য যদি অ্যাপ্লিকেশনকে এই পুরো সাইকেলটি পার হতে হয়, তবে application-এর latency মারাত্মক হারে বেড়ে যাবে।
Pool ছাড়া Architecture-এর সমস্যা
প্রথমে কল্পনা করুন একটি naive architecture, যেখানে কোনো Connection Pool নেই। প্রতিটি incoming request ডাটাবেজে কথা বলার জন্য সম্পূর্ণ নতুন একটি Connection তৈরি করছে।
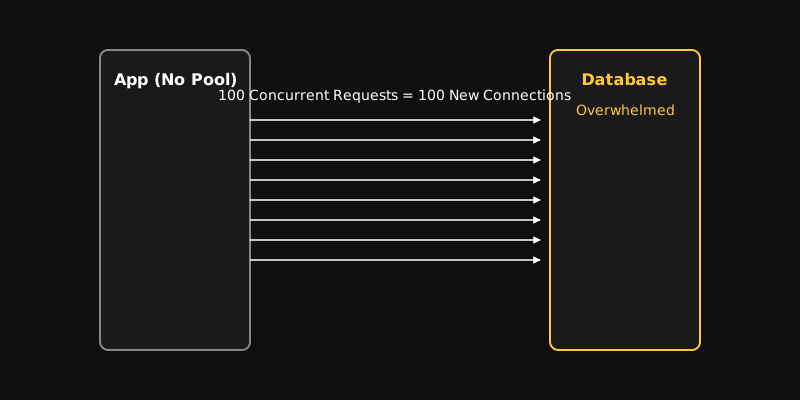
যখন ট্রাফিক কম থাকে, তখন এটি ঠিকঠাক কাজ করে। কিন্তু ট্রাফিক বাড়ার সঙ্গে সঙ্গে Connection তৈরির সংখ্যাও জ্যামিতিক হারে বাড়তে থাকে। কয়েকশ বা কয়েক হাজার concurrent request এলে Database-এর ওপর query execution-এর চেয়ে Connection creation-এর pressure অনেক বেশি পড়ে যায়। একপর্যায়ে ডাটাবেজ নতুন Connection নেওয়া বন্ধ করে দেয় এবং application crash করে।
Connection Pool-এর মূল Idea
উপরের সমস্যাটি সমাধানের জন্যই Connection Pool-এর জন্ম। Connection Pool মূলত আগে থেকে কিছু Database Connection তৈরি করে রাখে। এটি একটি shared reusable resource manager হিসেবে কাজ করে।
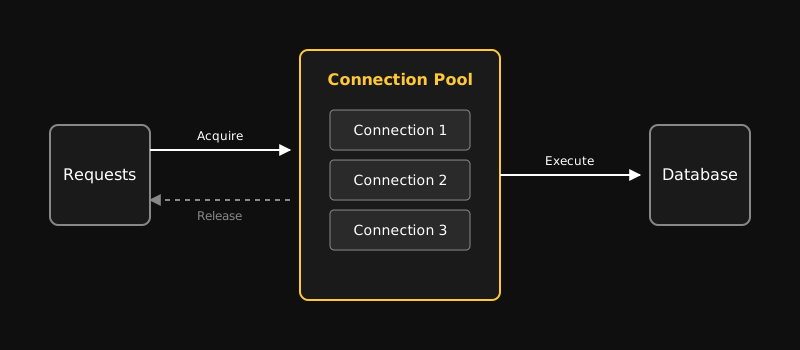
কোনো request-এর যখন Database access প্রয়োজন হয়, তখন সে নতুন Connection তৈরি না করে Pool থেকে একটি existing Connection ধার নেয়। ডাটাবেজের কাজ শেষ হলে request সেই Connection-টি destroy না করে আবার Pool-এ ফেরত দেয়। ফলে একটিমাত্র Connection সারাদিনে হাজার হাজার request sequentially প্রসেস করতে পারে।
এখানে একটি চমৎকার Analogy দেওয়া যেতে পারে। ধরুন আপনি একটি লাইব্রেরিতে গেছেন। লাইব্রেরিতে পড়ার জন্য ১০টি চেয়ার আছে। আপনি একটি চেয়ারে বসে পড়লেন। পড়া শেষ হলে আপনি চেয়ারটি ভেঙে ফেলেন না, বরং চেয়ারটি ছেড়ে দেন যাতে অন্য কেউ বসতে পারে। Connection Pool ঠিক এভাবেই কাজ করে।
Pool-এর ভিতরের Architecture
একটি real-world Connection Pool-এর internal state বেশ জটিল হতে পারে। Pool মূলত চার ধরনের state manage করে: min connections, max connections, idle connections, এবং active connections।
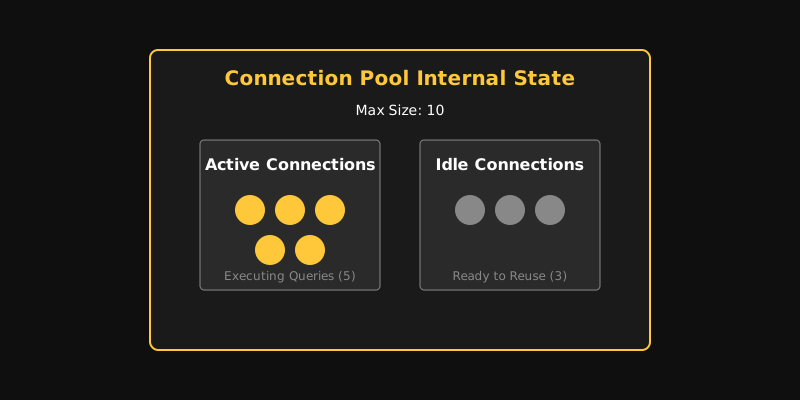
Pool শুধু Connection জমিয়ে রাখে না, এটি Connection allocation এবং release-এর lifecycle নিঁখুতভাবে পরিচালনা করে। এর মধ্যে সবচেয়ে গুরুত্বপূর্ণ parameter হচ্ছে max connections, যা নির্ধারণ করে আপনার application একই সঙ্গে সর্বোচ্চ কতগুলো ডাটাবেজ অপারেশন চালাতে পারবে।
Connection Acquire এবং Hidden Queue
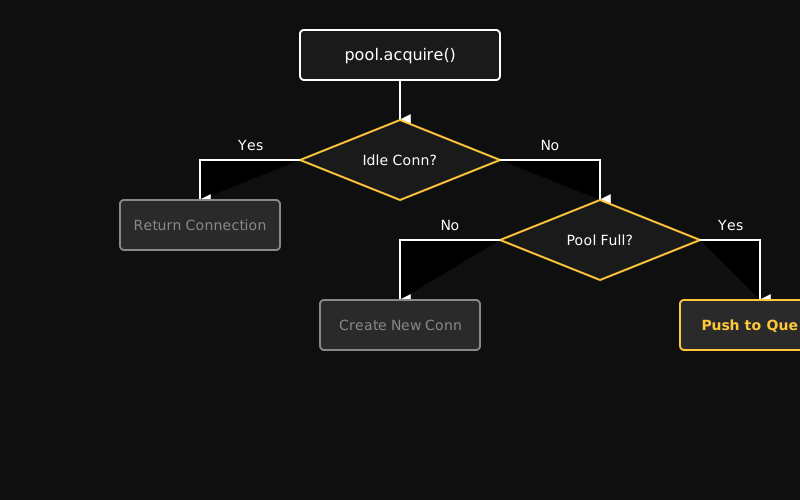
যখন কোনো request ডাটাবেজে কথা বলতে চায়, তখন সে প্রথমে Pool-এর কাছে Connection চায় (pool.acquire())। Pool চেক করে তার কাছে কোনো Idle Connection আছে কি না। থাকলে সেটি সাথে সাথে request-কে দিয়ে দেওয়া হয়।
যদি কোনো Idle Connection না থাকে, তখন Pool দেখে নতুন Connection তৈরি করার capacity (অর্থাৎ max connections লিমিট ক্রস করেছে কি না) আছে কি না। Capacity থাকলে নতুন Connection তৈরি হয়। কিন্তু যদি Capacity শেষ হয়ে যায়, তখন request-টি একটি hidden waiting queue-তে চলে যায়।
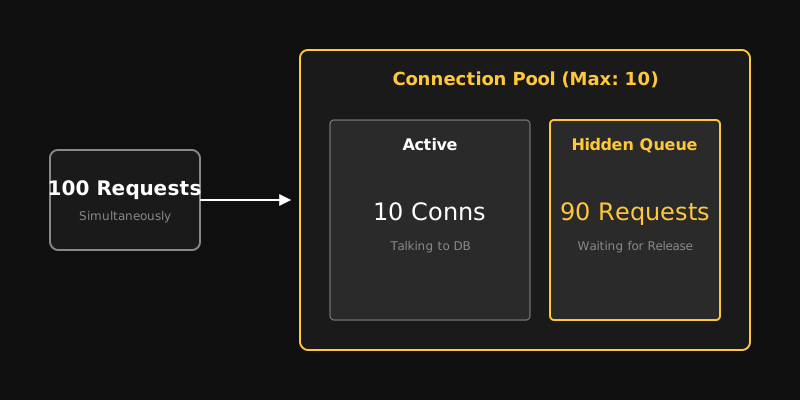
এই queue-টিই হাই-ট্রাফিক সিস্টেমে latency-এর মূল কারণ হয়ে দাঁড়ায়। যখন ১০০টি রিকোয়েস্ট একই সঙ্গে আসে এবং পুলের সাইজ মাত্র ১০, তখন ৯০টি রিকোয়েস্ট লাইনে দাঁড়িয়ে থাকে।
Tip
Queue-তে request বেশিক্ষণ আটকে থাকলে API response slow হয়ে যায়। তাই observability টুলে সব সময় Pool-এর waiting queue সাইজ এবং acquisition latency মনিটর করবেন।
Connection Release বনাম Close
Query শেষ হওয়ার পর Connection সাধারণত close() করা হয় না, বরং release() করা হয়। এর মানে হলো Connection-টি ডাটাবেজ থেকে সম্পূর্ণ বিচ্ছিন্ন না হয়ে আবার Pool-এর Idle state-এ ফিরে যায়।
ডেভেলপারদের জন্য এটি একটি অত্যন্ত গুরুত্বপূর্ণ কনসেপ্ট। কোডে কোনো exception ঘটলে Connection যদি ঠিকমতো release না হয়, তবে সেটি Pool থেকে চিরতরে হারিয়ে যায় (যাকে আমরা Connection Leak বলি)।
const connection = await pool.acquire();
try {  await connection.query('SELECT * FROM users');} finally {  // Error ঘটলেও Connection অবশ্যই Pool-এ ফেরত যাবে  connection.release();}
Wait Time বনাম Query Time
একটি request-এর total Database latency মূলত কয়েকটি অংশের যোগফল। ধরুন আপনার একটি request ডাটাবেজ থেকে ডেটা আনতে ৮৩০ মিলি সেকেন্ড সময় নিল। আপনি হয়তো ভাবছেন আপনার query খুব slow।
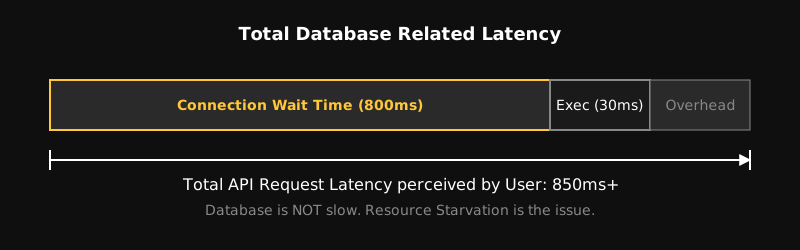
কিন্তু গভীরভাবে ব্রেকডাউন করলে দেখা যেতে পারে, Connection পাওয়ার জন্য request-টি Pool-এর queue-তে ৮০০ মিলি সেকেন্ড অপেক্ষা করেছে, আর query execute হতে সময় লেগেছে মাত্র ৩০ মিলি সেকেন্ড। ব্যবহারকারীর কাছে পুরো বিষয়টা slow মনে হলেও, ডাটাবেজ এখানে কোনোভাবেই স্লো নয়। সমস্যাটি হলো resource starvation।
Warning
Production-এ শুধু query execution latency দেখলে আসল bottleneck মিস হওয়ার তীব্র সম্ভাবনা থাকে। সর্বদা Connection Wait Time আলাদাভাবে পরিমাপ করবেন।
কেন বড় Pool মানেই ভালো Performance নয়?
অনেকেই ভাবেন Pool size ১০ থেকে বাড়িয়ে ১০০ বা ৫০০ করে দিলে application স্বয়ংক্রিয়ভাবে অনেক ফাস্ট হয়ে যাবে। কিন্তু বাস্তবতা সম্পূর্ণ ভিন্ন।
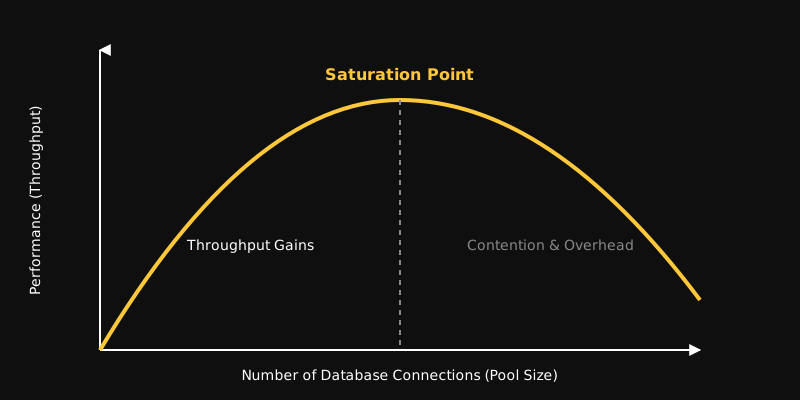
বেশি Connection মানে ডাটাবেজে বেশি concurrent কাজ যাওয়া। প্রতিটি concurrent কাজের জন্য ডাটাবেজকে CPU time, Memory, Locks এবং Disk I/O শেয়ার করতে হয়। যখন concurrent কাজের সংখ্যা ডাটাবেজের প্রসেসিং ক্ষমতার (Saturation Point) বাইরে চলে যায়, তখন internal contention এবং context switching-এর কারণে সামগ্রিক পারফরম্যান্স মারাত্মকভাবে কমে যায়।
Multi-Instance Production Trap
Local development environment-এ একটি মাত্র application instance চলে এবং সেখানে Pool size ২০ থাকলে সবকিছু একদম পারফেক্ট মনে হয়। কিন্তু production-এ যখন আপনি application horizontally scale করেন, তখন সমীকরণ বদলে যায়।

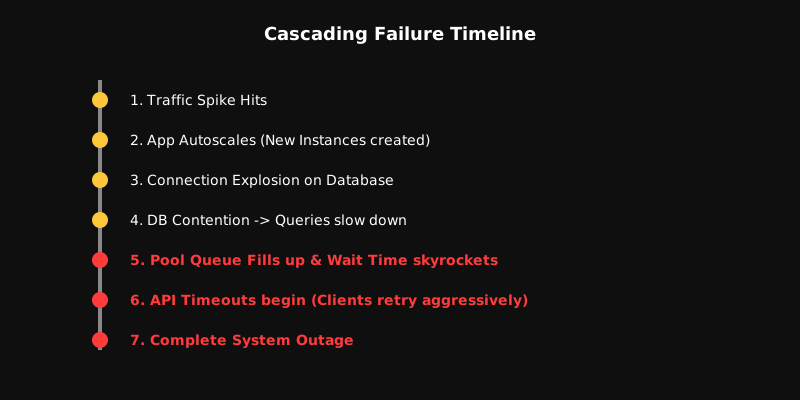
ধরুন production-এ আপনার ২০টি instance চলছে। প্রত্যেকটি instance-এর Pool size যদি ২০ হয়, তাহলে ডাটাবেজের দিকে theoretical maximum কানেকশন সংখ্যা দাঁড়ায় ৪০০ (২০ x ২০)। Kubernetes-এর মতো সিস্টেমে autoscaling চালু থাকলে ট্রাফিক বাড়ার সঙ্গে সঙ্গে instance সংখ্যা বাড়ে এবং ডাটাবেজ কানেকশন জ্যামিতিক হারে বাড়তে থাকে। Application খুব সহজে scale করা গেলেও Database সেভাবে scale হতে পারে না।
Database-side Connection-এর Cost
Application-side Pool বোঝার পর এবার ডাটাবেজের দৃষ্টিকোণ থেকে বিষয়টি দেখা যাক। PostgreSQL প্রতিটি Connection-এর জন্য আলাদা OS process fork করে এবং session-related memory context ও temporary tables মেইনটেইন করে।
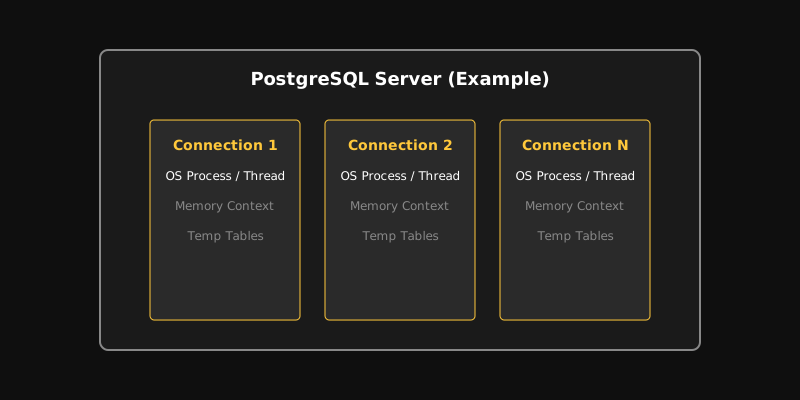
এর মানে হলো Connection count বাড়লে শুধু নেটওয়ার্ক ট্রাফিকই বাড়ে না, ডাটাবেজের নিজস্ব মেমোরি এবং প্রসেসিং পাওয়ারও খরচ হতে থাকে। কানেকশনের সংখ্যা খুব বেশি হলে ডাটাবেজ query প্রসেস করার চেয়ে কানেকশন হ্যান্ডেল করতেই বেশি ব্যস্ত হয়ে পড়ে।
Pool Exhaustion এবং Cascading Failure
Pool exhaustion তখন ঘটে যখন Pool-এর সব Connection ব্যস্ত থাকে এবং নতুন request-এর জন্য কোনো Connection খালি থাকে না। এই অবস্থায় নতুন request-গুলো queue-তে জমা হতে শুরু করে।
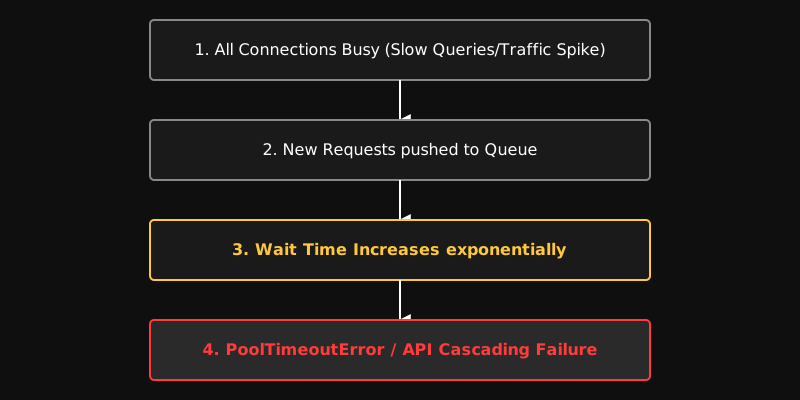
Queue যত বড় হয়, Connection পাওয়ার জন্য অপেক্ষার সময় তত বাড়তে থাকে। একপর্যায়ে Pool timeout হয়ে যায় এবং request ফেইল করে। যদি কোনো কারণে একটি স্লো কোয়েরি ডাটাবেজে চলতে থাকে, তবে সেটি কানেকশন ধরে রাখে। ফলে অন্য unrelated ফাস্ট কোয়েরিগুলোও কানেকশন না পেয়ে আটকে যায়।
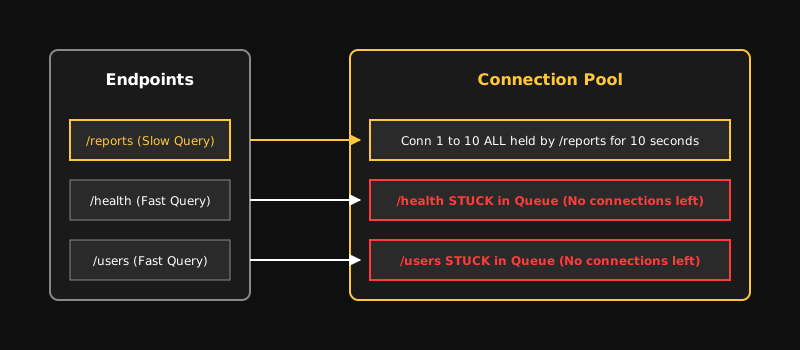
Error
Pool Leak ও Cascading Failure: Connection acquire করার পর finally ব্লকে release না করলে Pool ধীরে ধীরে মরে যায়। প্রথমদিকে সব ঠিক মনে হলেও কিছু সময় পর সিস্টেম পুরোপুরি স্তব্ধ হয়ে যেতে পারে।
Transactions এবং Connection Affinity
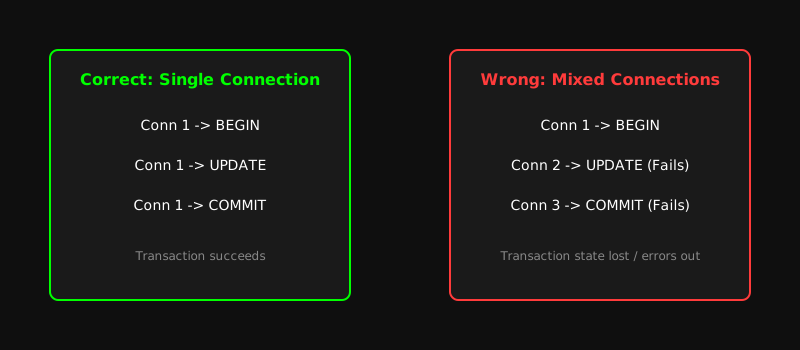
সাধারণ query-এর চেয়ে Transaction ডাটাবেজ কানেকশনের ওপর অনেক বেশি চাপ তৈরি করে। Transaction শুরু হলে (BEGIN) সেটি শেষ না হওয়া পর্যন্ত (COMMIT বা ROLLBACK) পুরো সময় একই Connection ধরে রাখতে হয়।
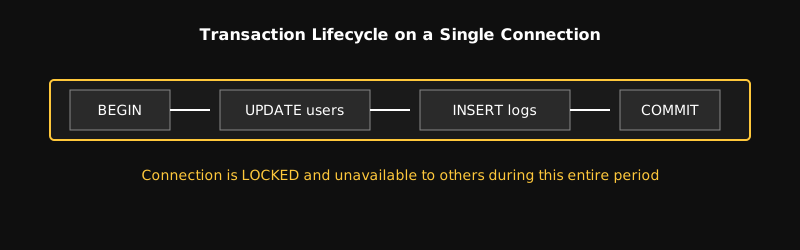
Transaction যতক্ষণ ওপেন থাকে, সেই Connection-টি অন্য কোনো request-এর জন্য available থাকে না। একে বলা হয় Connection Affinity। আপনি যদি BEGIN একটি কানেকশনে এবং COMMIT অন্য একটি কানেকশনে পাঠান, তবে transaction semantics পুরোপুরি ভেঙে যাবে।
Timeouts এবং Connection Lifecycle
প্রোডাকশন সিস্টেমে Timeout ম্যানেজমেন্ট অত্যন্ত ক্রিটিক্যাল একটি বিষয়। সবগুলো টাইমআউট এক জিনিস নয় এবং এদের মধ্যে একটি পরিষ্কার হায়ারার্কি থাকতে হবে।
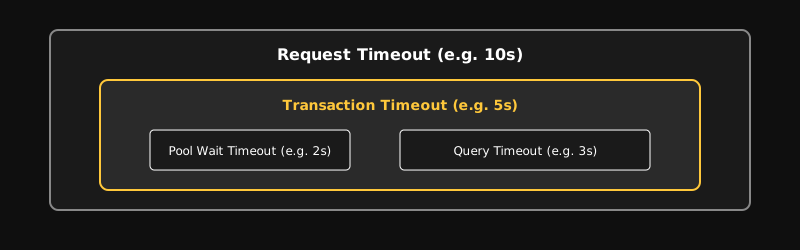
- Request Timeout: ক্লায়েন্ট বা গেটওয়ে রিকোয়েস্টের জন্য সর্বোচ্চ কতক্ষণ অপেক্ষা করবে।
- Transaction Timeout: একটি ডাটাবেজ ট্রানজ্যাকশন সর্বোচ্চ কতক্ষণ ওপেন থাকতে পারবে।
- Pool Wait Timeout: একটি রিকোয়েস্ট পুল থেকে কানেকশন পাওয়ার জন্য সর্বোচ্চ কতক্ষণ অপেক্ষা করবে।
- Query Timeout: একটি সিঙ্গেল কোয়েরি ডাটাবেজে সর্বোচ্চ কতক্ষণ চলতে পারবে।
তাছাড়া একটি কানেকশন চিরকাল বেঁচে থাকে না। নেটওয়ার্ক ফেইলিওর বা ডাটাবেজ রিস্টার্টের কারণে কানেকশন ড্রপ হতে পারে। Pool-কে নিয়মিত idle connection চেক করতে হয় (Health check যেমন SELECT 1) এবং stale connection ডিসকার্ড করে নতুন কানেকশন তৈরি করতে হয়।

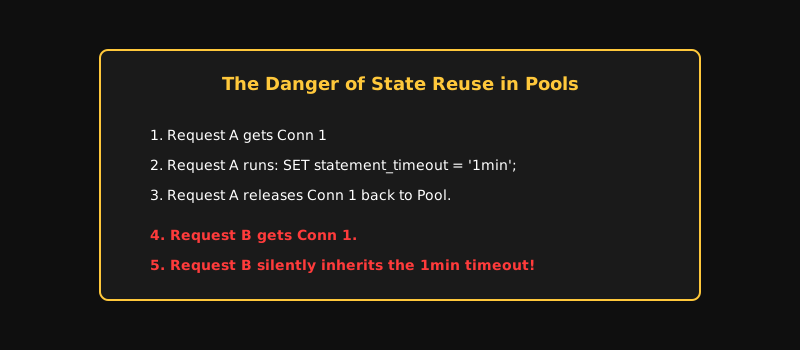
একটি Connection এক request থেকে অন্য request-এ reuse হওয়ার সময় আগের সেশনের স্টেট (যেমন SET statement_timeout বা temporary tables) পরের request-কে প্রভাবিত করতে পারে, যা প্রোডাকশনে নীরব বাগ তৈরি করে।
Info
কানেকশন পুনরায় ব্যবহারের আগে নিশ্চিত করুন যে সেশন ভ্যারিয়েবল এবং স্টেট সম্পূর্ণ রিসেট (DISCARD ALL / RESET ALL) করা হয়েছে।
PgBouncer এবং Serverless Architecture
বড় স্কেলের প্রোডাকশন সিস্টেমে শুধু Application-side Pool যথেষ্ট নয়। PostgreSQL-এর ক্ষেত্রে PgBouncer-এর মতো এক্সটার্নাল কানেকশন পুলার ব্যবহার করা হয়। এটি ডাটাবেজের সামনে একটি সেন্ট্রাল প্রক্সি লেয়ার হিসেবে কাজ করে এবং হাজার হাজার অ্যাপ্লিকেশন কানেকশনকে অল্প কয়েকটি ডাটাবেজ কানেকশনে multiplex করে দেয়।

Serverless আর্কিটেকচারে (যেমন AWS Lambda) বিষয়টি আরও সংকটজনক। সেখানে ট্রাফিক স্পাইক হলে শত শত short-lived execution instance তৈরি হয়। প্রত্যেকে নিজস্ব কানেকশন তৈরি করতে চাইলে Database Connection সাথে সাথে explode করে ক্র্যাশ করে।

Connection Storm এবং Retries
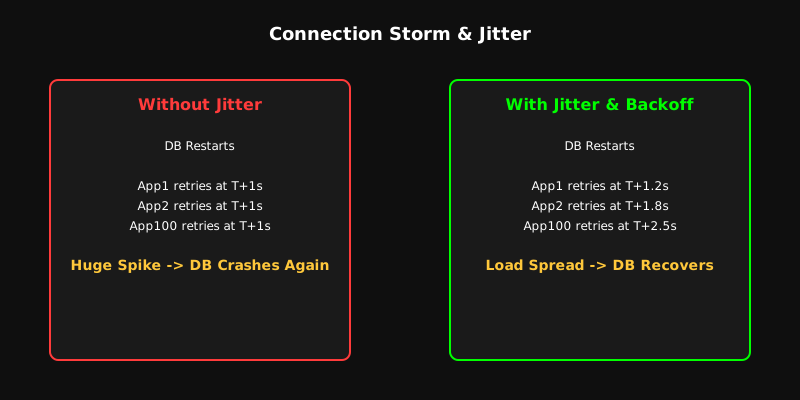
ধরুন কোনো কারণে আপনার ডাটাবেজ ১০ সেকেন্ডের জন্য রিস্টার্ট নিল। অ্যাপ্লিকেশন ইনস্ট্যান্সগুলো কানেকশন হারায়। ডাটাবেজ ফিরে আসার সাথে সাথে সবগুলো ইনস্ট্যান্স যদি হুট করে রি-কানেক্ট করার চেষ্টা করে, তবে ডাটাবেজের ওপর যে বিশাল ধাক্কাটি আসে তাকে Connection Storm বলে।
Exponential Backoff এবং Jitter ব্যবহার করে রিট্রাইগুলোকে সময়ের মধ্যে ছড়িয়ে দিলে ডাটাবেজ নিরাপদে রিকভার করতে পারে।
তাছাড়া ডাটাবেজ স্লো থাকলে অ্যাপ্লিকেশন যদি ক্রমাগত আগ্রাসী রিট্রাই পাঠাতে থাকে, তবে ডাটাবেজে কাজের চাপ আরও বেড়ে যায় এবং সিস্টেম একটি মারাত্মক ফিডব্যাক লুপে আটকা পড়ে।

Production Observability এবং Debugging
প্রোডাকশন সিস্টেমে সমস্যা খুঁজে বের করার জন্য শুধু query latency দেখলে চলবে না। আপনাকে পরিমাপ করতে হবে Pool কতটা ব্যস্ত, কতগুলো request কানেকশনের জন্য অপেক্ষা করছে এবং acquisition latency কত।
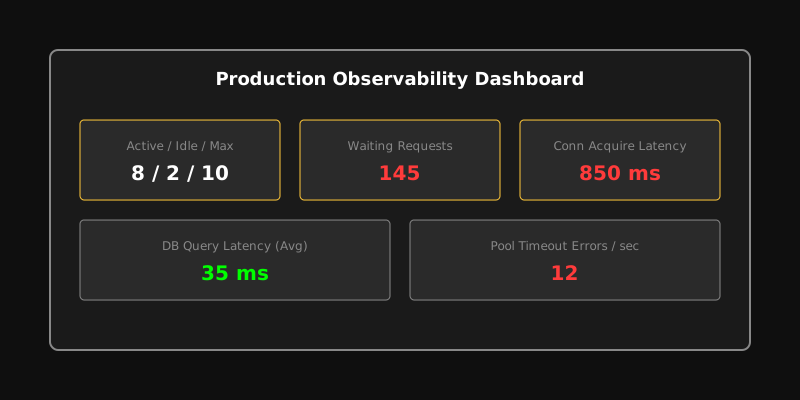
ডিবাগিংয়ের সময় অনুমান না করে নিচের ট্রায়াজ ট্রি অনুযায়ী ইনভেস্টিগেশন করুন:

Queueing Theory দিয়ে Capacity বোঝা
Connection Pool-এর সাইজ অনুমান করে নির্ধারণ করার বিষয় নয়। Little's Law ব্যবহার করে এর একটি গাণিতিক ধারণা পাওয়া যায়:
যদি আপনার সিস্টেমে সেকেন্ডে ৫০০ রিকোয়েস্ট আসে এবং প্রতিটি কানেকশন গড়ে ০.১ সেকেন্ড (১০০ মিলি সেকেন্ড) ব্যস্ত থাকে, তাহলে আপনার প্রয়োজনীয় কনকারেন্সি হবে: টি কানেকশন।
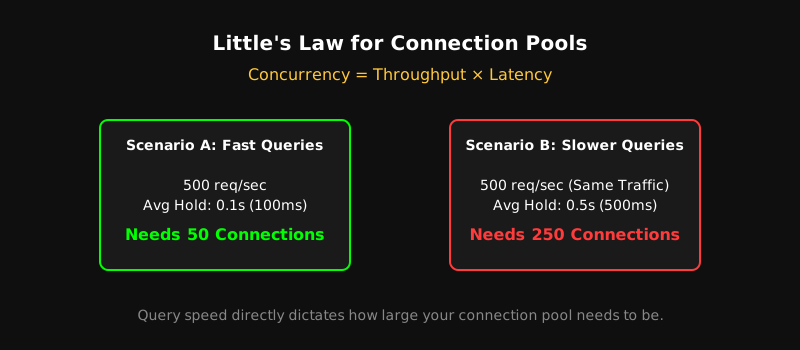
কোয়েরি বা ট্রানজ্যাকশন ডিউরেশন বেড়ে গেলে একই ট্রাফিক হ্যান্ডেল করতে জ্যামিতিক হারে বেশি কানেকশন প্রয়োজন হয়।
Balanced Production Architecture
সবগুলো কনসেপ্ট একত্রিত করলে আমরা একটি প্রোডাকশন-রেডি ব্যালেন্সড আর্কিটেকচার পাই। এখানে মাল্টিপল অ্যাপ্লিকেশন ইনস্ট্যান্স থাকবে, প্রত্যেকটির নিজস্ব বাউন্ডেড কানেকশন পুল থাকবে। মাঝখানে PgBouncer-এর মতো সেন্ট্রাল পুলার থাকবে, এবং ডাটাবেজের কানেকশন ক্যাপাসিটি কঠোরভাবে নিয়ন্ত্রিত থাকবে।

ইনসিডেন্টের সময় যাতে পুরো সিস্টেম ক্র্যাশ না করে, সেজন্য প্রতিটি লেয়ারে টাইমআউট, রিট্রাই উইথ জিটার এবং সার্কিট ব্রেকার পলিসি কার্যকর থাকতে হয়।
Final Developer Checklist
পুলের সাইজ নির্ধারণ এবং সিস্টেম স্থিতিশীল রাখার জন্য একটি ফ্রেমওয়ার্ক এবং চেকলিস্ট মেনে চলা উচিত:

pool.maxনির্ধারণের আগে মোট Application Instance count হিসাব করুন।- Connection acquisition latency এবং Pool waiting queue নিয়মিত ড্যাশবোর্ডে মনিটর করুন।
- ডাটাবেজের কাজ শেষ হওয়ামাত্র
finallyব্লকে কানেকশনrelease()করা নিশ্চিত করুন। - ট্রানজ্যাকশন যত ছোট রাখা যায় তত ভালো। এক্সটার্নাল API call কখনোই ডাটাবেজ ট্রানজ্যাকশনের ভেতরে রাখবেন না।
- Pool timeout, query timeout, এবং request timeout আলাদাভাবে কনফিগার করুন।
- Serverless ইনভায়রনমেন্ট হলে PgBouncer বা RDS Proxy ব্যবহার নিশ্চিত করুন।
- ডাটাবেজ রিস্টার্ট বা নেটওয়ার্ক ফেইলিওরের কথা মাথায় রেখে Exponential Backoff ও Jitter সহ Reconnect স্ট্র্যাটেজি রাখুন।
The Ultimate Mental Model
Connection Pool-কে শুধু "কানেকশন রিউজ করার টুল" ভাবলে ভুল হবে। এটি মূলত আপনার অ্যাপ্লিকেশন এবং ডাটাবেজের মাঝখানে একটি Concurrency Control Layer। এটি নিয়ন্ত্রণ করে ঠিক কতগুলো অপারেশন একই সঙ্গে ডাটাবেজের ওপর চাপ প্রয়োগ করতে পারবে।

ডাটাবেজ কানেকশন একটি অত্যন্ত সীমিত সম্পদ। এর সঠিক স্থাপত্য ও ব্যবস্থাপনা ছাড়া কোনো অ্যাপ্লিকেশনই প্রোডাকশনে সফলভাবে স্কেল করতে পারে না।