How Cursor Pagination Actually Works Under the Hood
On this page
প্রথমেই এমন একটি পরিচিত Engineering scenario চিন্তা করুন যেখানে আপনার API ডিজাইন এবং Database query একদম নিখুঁত মনে হচ্ছে। আপনার posts টেবিলে ৫০ মিলিয়ন (50,000,000) records আছে। আপনি যখন প্রথম পেজ লোড করছেন, তখন Database খুব দ্রুত মাত্র ২ মিলি-সেকেন্ডে ২০টি row রিটার্ন করছে।
SELECT *FROM postsORDER BY created_at DESCLIMIT 20 OFFSET 0;এই query প্রথম দিকে দুর্দান্ত পারফর্ম করে। কিন্তু সমস্যা শুরু হয় যখন আপনার কোনো User বা Automated Crawler অনেক দূরের কোনো পেজে যাওয়ার চেষ্টা করে।
SELECT *FROM postsORDER BY created_at DESCLIMIT 20 OFFSET 1000000;হঠাৎ করেই API-এর latency হু হু করে বাড়তে শুরু করে। Database CPU usage ১০০%-এ পৌঁছে যায় এবং একের পর এক রিকোয়েস্ট timeout হতে থাকে। আপনার মনে স্বাভাবিকভাবেই প্রশ্ন আসতে পারে, API তো মাত্র ২০টি row রিটার্ন করছে, তাহলে পেজ নাম্বার বাড়ার সঙ্গে সঙ্গে query এত slow হচ্ছে কেন? এখানে LIMIT 20 হওয়া সত্ত্বেও Database কেন এত বেশি কাজ করছে এবং Index থাকার পরেও কেন deep pagination এত expensive হতে পারে, সেটি বোঝা অত্যন্ত জরুরি।
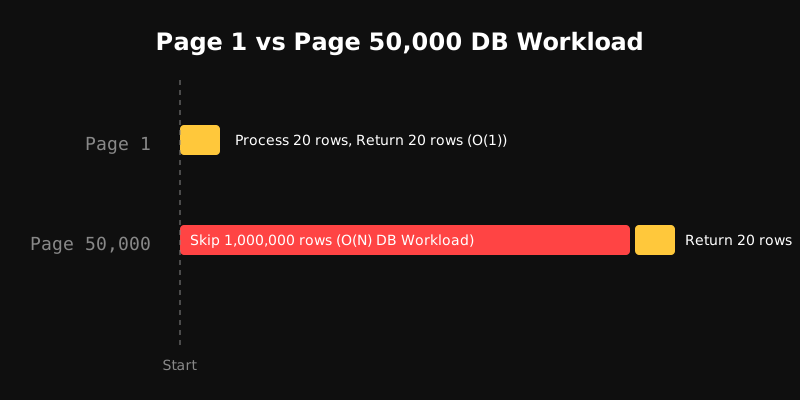
এই পারফরম্যান্স ইনসিডেন্ট থেকেই আমরা Database-এর ভেতরে ঢুকে investigate করব এবং দেখব Cursor Pagination কীভাবে এই সমস্যার সমাধান করে।
Pagination আসলে কোন Problem Solve করছে
Pagination-কে শুধুমাত্র একটি Frontend UI feature হিসেবে দেখলে এর মূল Engineering গুরুত্বটি হারিয়ে যায়। এটিকে মূলত Database এবং API scalability boundary হিসেবে দেখতে হবে। ধরুন আপনার সিস্টেমে ৫০,০০০,০০০ রেকর্ডস আছে। আপনি যদি একবারে সব data রিটার্ন করতে চান, তবে তিনটি বড় সংকট তৈরি হবে:
- Database Memory ও I/O Saturation: সম্পূর্ণ টেবিল মেমোরিতে লোড করতে গিয়ে Database-এর buffer pool নিঃশেষ হয়ে যাবে।
- Network Bandwidth Choke: গিগাবাইট সাইজের JSON payload ট্রান্সফার করতে গিয়ে নেটওয়ার্ক পাইপলাইন জ্যাম হয়ে যাবে।
- Client-side Browser Crash: ক্লায়েন্টের ব্রাউজার বা মোবাইল অ্যাপ এত বড় DOM/মেমোরি হ্যান্ডেল করতে না পেরে ফ্রিজ হয়ে যাবে।
এর বদলে আমরা পুরো dataset-কে ছোট ছোট ভাগে ভাগ করে রিটার্ন করি। Pagination-এর আসল লক্ষ্য হচ্ছে Database-এর bounded amount of work এবং API response-এর bounded size নিশ্চিত করা। যখন আমরা ২০টি রেকর্ডস রিটার্ন করার সিদ্ধান্ত নিই, তখন প্রশ্ন আসে "কোন ২০টি রেকর্ডস?"। এই প্রশ্নের উত্তর থেকেই Offset এবং Cursor-এর মতো স্ট্র্যাটেজি তৈরি হয়।
Offset Pagination-এর Mental Model
প্রথমে আমরা সেই মডেল নিয়ে কথা বলব যার সঙ্গে আমরা সবাই সবচেয়ে বেশি পরিচিত। Offset pagination-এর ক্ষেত্রে আমরা Database-কে বলি ঠিক কতগুলো row skip করতে হবে।
SELECT *FROM postsORDER BY created_at DESCLIMIT 20 OFFSET 10000;অনেকেই ভাবেন OFFSET 10000 মানে হচ্ছে Database সরাসরি ১০,০০০ নম্বর row-তে জাম্প বা teleport করে চলে যায়। কিন্তু বাস্তবে রিলেশনাল ডাটাবেজ এভাবে কাজ করে না।
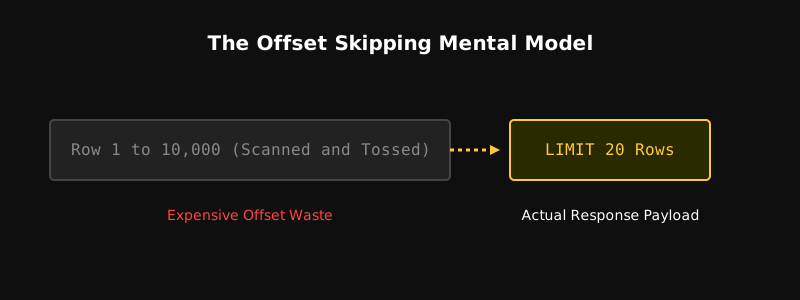
বাস্তবে Database-কে ordered result-এর মধ্যে আগের ১০,০০০টি row একটি একটি করে স্ক্যান করতে হয়, মেমোরিতে এনে কাউন্ট করতে হয় এবং ফেলে দিতে হয় (discard)। এরপর ১০,০০১ নম্বর row থেকে শুরু করে LIMIT 20 অনুযায়ী পরবর্তী ২০টি রেকর্ডস রিটার্ন করতে হয়। অর্থাৎ ২০টি row পাওয়ার জন্য Database-কে আসলে ১০,০২০টি row প্রসেস করতে হয়েছে।
LIMIT আর OFFSET আসলে কীভাবে আলাদা
এই জায়গায় একটি অত্যন্ত গুরুত্বপূর্ণ mental model তৈরি করা প্রয়োজন। LIMIT এবং OFFSET সম্পূর্ণ ভিন্ন দুটি নির্দেশ দেয়।
LIMITDatabase-কে বলে: "সর্বোচ্চ কতগুলো row ক্লায়েন্টকে রিটার্ন করব?"OFFSETDatabase-কে বলে: "শুরুর আগে কতগুলো valid row পার হয়ে আসতে হবে?"
যখন আপনি OFFSET 0, OFFSET 100, এবং OFFSET 1,000,000 ব্যবহার করেন, তখন returned row count প্রতিবারই ২০ হলেও Database-এর কাজের পরিমাণ একদমই এক থাকে না। OFFSET যত বাড়বে, Database-কে তত বেশি row স্ক্যান করে মেমোরি থেকে ফেলে দিতে হবে, যা query-কে progressively slow করে দেয়।
Database Execution Plan-এর ভিতরে ঢোকা
SQL query শুধু একটি ডিক্লারেটিভ সিনট্যাক্স। Database ইঞ্জিন এটিকে ইন্টারনাল execution plan-এ রূপান্তর করে। PostgreSQL-এ EXPLAIN ANALYZE দিয়ে এর আসল আচরণ লক্ষ্য করা যায়।
EXPLAIN ANALYZESELECT *FROM postsORDER BY created_at DESCLIMIT 20 OFFSET 100000;এই execution plan-এ Query Planner নিচের পাইপলাইন অনুযায়ী কাজ সম্পন্ন করে:
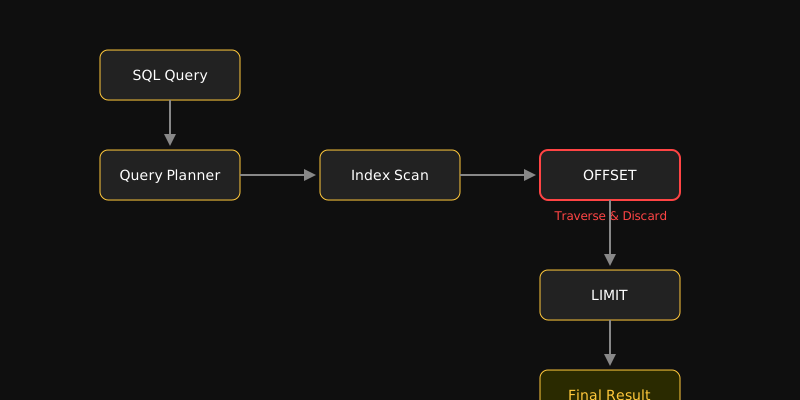
- Access Path Selection: Planner ঠিক করে সে Index Scan করবে নাকি Table Scan করবে।
- Tuple Retrieval: ইন্ডেক্স ধরে ডিস্ক বা বাফার ক্যাশ থেকে ১,০০,০২০টি tuple পড়ে আনে।
- Traverse and Discard: প্রথম ১,০০,০০০টি tuple মেমোরিতে কাউন্ট করে ডিসকার্ড করে দেয়।
- LIMIT Slice: অবশিষ্ট ২০টি tuple সংগ্রহ করে Final Output তৈরি করে।
আমরা যখন EXPLAIN ANALYZE দেখি, তখন পরিষ্কার ধরা পড়ে যে Database বিপুল পরিমাণ ডিস্ক পেজ মেমোরিতে এনে CPU সাইকেল খরচ করেছে শুধুমাত্র অপ্রয়োজনীয় ডাটা ফেলে দেওয়ার জন্য।
Index থাকলে কি OFFSET Problem শেষ হয়ে যায়
এটি Backend Engineering-এর একটি বহুল প্রচলিত misconception। অনেকেই ভাবেন created_at-এর ওপর Index তৈরি করলেই deep pagination-এর সমস্যা চিরতরে সমাধান হয়ে যাবে।
CREATE INDEX idx_posts_created_atON posts(created_at DESC);Index ব্যবহারের ফলে Database-কে হয়তো পুরো Table sequential scan করতে হয় না, সে সরাসরি Index tree থেকে ordered entries পায়। কিন্তু OFFSET-এর logical requirement কিন্তু শেষ হয়ে যায় না।
Database-কে target position-এ পৌঁছানোর জন্য ইন্ডেক্স লিফ পেজগুলোর মধ্য দিয়ে আগের সবকটি এন্ট্রি traversal করতেই হয়। ফলে Index থাকার পরেও deep OFFSET-এর query execution time লিনিয়ারলি (Linearly) বাড়তে থাকে।
The O(N) Pagination Trap
Index স্ক্যান দ্রুত হলেও Database-কে OFFSET N পৌঁছানোর জন্য N সংখ্যক ইন্ডেক্স এন্ট্রি রিড করতে হয়। তাই Offset-based pagination মূলত O(N) complexity তৈরি করে, যা large dataset-এ catastrophic latency ডেকে আনে।
Deep OFFSET কেন Production Problem হয়ে যায়
এখন একটি realistic production traffic scenario চিন্তা করুন। একজন সাধারণ ব্যবহারকারীর জন্য deep pagination হয়তো কদাচিৎ ঘটবে। কিন্তু যখন Search Engine Bots, Scrapers অথবা হাজার হাজার concurrent users deep page-গুলোতে রিকোয়েস্ট পাঠায়, তখন পরিস্থিতি নিয়ন্ত্রণের বাইরে চলে যায়।
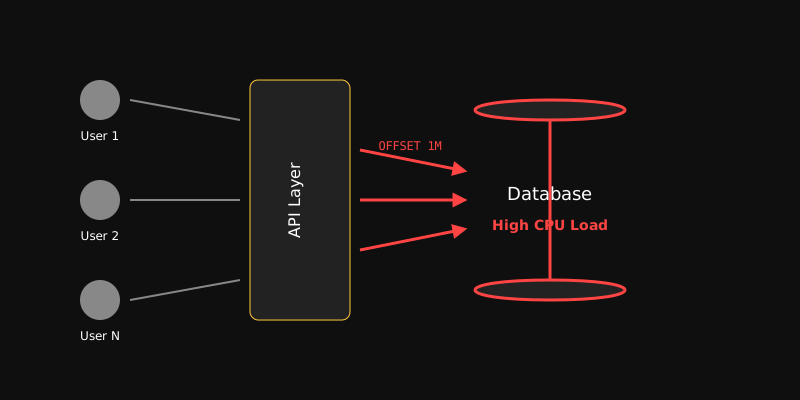
একাধিক ব্যবহারকারীর deep OFFSET রিকোয়েস্ট Database Engine-এর ওপর ক্রমাগত heavy workload তৈরি করে। এর ফলে:
- Database CPU usage ১০০%-এ পৌঁছায়।
- Connection Pool exhausted হয়ে যায়।
- নতুন lightweight রিকোয়েস্টগুলোও কিউতে আটকে যায় (Cascading Latency)।
- ক্লায়েন্ট টাইমআউট ফেস করে অটোমেটিক retry পাঠাতে থাকে, যা সিস্টেমে আরও বেশি লোড তৈরি করে ডেথ স্পাইরাল সৃষ্টি করে।
Cursor Pagination-এর Entry Point
Offset-এর এই fundamental limitation থেকেই জন্ম নেয় Cursor Pagination-এর ধারণা। আমরা যদি Database-কে না বলি কতগুলো row skip করতে হবে, বরং বলি "আমি শেষবার কোথায় ছিলাম", তাহলে ডাটাবেজের কাজের ধরণ সম্পূর্ণ বদলে যায়।
- Offset Approach: "১০,০০০ rows পার হয়ে পরের ২০টা row দিন।" (Database-কে ১০,০২০টা row দেখতে হয়)
- Cursor Approach: "আমি এই নির্দিষ্ট record পর্যন্ত দেখেছি। এর পরের ২০টা row দিন।" (Database সরাসরি সেই পয়েন্ট থেকে শুরু করে মাত্র ২০টি row রিড করে)
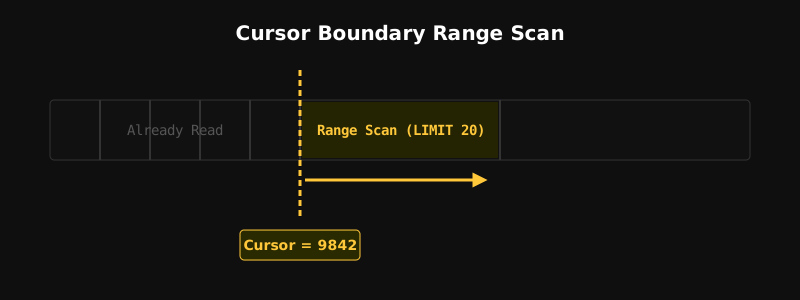
এটাই হচ্ছে Cursor Pagination-এর core architectural transition। ডাটাবেজকে হাজার হাজার রেকর্ডস স্ক্যান ও ডিসকার্ড করানোর বদলে আমরা একটি known boundary বা starting point ধরিয়ে দিই।
Cursor বনাম Database Cursor
এখানে পরিভাষাগত বিভ্রান্তি দূর করা অত্যন্ত গুরুত্বপূর্ণ। API Pagination-এর Cursor আর Database Engine-এর Internal Cursor এক জিনিস নয়।
- API Cursor: এটি একটি stateless token বা state representation, যা পেজিনেশনের বর্তমান পজিশন ধারণ করে ক্লায়েন্ট ও সার্ভারের মধ্যে আদান-প্রদান হয়।
- Database Cursor (PL/pgSQL / SQL Cursor): এটি ডাটাবেজ সার্ভারের মেমোরিতে ওপেন থাকা একটি stateful connection-bound pointer, যা মেমোরি ধরে রাখে এবং দীর্ঘ সময় ওপেন রাখলে কানেকশন পুল নিঃশেষ হয়ে যায়।
আমরা যখন Web Application বা Distributed API ডিজাইন করি, তখন আমরা সবসময় Stateless API Cursor ব্যবহার করি।
Keyset Pagination আসলে কোথায় আসে
Keyset Pagination এবং Cursor Pagination শব্দ দুটি অনেক সময় সমার্থকভাবে ব্যবহৃত হলেও এদের মধ্যে সূক্ষ্ম কাঠামোগত পার্থক্য রয়েছে।
SELECT *FROM postsWHERE id < :lastIdORDER BY id DESCLIMIT 20;Keyset Pagination হলো Database লেভেলের query filtering স্ট্র্যাটেজি, যেখানে ordering column-এর মানকে WHERE ক্লজে বাউন্ডারি হিসেবে ব্যবহার করা হয়। আর Cursor Pagination হলো API লেভেলের ট্রান্সপোর্ট মেকানিজম, যা এই Keyset ভ্যালুগুলোকে একটি সিকিউর এবং এনকোডেড টোকেন হিসেবে ক্লায়েন্টের কাছে পাঠায়।
Stable Ordering কেন Cursor Pagination-এর Core Requirement
Cursor Pagination সফলভাবে কাজ করার জন্য সবচেয়ে মৌলিক শর্ত হলো Deterministic ও Stable Ordering। শুধু একটি non-unique কলাম দিয়ে ORDER BY করলে বিপর্যয় ঘটতে পারে।
ORDER BY created_at DESC;ধরুন তিনটি আলাদা পোস্ট একই সেকেন্ডে (১০:০০:০০) ডাটাবেজে ইনসার্ট হয়েছে। যেহেতু তাদের created_at অভিন্ন, ডাটাবেজ ইঞ্জিনের কাছে এদের অভ্যন্তরীণ কোনো নির্দিষ্ট ক্রম নেই।
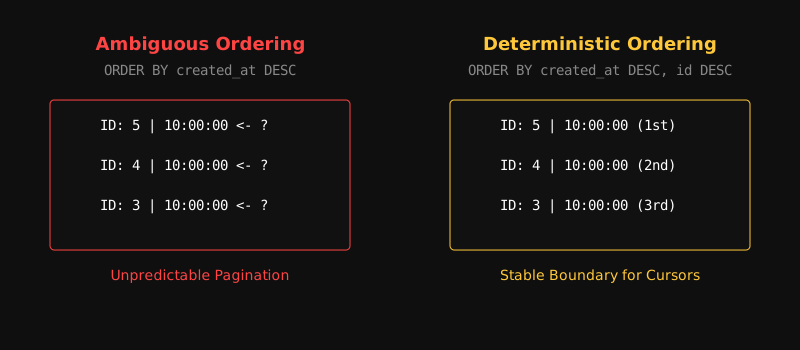
ডাটাবেজ প্রথম পেজে কোন দুটি দেখাবে আর দ্বিতীয় পেজে কোনটি দেখাবে তার কোনো নিশ্চয়তা থাকে না। ফলে কিছু রেকর্ড ডুপ্লিকেট হিসেবে আসতে পারে অথবা চিরতরে বাদ পড়তে পারে। এই সমস্যা সমাধানের জন্য সবসময় একটি Unique কলামকে Tie-Breaker হিসেবে ব্যবহার করতে হয়।
ORDER BY created_at DESC, id DESC;এখানে id গ্যারান্টি দেয় যে প্রতিটি row-এর পজিশন সম্পূর্ণ ইউনিক এবং ডিটারমিনিস্টিক।
Composite Cursor এবং Row Value Comparison
যখন পেজিনেশনে একাধিক কলামের ওপর সর্টিং করা হয় (যেমন created_at এবং id), তখন কার্সরে দুটি মানই অন্তর্ভুক্ত করতে হয়। একে Composite Cursor বলা হয়।
SELECT *FROM postsWHERE (created_at, id) < (:createdAt, :id)ORDER BY created_at DESC, id DESCLIMIT 20;আধুনিক রিলেশনাল ডাটাবেজ (PostgreSQL, MySQL 8+) Row Value Comparison বা Tuple Comparison খুব চমৎকারভাবে সমর্থন করে। ডাটাবেজ প্রথমে created_at তুলনা করে। যদি দুটি রো-এর created_at সমান হয়, শুধুমাত্র তখনই সে id তুলনা করে পরবর্তী রেকর্ডস ফিল্টার করে।
যেসব ডাটাবেজ ইঞ্জিনে Tuple Syntax সাপোর্ট নেই, সেখানে সমতুল্য লজিক এভাবে লেখা হয়:
SELECT *FROM postsWHERE created_at < :createdAt OR (created_at = :createdAt AND id < :id)ORDER BY created_at DESC, id DESCLIMIT 20;Row Value Syntax Support
Row value comparison (A, B) < (X, Y) কোডকে পরিষ্কার রাখে এবং SQL Query Optimizer-কে কম্পোজিট ইন্ডেক্স নিখুঁতভাবে ব্যবহার করার সুযোগ দেয়।
Composite Index কেন এখানে Critical
সঠিক Index ছাড়া Keyset Query চালালে পারফরম্যান্স সুবিধার বদলে টেবিল স্ক্যান শুরু হয়ে যাবে। Cursor Query-এর filtering এবং ordering-এর সঙ্গে সামঞ্জস্য রেখে Composite Index তৈরি করা আবশ্যক।
CREATE INDEX idx_posts_cursorON posts(created_at DESC, id DESC);এই Index থাকার ফলে ডাটাবেজ ইঞ্জিনকে কোনো ডাটা সর্ট করতে হয় না এবং কোনো রো ডিসকার্ড করতে হয় না। ইঞ্জিন সরাসরি ইন্ডেক্স ট্রি থেকে কার্সরের exact boundary পয়েন্টে গিয়ে পরবর্তী ২০টি এন্ট্রি পিক করে নিয়ে আসে।
B-Tree-এর সঙ্গে Cursor Pagination-এর Connection
রিলেশনাল ডাটাবেজের B-Tree ইন্ডেক্স মূলত একটি ব্যালান্সড ট্রি স্ট্রাকচার, যা ডাটাকে সর্বদা সর্টেড অবস্থায় সংরক্ষণ করে।
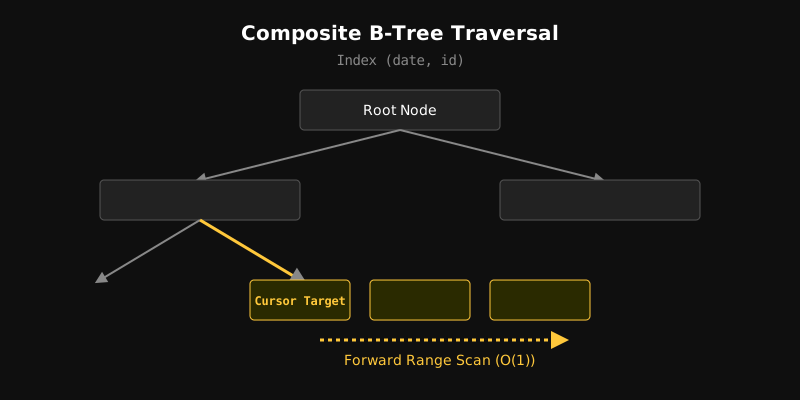
B-Tree ইন্ডেক্সে কার্সর কুয়েরি কীভাবে এক্সিকিউট হয় লক্ষ্য করুন:
- Tree Seek (O(log N)): ডাটাবেজ রুট নোড থেকে বাইনারি সার্চের মতো নেমে কার্সর ভ্যালুর exact Leaf Node খুঁজে বের করে।
- Sequential Leaf Scan (O(K)): লিফ নোডগুলো পরস্পরের সঙ্গে ডাবলি লিঙ্কড লিস্টের মতো যুক্ত থাকে। ডাটাবেজ শুধু সামনের দিকে পয়েন্টার ধরে ঠিক K সংখ্যক (LIMIT) রো পড়ে নেয়।
যেহেতু K এর মান নির্দিষ্ট (যেমন ২০), তাই টেবিলের সাইজ ১০ হাজার হোক বা ১০ কোটি হোক, এই কুয়েরির পারফরম্যান্স সর্বদা ফ্ল্যাট বা O(1) থাকে।
Concurrent INSERT এবং Pagination Drift
Offset Pagination-এর সবচেয়ে মারাত্মক ডাটা কনসিস্টেন্সি সমস্যা হলো Pagination Drift বা Data Shifting।
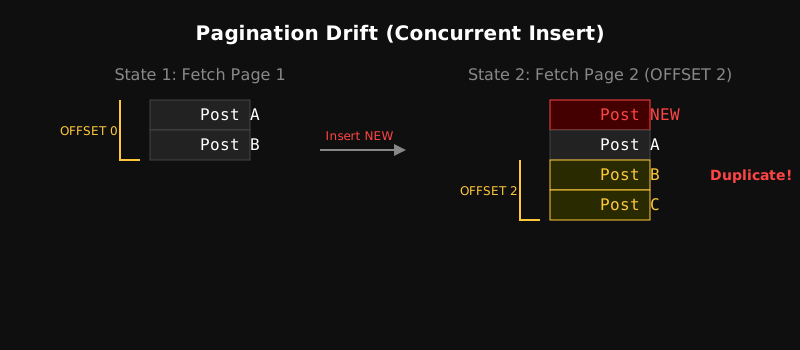
ধরুন একজন ইউজার পেজ ১ লোড করেছেন যেখানে Post A এবং Post B প্রদর্শিত হয়েছে। ঠিক এই মুহূর্তে আরেকজন ইউজার একটি নতুন পোস্ট ইনসার্ট করলেন (Post NEW)।
এখন প্রথম ইউজার যখন পেজ ২ দেখার জন্য LIMIT 2 OFFSET 2 রিকোয়েস্ট পাঠাবেন, ডাটাবেজ নতুন রো যুক্ত হওয়ার কারণে পুরো ডেটাসেট এক ঘর পিছিয়ে দেবে। ফলে ইউজার পেজ ২-এ আবার Post B দেখতে পাবেন (Duplicate Record)। একইভাবে কোনো রো ডিলিট হলে একটি রেকর্ড পুরোপুরি মিস হয়ে যেতে পারে।
Cursor Pagination এই ড্রিফট সমস্যা থেকে সম্পূর্ণ মুক্ত। কারণ এটি কোনো কাল্পনিক রো নাম্বারের ওপর নির্ভর করে না, বরং নির্দিষ্ট ডাটা ভ্যালুর বাউন্ডারি পয়েন্টকে লক করে ডাটা রিড করে।
Immutable বনাম Mutable Ordering
কার্সর পেজিনেশনের জন্য এমন কলাম বাছাই করা উচিত যার মান পরিবর্তনের সম্ভাবনা নেই (যেমন id বা created_at)। কিন্তু আপনি যদি পরিবর্তনশীল কলাম যেমন updated_at দিয়ে সর্ট করেন:
ORDER BY updated_at DESC, id DESC;তখন একটি বিশেষ কনকারেন্সি ফাঁদ তৈরি হতে পারে:
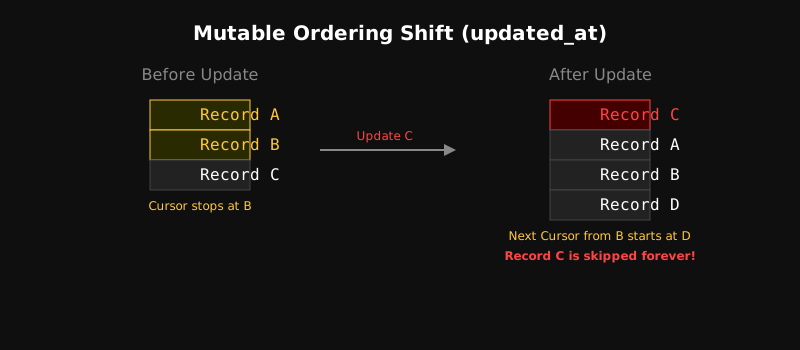
ধরুন ইউজার পেজ ১ রিড করে Record B পর্যন্ত এসেছেন। এই অবস্থায় পেজ ৩-এ থাকা Record C আপডেট হয়ে গেল এবং তার updated_at বেড়ে পেজ ১-এর ওপরে চলে গেল। এখন ইউজার যখন Record B থেকে পরবর্তী পেজ রিড করবেন, ডাটাবেজ B-এর পরবর্তী রেকর্ডস (Record D) রিটার্ন করবে। এর ফলে Record C চিরতরে স্কিপ হয়ে যাবে।
Mutable Column Strategy
পরিবর্তনশীল কলামে পেজিনেশন করতে হলে ক্লায়েন্টকে রিয়েল-টাইম ডাটা সিঙ্ক স্ট্র্যাটেজি অথবা স্ন্যাপশট আইসোলেশন বিবেচনা করতে হবে।
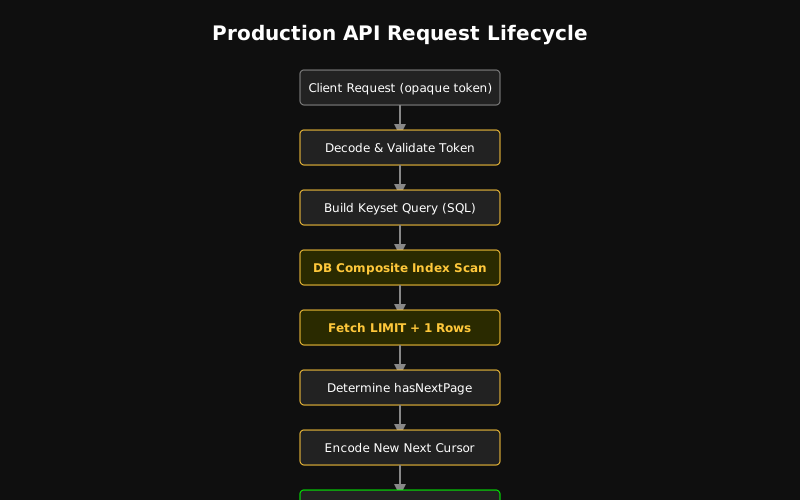
API-তে Cursor কীভাবে কাজ করে (Opaque Cursors)
প্রোডাকশন গ্রেড সিস্টেমে ক্লায়েন্টের কাছে ডাটাবেজের ইন্টারনাল স্কিমা ও কলামের মান সরাসরি প্রকাশ করা অনুচিত।
{ "created_at": "2026-09-06T01:30:00Z", "id": 9842}ক্লায়েন্টকে এই র ডাটা না পাঠিয়ে সার্ভার এটিকে একটি Opaque Token হিসেবে এনকোড করে পাঠায়:
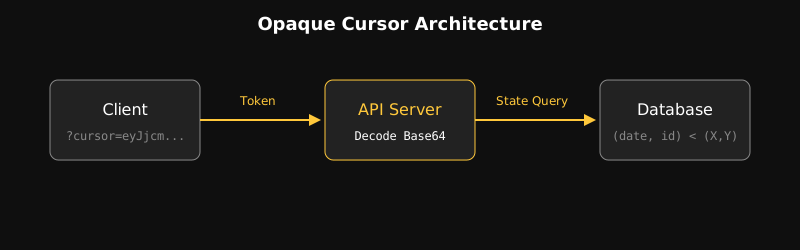
GET /api/v1/posts?cursor=eyJjcmVhdGVkX2F0IjoiMjAyNi0wOS0wNlQwMTozMDowMFoiLCJpZCI6OTg0Mn0=API সার্ভার রিকোয়েস্ট পাওয়ার পর টোকেনটি ডিকোড ও ভ্যালিডেট করে ইন্টারনাল SQL কুয়েরি তৈরি করে। এর ফলে পরবর্তীতে ডাটাবেজ স্কিমা বা পেজিনেশন লজিক পরিবর্তন করলেও পাবলিক API কন্ট্রাক্ট ভেঙে যায় না।
Security Note
Base64 হলো একটি এনকোডিং মেকানিজম, কোনো এনক্রিপশন নয়। টোকেন ডিকোড করলে এর ভেতরের মান যে কেউ দেখতে পারে। টোকেন টেম্পারিং বা সিকিউরিটি রিস্ক এড়াতে HMAC দিয়ে কার্সর সাইন করা অথবা এনক্রিপ্ট করা সর্বোত্তম অভ্যাস।
hasNextPage কীভাবে বের করবেন
ক্লায়েন্টকে জানানোর জন্য যে পরবর্তী পেজ আছে কি না, অনেকে আলাদাভাবে COUNT(*) কুয়েরি চালান। কিন্তু বড় টেবিলে COUNT(*) চালানো অত্যন্ত এক্সপেনসিভ। এর সবচেয়ে স্মার্ট সমাধান হলো LIMIT + 1 Trick।
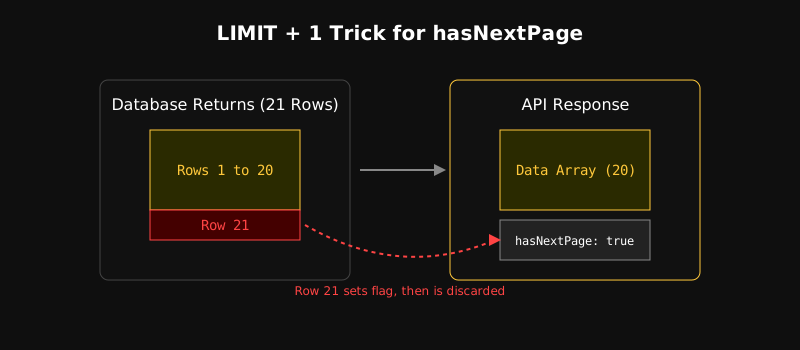
যদি পেজ সাইজ ২০ হয়, তবে ডাটাবেজ থেকে ২১টি রেকর্ডস কুয়েরি করুন (LIMIT 21)।
- যদি ডাটাবেজ ঠিক ২১টি রেকর্ডস রিটার্ন করে, তার মানে এখনও অতিরিক্ত ডাটা অবশিষ্ট আছে (
hasNextPage = true)। সার্ভার ২১তম রেকর্ডটি রেসপন্স থেকে বাদ দিয়ে প্রথম ২০টি রেকর্ড ক্লায়েন্টকে পাঠাবে এবং ২০তম রেকর্ডের ডাটা দিয়েnext_cursorতৈরি করবে। - যদি ডাটাবেজ ২০ বা তার কম রেকর্ডস রিটার্ন করে, তবে
hasNextPage = falseএবংnext_cursor = null।
Forward এবং Backward Pagination
একটি পূর্ণাঙ্গ API-তে ব্যবহারকারীকে শুধু সামনের দিকে নয়, পেছনের পেজেও ফিরে যাওয়ার সুযোগ দিতে হয়।
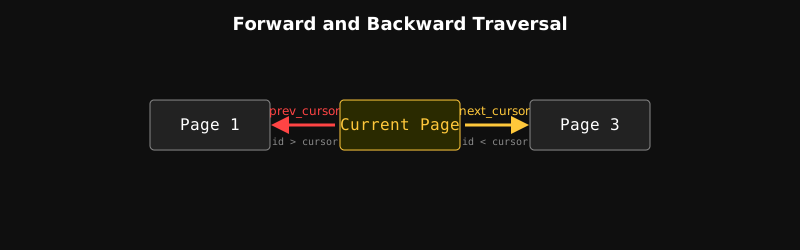
এর জন্য API রেসপন্সে দুটি কার্সর প্রদান করা হয়: next_cursor এবং prev_cursor।
-
Forward Query:
SQL WHERE (created_at, id) < (:createdAt, :id)ORDER BY created_at DESC, id DESCLIMIT 21; -
Backward Query:
SQL WHERE (created_at, id) > (:createdAt, :id)ORDER BY created_at ASC, id ASCLIMIT 21;
ব্যাকওয়ার্ড কুয়েরির ক্ষেত্রে ডাটাবেজ থেকে এসেন্ডিং অর্ডারে ডাটা তুলে আনার পর অ্যাপ্লিকেশন লেয়ারে অ্যারেটিকে আবার রিভার্স করে ক্লায়েন্টের প্রত্যাশিত ক্রমে পাঠানো হয়।
Filtering এবং Sorting-এর সঙ্গে Cursor
বাস্তব জীবনের প্রোডাকশন API-তে ফিল্টারিং এবং ডাইনামিক সর্টিং থাকে:
GET /api/v1/posts?author_id=42&status=published&sort=views&cursor=...এখানে তিনটি বিষয় লক্ষ্য রাখতে হবে:
- Composite Index Alignment: ফিল্টার এবং সর্ট কলামের ওপর কম্পোজিট ইন্ডেক্স থাকতে হবে:
(author_id, status, views DESC, id DESC)। - Context Binding: ব্যবহারকারী যদি সর্ট অপশন পরিবর্তন করেন, তবে পূর্বের কার্সর আর কাজ করবে না। কার্সর টোকেনের ভেতরে কুয়েরি প্যারামিটার বা ফিল্টার হ্যাশ বাইন্ড করে রাখতে হয় যাতে ভুল সর্টে পুরনো কার্সর ব্যবহার করলে ভ্যালিডেশন এরর দেওয়া যায়।
Distributed System-এ Cursor Pagination
ডাটাবেজ যখন একাধিক Shard বা পার্টিশনে বিভক্ত থাকে (যেমন CockroachDB, Citus, বা Sharded MySQL), তখন গ্লোবাল পেজিনেশন পরিচালনা করা একটি চ্যালেঞ্জ।
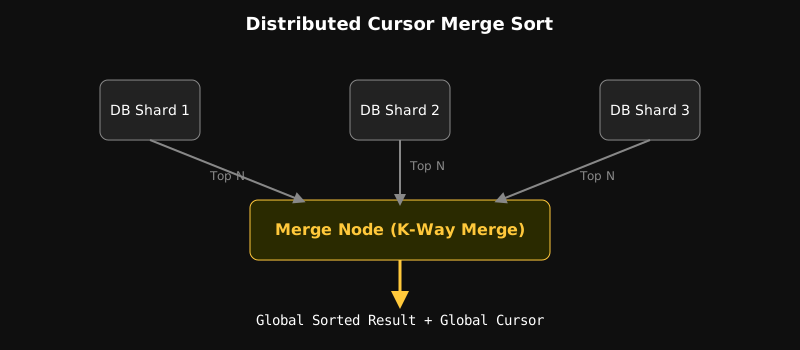
প্রতিটি ডাটাবেজ শার্ড নিজস্ব লোকাল ইনডেক্স অনুযায়ী ordered ডাটা রিটার্ন করে। API গেটওয়ে বা মার্জ নোড একটি K-Way Merge Sort অ্যালগরিদম চালিয়ে শীর্ষ ২০টি রেকর্ডস নির্বাচন করে এবং একটি সমন্বিত Global Cursor তৈরি করে ক্লায়েন্টকে পাঠায়।
Performance Benchmark এবং Production Architecture
প্রোডাকশন ইনসিডেন্টে যখন একটি হাই-ট্রাফিক সিস্টেমকে Deep OFFSET থেকে Indexed Cursor Pagination-এ মাইগ্রেট করা হয়, তখন তার ফলাফল হয় অভাবনীয়।
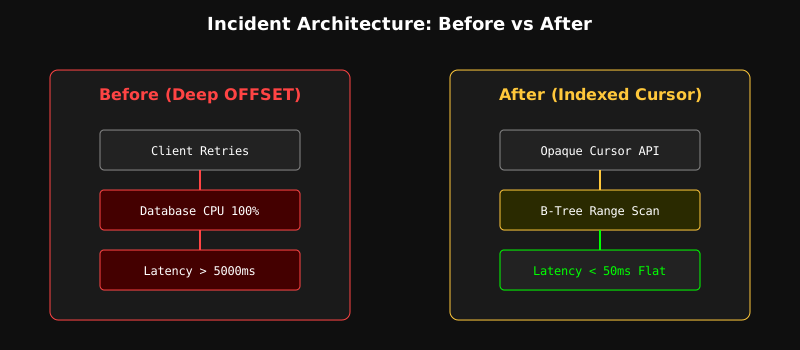
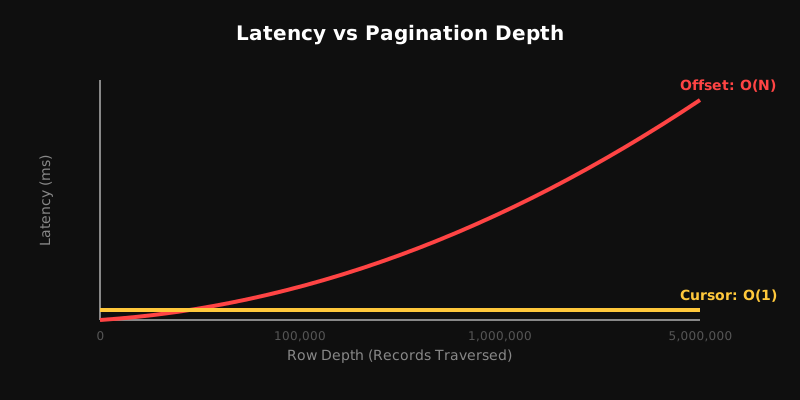
- Offset Approach (O(N)): পেজ গভীরতা বাড়ার সঙ্গে সঙ্গে p95 এবং p99 latency খাড়াভাবে উপরে উঠতে থাকে।
- Cursor Approach (O(1)): প্রথম পেজ এবং দশ লাখ নম্বর পেজের রেসপন্স টাইম সম্পূর্ণ সমান এবং ৫০ms-এর নিচে ফ্ল্যাট থাকে।
Random Page Access Trade-off
Cursor Pagination-এর একমাত্র সীমাবদ্ধতা হলো এটি সরাসরি "Jump to page 5000"-এর মতো র্যান্ডম অ্যাক্সেস সমর্থন করে না। ছোট ডেটাসেট বা ব্যাকঅফিস অ্যাডমিন প্যানেলে যেখানে পেজ নাম্বারে জাম্প করার প্রয়োজন হয়, সেখানে অফসেট ব্যবহার করা যৌক্তিক। কিন্তু ইনফিনিট স্ক্রল, ফিড বা হাই-স্কেল পাবলিক API-তে কার্সর পেজিনেশনই একমাত্র স্ট্যান্ডার্ড সমাধান।
Final Mental Model ও Production Checklist
পুরো আর্কিটেকচারের মূল সূত্রটি মনে রাখুন:
The Scalability Equation:
Deterministic Order + Matching Composite Index + Keyset Boundary + Bounded LIMIT = O(1) Scalable Pagination।
আপনার Production Readiness Checklist
- Deterministic Tie-Breaker:
ORDER BYক্লজে সবসময় একটি ইউনিক কলাম (যেমনidবাuuid_v7) যুক্ত করুন। - Matching Index: কুয়েরির
WHEREএবংORDER BYক্লজের কলাম ক্রমানুসারে কম্পোজিট ইন্ডেক্স তৈরি করুন। - Opaque Tokens: ইন্টারনাল ডাটাবেজ স্টেট হাইড করে Base64/HMAC সাইনড কার্সর টোকেন ব্যবহার করুন।
- LIMIT + 1 Pattern: আলাদা
COUNT(*)কুয়েরি পরিহার করেLIMIT + 1দিয়েhasNextPageনির্ধারণ করুন। - Context Validation: ক্লায়েন্ট ফিল্টার বা সর্ট পরিবর্তন করলে পুরনো কার্সর রিজেক্ট করার লজিক রাখুন।
- Immutable Sort Fields: সম্ভব হলে অপরিবর্তনশীল কলাম দিয়ে পেজিনেশন সর্ট করুন।
- EXPLAIN Verification: কুয়েরি প্রোডাকশনে দেওয়ার আগে
EXPLAIN ANALYZEচালিয়ে নিশ্চিত করুন যে এটি Index Scan করছে এবং কোনো অপ্রয়োজনীয় রো ডিসকার্ড করছে না।
Cursor Pagination শুধুমাত্র একটি API প্যাটার্ন নয়। এটি ডাটাবেজ ইঞ্জিনকে বাউন্ডেড এবং ইন্ডেক্স-ফ্রেন্ডলি উপায়ে ব্যবহার করার একটি শক্তিশালী সিস্টেম আর্কিটেকচার।