দ্য আলটিমেট সিস্টেম ডিজাইন হ্যান্ডবুক: রিয়েল-ওয়ার্ল্ড কেস স্টাডি দিয়ে গ্লোবাল স্কেল আর্কিটেকচার
On this page
আমরা যখন নতুন কোনো সফটওয়্যার প্রজেক্ট শুরু করি, তখন আমাদের মূল মনোযোগ থাকে দ্রুত ফিচার ডেভেলপমেন্ট, ক্লিন কোড এবং ইউজার ইন্টারফেসের ওপর। কিন্তু প্রোডাকশন পরিবেশে যখন সত্যিকারের ইউজার ট্রাফিক আসতে শুরু করে, তখনই আমাদের লেখা কোড এবং আর্কিটেকচারের আসল পরীক্ষা শুরু হয়। একটি সাধারণ Monolith অ্যাপ্লিকেশন ১ হাজার ইউজারের লোড খুব সহজেই হ্যান্ডেল করতে পারে, কিন্তু ইউজার সংখ্যা যখন ১০ লাখ বা ১ কোটিতে পৌঁছায়, তখন সিস্টেমের প্রতিটি লেয়ারে Bottleneck বা বাধা তৈরি হয়। সার্ভার ক্র্যাশ করে, Database Lock হয়ে যায় এবং Page Load Time ৩ থেকে ৪ সেকেন্ড পার হয়ে যায়, যা বর্তমান আধুনিক ইন্টারনেটের যুগে সরাসরি ব্যবসায়িক ক্ষতি।
সিস্টেম ডিজাইন কোনো মুখস্থ করার থিওরিটিক্যাল বিদ্যা নয়, এটি হলো বাস্তব জীবনের ইঞ্জিনিয়ারিং Trade-off অ্যানালাইসিস। এই হ্যান্ডবুকের কোর ফিলোসফি হলো রিয়েল-ওয়ার্ল্ড কেস স্টাডি বিশ্লেষণ করে সমস্যা চিহ্নিত করা এবং তার সঠিক আর্কিটেকচারাল সমাধান বের করা। আমরা কোনো গতানুগতিক সংজ্ঞায় না গিয়ে, একটি কাল্পনিক স্টার্টআপ প্ল্যাটফর্ম "FoodFast" এবং বিশ্বের শীর্ষস্থানীয় প্রযুক্তি প্রতিষ্ঠানগুলোর বাস্তব সিস্টেম ডিজাইনের জার্নি বিশ্লেষণ করব। আপনি যদি একজন সফটওয়্যার ইঞ্জিনিয়ার হিসেবে নিজের স্কিলকে নেক্সট লেভেলে নিয়ে যেতে চান এবং প্রোডাকশন গ্রেড সিস্টেম তৈরি করতে চান, তবে এই হ্যান্ডবুকটি আপনার জন্য একটি স্বয়ংসম্পূর্ণ গাইডলাইন হিসেবে কাজ করবে।
ফাউন্ডেশনাল মেন্টাল মডেলস ও ইঞ্জিনিয়ারিং অ্যানালজি
কোডে হাত দেওয়ার আগে পুরো সিস্টেমের স্ট্রাকচার বুঝতে আমাদের কিছু রিয়েল-ওয়ার্ল্ড মেন্টাল মডেল মাথায় রাখতে হবে। আমরা যখন কোনো জটিল সিস্টেম ডিজাইন করি, তখন কিছু মৌলিক প্যাটার্ন বারবার আমাদের সামনে আসে। এই প্যাটার্নগুলোকে সহজভাবে বোঝার জন্য আমরা দৈনন্দিন জীবনের কিছু অ্যানালজি ব্যবহার করতে পারি। নিচে এমন চারটি কোর ইঞ্জিনিয়ারিং কনসেপ্ট এবং তাদের বাস্তব অ্যানালজি আলোচনা করা হলো।
- Vertical vs Horizontal Scaling (লিফট বনাম নতুন সিঁড়ি অ্যানালজি): আপনার বিল্ডিংয়ে মানুষ বেড়ে গেলে লিফটের মোটর বড় করা হলো Vertical Scaling বা Scale Up। কিন্তু একটি নির্দিষ্ট সীমার পর লিফটের মোটর আর বড় করা যায় না, কারণ ভৌত সীমাবদ্ধতা থাকে। তখন সেই মোটরের ওপর চাপ না বাড়িয়ে পাশে নতুন সিঁড়ি বা নতুন লিফট বসানো হলো Horizontal Scaling বা Scale Out। সফটওয়্যার ইঞ্জিনিয়ারিংয়ে আমরা একটি মাত্র সার্ভারে আনলিমিটেড CPU বা RAM না বাড়িয়ে একাধিক সাধারণ সার্ভার নেটওয়ার্কে যোগ করি।
- Load Balancer (ট্রাফিক পুলিশ অ্যানালজি): রাস্তায় যখন হঠাৎ হাজার হাজার গাড়ি চলে আসে, তখন একজন ট্রাফিক পুলিশ সিগন্যাল দিয়ে বিভিন্ন লেনে গাড়িগুলোকে সমানভাবে ভাগ করে দেয়। আমাদের সফটওয়্যার সিস্টেমেও Load Balancer ঠিক একই কাজ করে। লাখ লাখ ক্লায়েন্ট রিকোয়েস্ট যখন সার্ভারে আঘাত করে, তখন লোড ব্যালেন্সার রাউন্ড-রবিন বা অন্য কোনো অ্যালগরিদম ব্যবহার করে ব্যাকএন্ড সার্ভারগুলোর মধ্যে সেই চাপ সমানভাবে বন্টন করে দেয়।
- Monolith vs Microservices (এক ঘরের রান্নাঘর বনাম ফুড কোর্ট অ্যানালজি): Monolith হলো একটি বিশাল ঘরের ভেতর সব ধরনের রান্না ও পরিবেশনের কাজ করা। সেই ঘরের গ্যাস পাইপলাইনে কোনো দুর্ঘটনা ঘটলে পুরো রেস্টুরেন্ট বন্ধ হয়ে যায়। অন্যদিকে Microservices হলো একটি বিশাল ফুড কোর্টের মতো, যেখানে পিৎজা, বার্গার এবং কফির দোকান সম্পূর্ণ আলাদা। কফির দোকানের কফি মেশিন নষ্ট হলেও পিৎজা বিক্রি বন্ধ হয় না, এবং পুরো সিস্টেম সচল থাকে।
- Database Indexing (বইয়ের সূচিপত্র অ্যানালজি): ১ হাজার পৃষ্ঠার একটি বই থেকে কোনো নির্দিষ্ট টপিক খুঁজতে পুরো বই প্রথম থেকে শেষ পর্যন্ত পড়া হলো Full Table Scan, যার Time Complexity হলো O(n)। আর বইয়ের পেছনের সূচিপত্র দেখে সরাসরি সেই নির্দিষ্ট পেজে চলে যাওয়া হলো Indexing। ডেটাবেজে আমরা B-Tree ডেটা স্ট্রাকচার ব্যবহার করে এই ইনডেক্সিং করি, যা O(log n) টাইমে কোটি কোটি ডেটার ভেতর থেকে সঠিক তথ্য খুঁজে বের করে।
কেস স্টাডি ১: FoodFast এমভিপি লঞ্চ ও প্রথম ১০ হাজার ইউজার (Monolith & Separation)
ধরুন, আপনি "FoodFast" নামের একটি নতুন ফুড ডেলিভারি স্টার্টআপের চিফ আর্কিটেক্ট। আপনাদের প্রাথমিক লক্ষ্য হলো খুব দ্রুত একটি Minimum Viable Product বা MVP তৈরি করে মার্কেটে ভ্যালিডেশন নেওয়া। এই পর্যায়ে আপনাদের বাজেট সীমিত এবং ইঞ্জিনিয়ার সংখ্যাও কম। তাই আপনারা জটিল কোনো ডিস্ট্রিবিউটেড সিস্টেমে না গিয়ে একটি সিঙ্গেল সার্ভার Monolith App এবং একটি সিঙ্গেল Relational Database দিয়ে যাত্রা শুরু করলেন। প্রথম কয়েক মাস সব কিছুই চমৎকার চলছিল, এবং আপনাদের দৈনিক অ্যাক্টিভ ইউজার ছিল মাত্র কয়েক শত। কিন্তু একটি সফল ডিজিটাল মার্কেটিং ক্যাম্পেইনের পর আপনাদের ইউজার সংখ্যা দ্রুত বাড়তে শুরু করে এবং ১০ হাজারে পৌঁছায়।
ঠিক এই সময়েই আপনাদের সিস্টেমে প্রথম বড় ধরনের ইঞ্জিনিয়ারিং ক্রাইসিস দেখা দেয়। আপনারা লক্ষ্য করলেন, পিক আওয়ারে অ্যাপ্লিকেশনের Page Load Time অস্বাভাবিকভাবে বেড়ে যাচ্ছে এবং সার্ভারের CPU Utilization ১০০ শতাংশে আটকে থাকছে। এর মূল কারণ হলো, একই মেমরি এবং প্রসেসর থেকে Web Server কোড এক্সিকিউট করছে এবং Database Query প্রসেস করছে। যখন হাজার হাজার ইউজার একসাথে রেস্টুরেন্টের মেনু ব্রাউজ করছে এবং অর্ডার প্লেস করছে, তখন মেমরি এবং Disk I/O Contention শুরু হচ্ছে। অ্যাপ্লিকেশনের Thread Pool ডেটাবেজ থেকে উত্তর আসার অপেক্ষায় ব্লক হয়ে থাকছে, যার ফলে নতুন কোনো ক্লায়েন্ট রিকোয়েস্ট সার্ভার গ্রহণ করতে পারছে না।
এই প্রাথমিক ক্রাইসিস সমাধানের জন্য আমাদের প্রথম ইঞ্জিনিয়ারিং পদক্ষেপ হলো App and DB Separation। আমরা Web Server এবং Database-কে দুটি আলাদা ফিজিক্যাল বা ভার্চুয়াল মেশিনে আলাদা করে ফেলি। এতে App Server-এর প্রসেসর এবং মেমরি সম্পূর্ণ স্বাধীনভাবে ক্লায়েন্ট রিকোয়েস্ট হ্যান্ডেল করতে পারে এবং ডেটাবেজ তার নিজস্ব ডেডিকেটেড রিসোর্স ব্যবহার করে কুয়েরি প্রসেস করতে পারে। একই সাথে আমরা Vertical Scaling বা সার্ভারের Hardware Upgradation প্রয়োগ করি। আমরা App Server-এর কনফিগারেশন ৪ কোর CPU থেকে ১৬ কোর CPU-তে আপগ্রেড করি এবং ডেটাবেজ সার্ভারের RAM ১৬ গিগাবাইট থেকে ৬৪ গিগাবাইটে উন্নীত করি। এই পরিবর্তনের ফলে আমাদের সিস্টেম পুনরায় দ্রুতগতিতে কাজ শুরু করে। নিচে App এবং DB Separation-এর পর একটি প্রোডাকশন-রেডি Connection Pool কনফিগারেশনের উদাহরণ দেওয়া হলো:
// db-pool-config.js// Production-ready PostgreSQL connection pool setup using 'pg' moduleconst { Pool } = require('pg');
const pool = new Pool({  host: process.env.DB_HOST || 'db-primary.foodfast.internal',  port: parseInt(process.env.DB_PORT || '5432', 10),  database: process.env.DB_NAME || 'foodfast_production',  user: process.env.DB_USER || 'admin_user',  password: process.env.DB_PASSWORD,  // Limit the maximum number of clients in the pool to prevent memory exhaustion  max: 25,  // Close idle clients after 30 seconds of inactivity  idleTimeoutMillis: 30000,  // Return an error after 2 seconds if connection could not be established  connectionTimeoutMillis: 2000,});
pool.on('error', (err, client) => {  console.error('Unexpected error on idle database client in FoodFast cluster', err);  process.exit(-1);});
module.exports = {  query: (text, params) => pool.query(text, params),  getPool: () => pool,};
Connection Pooling Efficiency
ডেটাবেজের সাথে প্রতিবার নতুন কানেকশন তৈরি করা একটি অত্যন্ত ব্যয়বহুল অপারেশন, কারণ এতে TCP Handshake এবং Authentication প্রসেস জড়িত থাকে। Connection Pool ব্যবহার করলে আগে থেকেই কিছু কানেকশন তৈরি থাকে, যা কুয়েরি ল্যাটেন্সি অনেকাংশে কমিয়ে দেয়।
কেস স্টাডি ২: FoodFast ফ্ল্যাশ সেল ক্রাইসিস ও ১ মিলিয়ন ইউজার (Horizontal Scaling & Load Balancing)
FoodFast-এর ইউজার সংখ্যা যখন ১ লাখে পৌঁছাল, তখন ব্যবসায়িক প্রবৃদ্ধির জন্য আপনারা একটি "মিডনাইট ফ্ল্যাশ সেল" ঘোষণা করলেন। রাত ১২টায় নির্দিষ্ট কিছু রেস্টুরেন্টে ৫০ শতাংশ ছাড় দেওয়া হবে। রাত ১১টা ৫৯ মিনিটে আপনাদের সিস্টেমে একসাথে ১ লাখ ইউজার লগইন করল এবং ঠিক ১২টায় একসাথে হাজার হাজার অর্ডার রিকোয়েস্ট আসতে শুরু করল। কয়েক সেকেন্ডের মধ্যে আপনাদের সেই ১৬ কোর CPU-র শক্তিশালী Web Server-টি Out of Memory বা OOM এররে ক্র্যাশ করল। পুরো প্ল্যাটফর্ম ডাউন হয়ে গেল এবং সোশ্যাল মিডিয়ায় ইউজারদের নেতিবাচক রিভিউ আসতে শুরু করল।
আপনারা বুঝতে পারলেন, Vertical Scaling বা সার্ভার বড় করার একটি ভৌত এবং আর্থিক সীমাবদ্ধতা আছে। একটি সিঙ্গেল সার্ভারে আপনি চাইলেই আনলিমিটেড RAM বা প্রসেসর বসাতে পারবেন না, এবং একটি সার্ভারের ওপর নির্ভর করা মানেই সিস্টেমে Single Point of Failure বা SPOF রেখে দেওয়া। এই ক্রাইসিস থেকে মুক্তির একমাত্র পথ হলো Horizontal Scaling ইমপ্লিমেন্ট করা। আমরা একটি শক্তিশালী সার্ভারের বদলে সাধারণ কনফিগারেশনের ১০টি সার্ভার সমান্তরালভাবে নেটওয়ার্কে যুক্ত করি। কিন্তু এখন প্রশ্ন হলো, ক্লায়েন্টের মোবাইল অ্যাপ বা ব্রাউজার কীভাবে জানবে কোন সার্ভারে রিকোয়েস্ট পাঠাতে হবে?
এই সমস্যার সমাধানে আমরা সার্ভার ক্লাস্টারের সামনে একটি Load Balancing Layer তৈরি করি, যেখানে Nginx বা HAProxy ব্যবহার করা হয়। লোড ব্যালেন্সার Layer 4 (Transport Layer) বা Layer 7 (Application Layer) রাউটিং ইমপ্লিমেন্ট করে। আমরা Nginx-এ Least Connections অ্যালগরিদম কনফিগার করি, যাতে যে সার্ভারে কাজের চাপ সবচেয়ে কম, নতুন রিকোয়েস্টটি সেখানেই যায়। তবে একাধিক সার্ভার ব্যবহার করার একটি প্রধান পূর্বশর্ত হলো সার্ভারকে সম্পূর্ণ Stateless করা। আগে ইউজারের লগইন সেশন সার্ভারের লোকাল মেমরিতে থাকত, যাকে Sticky Session বলা হয়। কিন্তু এখন রিকোয়েস্ট যেকোনো সার্ভারে যেতে পারে। তাই আমরা সেশন ডেটা সার্ভারের মেমরি থেকে সরিয়ে Centralized Redis Session Store-এ নিয়ে যাই এবং ক্লায়েন্ট সাইডে Stateless JWT বা JSON Web Token ব্যবহার শুরু করি।
# nginx-load-balancer.conf# Layer 7 Load Balancing configuration for FoodFast backend clusterupstream foodfast_backend_cluster {    # Routelessly distribute load to the server with the least active connections    least_conn;
    server app-node-01.foodfast.internal:3000 max_fails=3 fail_timeout=10s;    server app-node-02.foodfast.internal:3000 max_fails=3 fail_timeout=10s;    server app-node-03.foodfast.internal:3000 max_fails=3 fail_timeout=10s;    server app-node-04.foodfast.internal:3000 max_fails=3 fail_timeout=10s;    server app-node-05.foodfast.internal:3000 max_fails=3 fail_timeout=10s;
    # Maintain open keepalive connections between Nginx and backend servers    keepalive 64;}
server {    listen 80;    server_name api.foodfast.com;
    location / {        proxy_pass http://foodfast_backend_cluster;        proxy_http_version 1.1;        proxy_set_header Connection "";        proxy_set_header X-Real-IP $remote_addr;        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;        proxy_set_header Host $http_host;
        # Strict timeout configurations to prevent hanging requests during spikes        proxy_connect_timeout 3s;        proxy_read_timeout 7s;    }}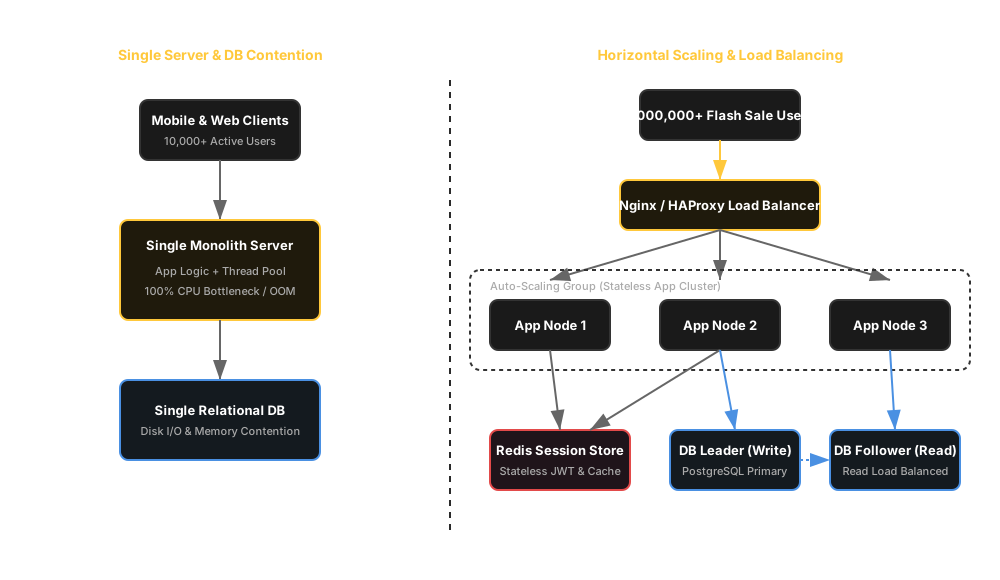
Stateless Architecture Requirement
লোড ব্যালেন্সার ব্যবহারের সময় সার্ভারের লোকাল মেমরিতে কখনোই কোনো ইউজার সেশন, টেম্পোরারি ফাইল বা স্টেট সেভ করবেন না। সার্ভার সম্পূর্ণ Stateless না হলে রিকোয়েস্ট অন্য নোডে রাউট হওয়ার সাথে সাথে ইউজার বারবার লগআউট হয়ে যাবে বা ডেটা হারিয়ে ফেলবে।
কেস স্টাডি ৩: ডেটাবেজ যখন বোতলঘাড় ও গ্লোবাল এক্সপানশন (Replication, Sharding & NoSQL)
Horizontal Scaling এবং লোড ব্যালেন্সার বসানোর পর FoodFast-এর Web Server ক্লাস্টার এখন প্রতি সেকেন্ডে লাখ লাখ রিকোয়েস্ট হ্যান্ডেল করতে পারছে। কিন্তু আপনাদের ব্যবসা এখন আর একটি শহরের মধ্যে সীমাবদ্ধ নেই; পুরো দেশ জুড়ে এবং প্রতিবেশী কয়েকটি দেশে আপনাদের সেবা চালু হয়েছে। ইউজার সংখ্যা ১০ লাখ পার হয়েছে। ঠিক এই পর্যায়ে আপনাদের সিস্টেমে নতুন একটি Bottleneck তৈরি হলো। আপনাদের ১০টি App Server স্বাধীনভাবে কাজ করলেও, তারা সবাই ডেটা রিড এবং রাইট করার জন্য আঘাত করছে সেই একটি মাত্র Relational Database-এর ওপর।
ডেটাবেজের ওপর এই প্রচণ্ড চাপের কারণে Database Read and Write Contention তৈরি হলো। Connection Pool নিঃশেষ হয়ে গেল এবং জটিল ট্রানজেকশনের সময় Deadlock দেখা দিল। আমরা যখন কুয়েরি লগ বিশ্লেষণ করলাম, তখন দেখলাম যে রেস্টুরেন্ট সার্চ করার কুয়েরিগুলো Full Table Scan করছে। ১ লাখ রেস্টুরেন্টের ডেটাবেজ থেকে নির্দিষ্ট এলাকার খাবার খুঁজতে গিয়ে ডেটাবেজের প্রসেসর ১০০ শতাংশ ব্যস্ত হয়ে পড়ছে। এই সমস্যার প্রথম সমাধান হিসেবে আমরা ডেটাবেজের সার্চ কলামগুলোতে B-Tree Indexing ইমপ্লিমেন্ট করি। ইনডেক্সিং করার ফলে আমাদের সার্চ কুয়েরির Time Complexity O(n) থেকে নেমে O(log n) হয়ে গেল, এবং যে কুয়েরি চলতে ৫০০ মিলিসেকেন্ড লাগছিল, তা নেমে আসলো মাত্র ৫ মিলিসেকেন্ডে।
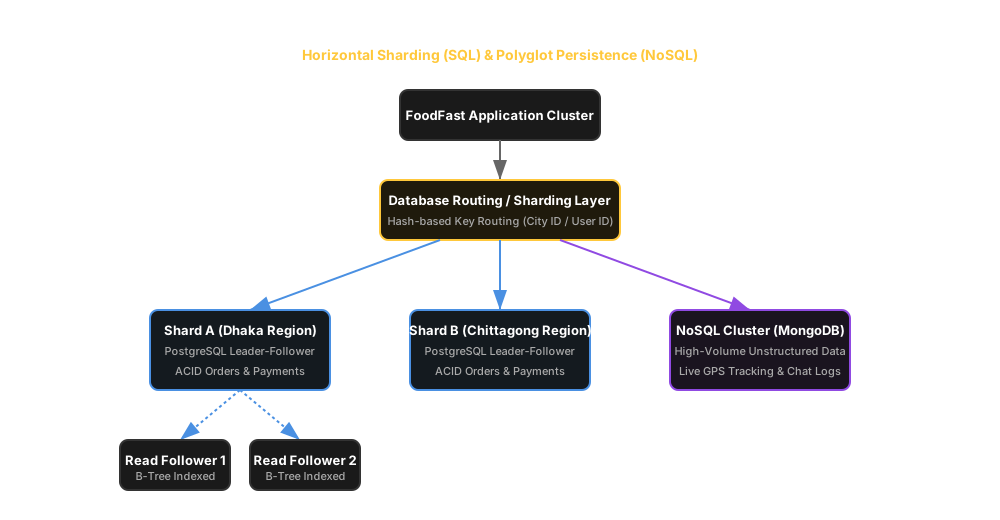
কিন্তু ইনডেক্সিং শুধুমাত্র Read স্পিড বাড়ায়। প্রতিবার নতুন অর্ডার আসার সাথে সাথে (Write Operation) ডেটাবেজকে তার ইনডেক্স ট্রি রিবিল্ড করতে হয়, যা Space Complexity এবং Time Overhead বাড়িয়ে দেয়। তাই আমরা ডেটা লেয়ারকে ডিস্ট্রিবিউটেড করার সিদ্ধান্ত নিই। আমরা Database Replication ইমপ্লিমেন্ট করে একটি Leader (Write) ডেটাবেজ এবং ৪টি Follower (Read) ডেটাবেজ তৈরি করি। আমাদের অ্যাপ্লিকেশনের ৯০ শতাংশ ট্রাফিকই হলো Read Operation (যেমন: মেনু দেখা, রেস্টুরেন্ট খোঁজা)। আমরা এই সমস্ত Read ট্রাফিক লোড ব্যালেন্স করে Follower ডেটাবেজগুলোতে পাঠিয়ে দিই, এবং শুধুমাত্র অর্ডার প্লেস বা পেমেন্টের মতো Write Operation-গুলো Leader ডেটাবেজে পাঠাই। লিডার ডেটাবেজ স্বয়ংক্রিয়ভাবে তার ডেটা ফলোয়ারদের সাথে সিঙ্ক করে নেয়।
যখন আমাদের অর্ডারের টেবিল কয়েক কোটি রো (Rows) পার হয়ে গেল, তখন একটি সিঙ্গেল লিডার ডেটাবেজেও ডেটা রাখা অসম্ভব হয়ে পড়ল। তখন আমরা Sharding বা Horizontal Partitioning ইমপ্লিমেন্ট করি। আমরা ইউজারের Geographic Location বা City ID-কে Sharding Key হিসেবে ব্যবহার করে ডেটাবেজকে কয়েকটি স্বাধীন অংশে ভাগ করে ফেলি। উদাহরণস্বরূপ, ঢাকার সব ইউজারের ডেটা চলে গেল Shard-A তে, এবং চট্টগ্রামের ডেটা চলে গেল Shard-B তে। একই সাথে আমরা বুঝতে পারলাম যে সব ডেটার জন্য Relational Database বা SQL উপযুক্ত নয়। পেমেন্ট এবং অর্ডারের জন্য আমাদের ACID (Atomicity, Consistency, Isolation, Durability) প্রোপার্টিজ দরকার, তাই সেখানে আমরা PostgreSQL ব্যবহার অব্যাহত রাখলাম। কিন্তু ইউজারদের রিয়েল-টাইম জিপিএস লোকেশন ট্র্যাকিং এবং চ্যাট মেসেজের মতো আনস্ট্রাকচার্ড ও হাই-ভলিউম ডেটার জন্য আমরা NoSQL ডেটাবেজ হিসেবে MongoDB এবং Cassandra বেছে নিলাম। আমাদের এই সিদ্ধান্তে CAP Theorem (Consistency, Availability, Partition Tolerance) একটি বড় ভূমিকা পালন করেছিল। আমরা পেমেন্টের ক্ষেত্রে Consistency-কে সর্বোচ্চ গুরুত্ব দিয়েছি, আর লাইভ লোকেশন ট্র্যাকিংয়ের ক্ষেত্রে Availability-কে প্রাধান্য দিয়েছি।
Database Sharding Complexity
ডেটাবেজ Sharding করার আগে দশবার চিন্তা করুন। একবার Sharding করার পর একাধিক Shards থেকে Join Query চালানো বা ট্রানজেকশন মেইনটেইন করা অত্যন্ত জটিল হয়ে যায়। Sharding করার আগে অবশ্যই Indexing, Caching এবং Read Replication চেষ্টা করে দেখুন।
কেস স্টাডি ৪: রকেটের গতিতে পারফরম্যান্স বুস্টিং (Caching Strategies & Edge Computing)
FoodFast-এর ডেটাবেজ এখন ডিস্ট্রিবিউটেড এবং স্কেল করা হয়েছে। সার্ভার ক্র্যাশ করছে না, এবং অর্ডারও ঠিকমতো প্লেস হচ্ছে। কিন্তু আপনারা ইউজারদের অ্যানালিটিক্স রিপোর্ট দেখে লক্ষ্য করলেন যে, অ্যাপ ওপেন করার পর হোমপেজ লোড হতে এখনও প্রায় ২.৫ সেকেন্ড সময় লাগছে। বর্তমান ফাস্ট-পেজড ইন্টারনেটের যুগে ২.৫ সেকেন্ড লোড টাইম মানেই প্রচুর ইউজার অ্যাপ বন্ধ করে প্রতিদ্বন্দ্বী প্ল্যাটফর্মে চলে যাওয়া। আমরা যখন নেটওয়ার্ক রিকোয়েস্ট ট্রেস করলাম, তখন দেখলাম প্রতিবার ইউজার হোমপেজে আসলে আমাদের App Server ডেটাবেজে কুয়েরি চালিয়ে রেস্টুরেন্টের লিস্ট এবং পপুলার খাবারের তালিকা নিয়ে আসছে। ফিজিক্যাল হার্ডডিস্ক বা এসএসডি থেকে ডেটা রিড করতে এবং নেটওয়ার্ক রাউন্ড ট্রিপে এই মূল্যবান সময় নষ্ট হচ্ছে।
এই ল্যাটেন্সি বা বিলম্বকে মিলিসেকেন্ড থেকে মাইক্রোসেকেন্ডে নামিয়ে আনার মোক্ষম ইঞ্জিনিয়ারিং অস্ত্র হলো In-Memory Caching। আমরা আমাদের আর্কিটেকচারে Redis এবং Memcached-এর মতো ইন-মেমরি ডেটাবেজ যুক্ত করি। যে সমস্ত ডেটা খুব ঘন ঘন পরিবর্তন হয় না (যেমন: রেস্টুরেন্টের মেনু, খাবারের দাম, ও ক্যাটাগরি লিস্ট), সেগুলো আমরা সরাসরি সার্ভারের RAM-এ সেভ করে রাখি। আমরা Read-Heavy অপারেশনের জন্য Cache-Aside প্যাটার্ন ইমপ্লিমেন্ট করি। যখন কোনো রিকোয়েস্ট আসে, অ্যাপ্লিকেশন প্রথমে Redis ক্যাশে ডেটা খোঁজে (Cache Hit)। যদি ডেটা পাওয়া যায়, তবে ডেটাবেজে না গিয়েই তাৎক্ষণিক উত্তর দিয়ে দেয়। আর যদি ক্যাশে ডেটা না থাকে (Cache Miss), তখন অ্যাপ্লিকেশন মূল ডেটাবেজ থেকে ডেটা নিয়ে আসে, ক্লায়েন্টকে উত্তর দেয়, এবং পরবর্তী রিকোয়েস্টের জন্য সেই ডেটা Redis-এ সেভ করে রাখে।
কিন্তু RAM বা মেমরি অত্যন্ত ব্যয়বহুল এবং এর ধারণক্ষমতা সীমিত। কোটি কোটি খাবারের আইটেম আজীবন মেমরিতে রাখা সম্ভব নয়। তাই আমরা সঠিক Cache Eviction Policies কনফিগার করি। আমরা Redis ক্লাস্টারে LRU (Least Recently Used) অ্যালগরিদম সেট করি। যখন মেমরি ফুল হয়ে যায়, তখন যে ডেটাগুলো দীর্ঘ সময় ধরে কোনো ইউজার ব্রাউজ করেনি, সিস্টেম স্বয়ংক্রিয়ভাবে সেগুলো মেমরি থেকে মুছে ফেলে এবং নতুন হট-ডেটার জন্য জায়গা করে দেয়। একই সাথে ডেটা consistency ঠিক রাখার জন্য আমরা প্রতিটি ক্যাশ কি (Key)-এর সাথে একটি যৌক্তিক TTL (Time To Live) বা মেয়াদ নির্ধারণ করে দিই, যাতে রেস্টুরেন্ট খাবারের দাম পরিবর্তন করলে ইউজার পুরনো দাম দেখতে না পায়।
এছাড়া আমাদের প্ল্যাটফর্মে প্রতিদিন হাজার হাজার খাবারের হাই-রেজোলিউশন ছবি এবং প্রমোশনাল ভিডিও আপলোড হয়। একজন ইউজার যখন অ্যাপ ব্রাউজ করে, তখন এই ভারী স্ট্যাটিক ফাইলগুলো আমাদের মূল সার্ভার থেকে লোড হতে প্রচুর সময় নেয় এবং নেটওয়ার্ক ব্যান্ডউইথ খরচ করে। এই সমস্যার সমাধানে আমরা Cloudflare এবং AWS CloudFront-এর মতো CDN বা Content Delivery Network ব্যবহার শুরু করি। সিডিএন বিশ্বের বিভিন্ন স্থানে ছড়িয়ে থাকা Edge Servers-এ আমাদের ছবি ও ভিডিওগুলোর ক্যাশ কপি রেখে দেয়। এখন একজন ইউজার যখন অ্যাপ খোলে, তখন তার খাবারের ছবিগুলো আমাদের মূল সার্ভার থেকে না এসে তার ভৌগোলিক অবস্থানের সবচেয়ে কাছের Edge Location থেকে লোড হয়। এর ফলে রাউন্ড ট্রিপ টাইম (RTT) নাটকীয়ভাবে কমে যায় এবং পুরো অ্যাপ রকেটের গতিতে কাজ করে।
// redis-cache-aside.ts// Production implementation of Cache-Aside pattern using Redis and Node.jsimport { createClient } from 'redis';import { getPool } from './db-pool-config';
const redisClient = createClient({ url: process.env.REDIS_URL });redisClient.connect();
export async function getRestaurantMenu(restaurantId: string): Promise<any> {  const cacheKey = `foodfast:menu:${restaurantId}`;
  try {    // Step 1: Check if the menu exists in Redis in-memory cache    const cachedData = await redisClient.get(cacheKey);    if (cachedData) {      console.info(`[Cache Hit] Serving menu from Redis for restaurant: ${restaurantId}`);      return JSON.parse(cachedData);    }
    // Step 2: Cache Miss - Query the primary PostgreSQL database    console.warn(`[Cache Miss] Fetching menu from DB for restaurant: ${restaurantId}`);    const dbPool = getPool();    const queryText = `      SELECT id, name, description, price, category, is_available      FROM menu_items      WHERE restaurant_id = $1 AND is_deleted = false    `;    const result = await dbPool.query(queryText, [restaurantId]);
    if (result.rows.length === 0) {      return null;    }
    const menuData = result.rows;
    // Step 3: Write data to Redis Cache with a TTL of 3600 seconds (1 hour)    await redisClient.setEx(cacheKey, 3600, JSON.stringify(menuData));
    return menuData;  } catch (error) {    console.error('Error in getRestaurantMenu execution:', error);    // Fallback: If Redis fails, gracefully degrade and fetch from DB directly    const dbPool = getPool();    const fallbackResult = await dbPool.query('SELECT * FROM menu_items WHERE restaurant_id = $1', [restaurantId]);    return fallbackResult.rows;  }}
Cache Stampede Prevention
যখন কোনো জনপ্রিয় খাবারের ক্যাশ মেয়াদ শেষ (TTL Expire) হয়ে যায়, তখন একসাথে হাজার হাজার রিকোয়েস্ট মূল ডেটাবেজে আঘাত করতে পারে, যাকে Cache Stampede বলা হয়। এটি রোধ করার জন্য Mutex Lock বা Distributed Lock ব্যবহার করুন, যাতে শুধুমাত্র একটি থ্রেড ডেটাবেজ থেকে ডেটা এনে ক্যাশ আপডেট করতে পারে।
কেস স্টাডি ৫: দ্য মনোলিথ ব্রেকডাউন ও ৫০ জন ডেভেলপার (Microservices & Event-Driven Flow)
FoodFast এখন একটি বিশাল প্রতিষ্ঠানে পরিণত হয়েছে। আপনাদের ইঞ্জিনিয়ারিং টিমে এখন ৫০ জনেরও বেশি সফটওয়্যার ডেভেলপার, টেস্টার এবং ডেভঅপস ইঞ্জিনিয়ার কাজ করছেন। কিন্তু এত বড় টিম হওয়ার পরেও আপনারা লক্ষ্য করলেন যে, নতুন কোনো ফিচার রিলিজ করতে এখন আগের চেয়ে অনেক বেশি সময় লাগছে। এর মূল কারণ হলো আপনাদের সেই পুরনো Monolith কোডবেস। পুরো প্ল্যাটফর্মের সমস্ত লজিক (ইউজার অথেনটিকেশন, রেস্টুরেন্ট অনবোর্ডিং, কার্ট ম্যানেজমেন্ট, পেমেন্ট প্রসেসিং, ডেলিভারি রাইডার ম্যাচিং, এবং নোটিফিকেশন সিস্টেম) একটি মাত্র বিশাল রিপোজিটরিতে বন্দি হয়ে আছে।
এই মনোলিথিক সিস্টেমে Tight Coupling তৈরি হয়েছে। একজন জুনিয়র ডেভেলপার যখন নোটিফিকেশন মডিউলের ইমেইল টেম্পলেট পরিবর্তন করার চেষ্টা করল, তখন একটি ছোট সিনট্যাক্স এররের কারণে পুরো পেমেন্ট সিস্টেম ক্র্যাশ করে বসল। প্রতিদিন ৫০ জন ডেভেলপার যখন একই কোডবেসে কোড পুশ করছে, তখন গিট কনফ্লিক্ত লেগেই থাকছে। একটি ছোট বাগ ফিক্স করে প্রোডাকশনে ডিপ্লয় করতে পুরো বিশাল মনোলিথ অ্যাপ্লিকেশন বিল্ড এবং টেস্ট করতে কয়েক ঘণ্টা সময় লেগে যাচ্ছে। এছাড়া স্কেলিং করার সময় আমরা শুধু পেমেন্ট সার্ভিস স্কেল করতে পারছিলাম না; আমাদের পুরো মনোলিথ সার্ভার স্কেল করতে হচ্ছিল, যা মারাত্মক Resource Wastage।
এই ইঞ্জিনিয়ারিং দুঃস্বপ্ন থেকে বাঁচতে আমরা আমাদের পুরো সিস্টেমকে Microservices Architecture-এ রূপান্তর করার সিদ্ধান্ত নিই। আমরা ডোমেইন-ড্রাইভেন ডিজাইন (Domain-Driven Design) অনুসরণ করে আমাদের মনোলিথকে ছোট ছোট স্বাধীন সার্ভিসে ভেঙে ফেলি। আমরা তৈরি করি Auth Service, Restaurant Service, Order Service, Payment Service, Rider Matching Service এবং Notification Service। প্রতিটি মাইক্রোসার্ভিসের নিজস্ব ডেডিকেটেড ডেটাবেজ এবং স্বাধীন ডিপ্লয়মেন্ট পাইপলাইন তৈরি করা হয়। এখন পেমেন্ট টিমের ইঞ্জিনিয়াররা অন্য কোনো টিমের ওপর নির্ভর না করে দিনে ১০ বার তাদের সার্ভিস প্রোডাকশনে ডিপ্লয় করতে পারেন।
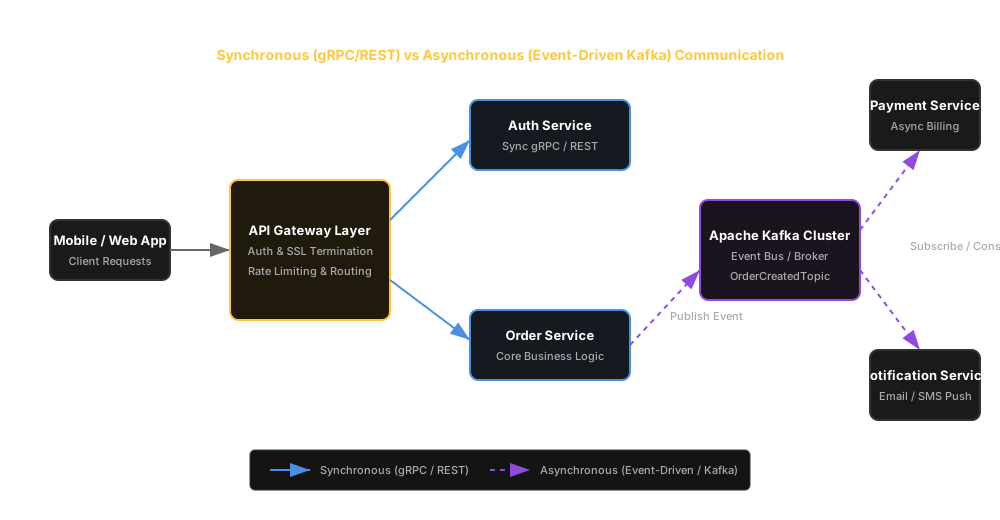
ক্লায়েন্ট অ্যাপ্লিকেশন এবং এই অসংখ্য মাইক্রোসার্ভিসের মাঝে আমরা একটি Single Entry Point হিসেবে API Gateway বসাই। ক্লায়েন্টকে এখন প্রতিটি সার্ভিসের আলাদা আইপি বা ইউআরএল চিনতে হয় না। API Gateway সমস্ত রিকোয়েস্ট গ্রহণ করে, Authentication এবং SSL Termination সম্পন্ন করে, এবং সঠিক মাইক্রোসার্ভিসে রিকোয়েস্ট রাউট করে দেয়। সার্ভিস থেকে সার্ভিসে কথা বলার জন্য আমরা দুই ধরনের কমিউনিকেশন প্যাটার্ন ব্যবহার করি। যখন কোনো ইনস্ট্যান্ট রেসপন্স দরকার হয় (যেমন: অর্ডার প্লেস করার সময় ইউজার অথেনটিকেটেড কিনা তা যাচাই করা), তখন আমরা Synchronous Communication হিসেবে gRPC বা REST প্রটোকল ব্যবহার করি। gRPC প্রটোকল Protocol Buffers ব্যবহার করে বাইনারি ফরম্যাটে ডেটা আদান-প্রদান করে, যা সাধারণ JSON-এর চেয়ে ১০ গুণ দ্রুত কাজ করে।
আর যে সমস্ত কাজে ইনস্ট্যান্ট উত্তরের প্রয়োজন নেই, সেখানে আমরা Asynchronous Communication ইমপ্লিমেন্ট করি। উদাহরণস্বরূপ, যখন কোনো ইউজার একটি খাবারের অর্ডার সফলভাবে প্লেস করে, তখন Order Service সরাসরি Notification Service বা Billing Service-কে কল করে বসে থাকে না। এর পরিবর্তে Order Service একটি Message Broker বা Event Bus (যেমন: Apache Kafka বা RabbitMQ)-এ একটি OrderCreatedEvent মেসেজ পুশ করে দেয়। Kafka ক্লাস্টারের সেই টপিক থেকে Payment Service, Notification Service এবং Analytics Service স্বাধীনভাবে মেসেজটি কনজিউম করে এবং তাদের নিজ নিজ কাজ (যেমন: ইনভয়েস তৈরি করা, এসএমএস পাঠানো, ও রাইডার খোঁজা) ব্যাকগ্রাউন্ডে সম্পন্ন করে। এই Event-Driven Architecture আমাদের সিস্টেমকে অত্যন্ত ফাস্ট, লুজলি কাপলড এবং স্কেলেবল করে তোলে।
কেস স্টাডি ৬: সিস্টেম যখন অমর ও বিপর্যয় মোকাবেলা (Fault Tolerance, Rate Limiting & Observability)
ডিস্ট্রিবিউটেড মাইক্রোসার্ভিস সিস্টেমে একটি ধ্রুব সত্য হলো: "যেকোনো কিছু যেকোনো সময় ফেইল করতে পারে।" একদিন শুক্রবার রাতে পিক আওয়ারে আমাদের থার্ড-পার্টি পেমেন্ট গেটওয়ে পার্টনারের সার্ভারে যান্ত্রিক ত্রুটি দেখা দিল। তারা পেমেন্ট রিকোয়েস্টের উত্তর দিতে ৩০ সেকেন্ডের বেশি সময় নিচ্ছিল। আমাদের FoodFast-এর Payment Service সেই উত্তরের আশায় অপেক্ষা করতে করতে তার সমস্ত থ্রেড এবং কানেকশন পুল ব্লক করে ফেলল। যেহেতু Order Service সিঙ্ক্রোনাসভাবে Payment Service-এর ওপর নির্ভরশীল ছিল, তাই Order Service-ও ক্র্যাশ করল। দেখতে দেখতে এই Cascading Failure-এর কারণে আমাদের পুরো মাইক্রোসার্ভিস ইকোসিস্টেম ডমিনোর মতো তাসের ঘরের মতো ভেঙে পড়ল।
এই ভয়াবহ অভিজ্ঞতা থেকে শিক্ষা নিয়ে আমরা আমাদের আর্কিটেকচারে Fault Tolerance বা বিপর্যয় সহনশীলতা ইমপ্লিমেন্ট করি। আমরা প্রতিটি সার্ভিসের মাঝে Circuit Breaker Pattern যুক্ত করি। বৈদ্যুতিক সার্কিট ব্রেকার যেমন অতিরিক্ত ভোল্টেজ আসলে ট্রিপ করে ঘরকে দুর্ঘটনার হাত থেকে বাঁচায়, সফটওয়্যার সার্কিট ব্রেকারও ঠিক একই কাজ করে। আমরা Resilience4j বা Hystrix কনসেপ্ট ব্যবহার করে লজিক সেট করি যে, যদি কোনো সার্ভিস ১০ সেকেন্ডের মধ্যে ৫০ শতাংশ রিকোয়েস্টে টাইমআউট বা এরর দেয়, তবে সার্কিট ব্রেকার "Open" হয়ে যাবে। সার্কিট ওপেন থাকা অবস্থায় আমাদের সিস্টেম সেই অকেজো সার্ভিসে আর কোনো রিকোয়েস্ট পাঠাবে না, বরং তাৎক্ষণিক একটি Fallback Response রিটার্ন করবে (যেমন: "পেমেন্ট সেবা সাময়িক বিঘ্নিত হচ্ছে, আপনার অর্ডারটি ক্যাশ অন ডেলিভারিতে রূপান্তর করা হলো")। এর ফলে মেইন থ্রেড ব্লক হয় না এবং সিস্টেম সচল থাকে।
একই সাথে আমরা আমাদের সিস্টেমকে হ্যাকারদের ও ক্ষতিকারক বট (Bots)-এর হাত থেকে বাঁচাতে Rate Limiting ইমপ্লিমেন্ট করি। আমরা Token Bucket বা Leaky Bucket অ্যালগরিদম ব্যবহার করে API Gateway লেয়ারে নিয়ম সেট করে দিই যে, একটি নির্দিষ্ট আইপি বা ইউজার অ্যাকাউন্ট প্রতি সেকেন্ডে সর্বোচ্চ ২০টির বেশি রিকোয়েস্ট পাঠাতে পারবে না। যদি কেউ এর চেয়ে বেশি রিকোয়েস্ট পাঠায় (যেমন: কোনো প্রতিযোগী প্রতিষ্ঠান যদি আমাদের মেনু স্ক্র্যাপ করার চেষ্টা করে বা DDoS অ্যাটাক দেয়), তবে লোড ব্যালেন্সার তাকে তাৎক্ষণিক 429 Too Many Requests স্ট্যাটাস কোড দিয়ে ব্লক করে দেবে।
অবশেষে, ৫০টি মাইক্রোসার্ভিসের হাজার হাজার সার্ভারে কোথায় কী ঘটছে, তা অন্ধের মতো অনুমান না করে আমরা Observability বা পর্যবেক্ষণ ব্যবস্থা গড়ে তুলি। আমরা তিনটি স্তম্ভের ওপর ভিত্তি করে এই ব্যবস্থা তৈরি করি: Logging, Metrics, এবং Tracing। আমরা প্রতিটি মাইক্রোসার্ভিস থেকে লগ সংগ্রহ করে ELK Stack (Elasticsearch, Logstash, Kibana)-এ পাঠাই। সার্ভারের CPU, মেমরি, এবং রিকোয়েস্ট ল্যাটেন্সি মাপার জন্য আমরা Prometheus ব্যবহার করে রিয়েল-টাইম মেট্রিক্স সংগ্রহ করি এবং Grafana ড্যাশবোর্ডে তা ভিজ্যুয়ালাইজ করি। আর একটি রিকোয়েস্ট API Gateway থেকে শুরু করে কোন কোন মাইক্রোসার্ভিস হয়ে ডেটাবেজ পর্যন্ত গেল, তার সম্পূর্ণ পথ ট্র্যাক করার জন্য আমরা Jaeger বা Zipkin ব্যবহার করে Distributed Tracing ইমপ্লিমেন্ট করি। এখন কোনো রিকোয়েস্ট স্লো হলে আমরা ড্যাশবোর্ড দেখেই ১ সেকেন্ডে বলে দিতে পারি ঠিক কোন সার্ভিসের কোন কুয়েরিটি ল্যাটেন্সি তৈরি করছে।
// circuit-breaker-pattern.ts// Production-ready implementation of Circuit Breaker using Opossum library patternimport CircuitBreaker from 'opossum';import axios from 'axios';
// The potentially unreliable external service call (e.g., Bank Payment Gateway)async function callExternalPaymentGateway(payload: any): Promise<any> {  const response = await axios.post('https://bank-gateway.external.com/api/v1/charge', payload, {    timeout: 3000, // Strict 3 seconds timeout to prevent thread blocking  });  return response.data;}
// Circuit Breaker configuration options for FoodFast payment serviceconst breakerOptions = {  timeout: 3500, // If function execution takes longer than 3.5s, trigger a failure  errorThresholdPercentage: 50, // When 50% of requests fail, trip the circuit to OPEN  resetTimeout: 30000, // After 30 seconds, transition to HALF-OPEN state to test service health};
const paymentCircuitBreaker = new CircuitBreaker(callExternalPaymentGateway, breakerOptions);
// Fallback logic executed immediately when Circuit is OPEN or service failspaymentCircuitBreaker.fallback((payload: any, error: any) => {  console.warn(`[Circuit Breaker OPEN] Payment gateway failed for order ${payload.orderId}. Executing fallback.`);  return {    status: 'ACCEPTED_FALLBACK',    paymentMethod: 'CASH_ON_DELIVERY',    message: 'Online payment is temporarily unavailable. Order converted to Cash on Delivery.',    originalError: error.message,  };});
paymentCircuitBreaker.on('open', () => console.error('CRITICAL ALERT: Payment Circuit Breaker TRIPPED to OPEN!'));paymentCircuitBreaker.on('halfOpen', () => console.info('Payment Circuit Breaker is HALF-OPEN. Testing gateway health...'));paymentCircuitBreaker.on('close', () => console.info('Payment Circuit Breaker CLOSED. Gateway operating normally.'));
export async function processOrderPayment(payload: any): Promise<any> {  return await paymentCircuitBreaker.fire(payload);}
Distributed Tracing Overhead
প্রোডাকশন সিস্টেমে ১০০ শতাংশ রিকোয়েস্টের Distributed Tracing চালূ রাখবেন না। এতে প্রচুর নেটওয়ার্ক ব্যান্ডউইথ এবং স্টোরেজ নষ্ট হয়। এর পরিবর্তে ১ শতাংশ বা ৫ শতাংশ রিকোয়েস্ট স্যাম্পলিং (Sampling) করুন, যা সিস্টেমের সামগ্রিক স্বাস্থ্য বোঝার জন্য যথেষ্ট।
কেস স্টাডি ৭: গ্লোবাল টেক জায়ান্টদের এন্ড-টু-এন্ড ব্লুপ্রিন্ট (URL Shortener, News Feed & Video Streaming)
এতক্ষণ আমরা FoodFast-এর জার্নি দিয়ে সিস্টেম ডিজাইনের বিভিন্ন লেয়ার এবং কম্পোনেন্ট বুঝতে পেরেছি। এখন আমরা আমাদের অর্জিত সমস্ত জ্ঞানকে একসাথে জোড়া দিয়ে দেখব বিশ্বের শীর্ষস্থানীয় প্রযুক্তি প্রতিষ্ঠানগুলো কীভাবে তাদের কোর প্রোডাক্টগুলো স্ক্র্যাচ থেকে ডিজাইন করে। নিচে তিনটি রিয়েল-ওয়ার্ল্ড এন্ড-টু-এন্ড ব্লুপ্রিন্ট আলোচনা করা হলো।
কেস স্টাডি ৭ক: URL Shortener ডিজাইন (Bitly বা TinyURL স্টাইল)
একটি URL Shortener সার্ভিসের মূল কাজ হলো একটি দীর্ঘ ওয়েব এড্রেসকে ছোট একটি ইউনিক লিঙ্কে রূপান্তর করা এবং সেই ছোট লিঙ্কে ক্লিক করলে ইউজারকে মূল দীর্ঘ লিঙ্কে রিডাইরেক্ট করা।
- ট্রেড-অফ ও রেশিও অ্যানালাইসিস: এই ধরনের সিস্টেমে নতুন লিঙ্ক তৈরির চেয়ে লিঙ্কগুলোতে ক্লিক পড়ার হার অনেক বেশি থাকে। আমরা ধরে নিই এর Read/Write Ratio হলো ১০:১। অর্থাৎ প্রতি সেকেন্ডে যদি ১০০টি নতুন লিঙ্ক তৈরি হয়, তবে প্রতি সেকেন্ডে ১ হাজারটি রিডাইরেক্ট রিকোয়েস্ট আসবে। তাই আমাদের সিস্টেমকে Read-Heavy পারফরম্যান্সের জন্য অপ্টিমাইজ করতে হবে।
- ইউনিক আইডি জেনারেশন ও এনকোডিং: একটি ছোট লিঙ্ক তৈরি করার জন্য আমাদের একটি ৭ অক্ষরের ইউনিক কি (Key) জেনারেশন করতে হবে। আমরা Base62 Encoding (a-z, A-Z, 0-9) ব্যবহার করি। ৭ অক্ষরের Base62 এনকোডিং দিয়ে আমরা বা প্রায় ৩ লক্ষ ৫০ হাজার কোটি ইউনিক লিঙ্ক তৈরি করতে পারি, যা আগামী ৫০ বছরের জন্য যথেষ্ট। এই ইউনিক কি জেনারেশনের জন্য আমরা ডেটাবেজ অটো-ইনক্রিমেন্টের ওপর নির্ভর না করে Distributed Sequence Generator যেমন Twitter Snowflake বা একটি ডেডিকেটেড Key Generation Service (KGS) ব্যবহার করি। KGS আগে থেকেই লাখ লাখ ইউনিক কি তৈরি করে মেমরিতে রেখে দেয়, ফলে নতুন লিঙ্ক তৈরির সময় কোনো ল্যাটেন্সি থাকে না।
- ডেটা লেয়ার ও ক্যাশিং: সমস্ত Short Key এবং Long URL ম্যাপিং আমরা একটি Horizontally Sharded NoSQL ডেটাবেজে (যেমন: DynamoDB বা Cassandra) সেভ করি, কারণ এখানে কোনো জটিল রিলেশনাল জয়েন কুয়েরির প্রয়োজন নেই। আর রিডাইরেক্ট ল্যাটেন্সি শূন্যের কোঠায় নামিয়ে আনার জন্য আমরা ডেটাবেজের সামনে বিশাল Redis Cache ক্লাস্টার বসাই। যখন কোনো ইউজার ছোট লিঙ্কে হিট করে, সিস্টেম প্রথমে Redis থেকে মূল লিঙ্কটি খুঁজে নেয় এবং ক্লায়েন্টকে
301 Permanent Redirectবা302 Temporary Redirectস্ট্যাটাস কোড দিয়ে মূল ওয়েবসাইটে পাঠিয়ে দেয়।
কেস স্টাডি ৭খ: News Feed সিস্টেম ডিজাইন (Facebook বা Twitter স্টাইল)
একটি সোশ্যাল মিডিয়া নিউজ ফিডের মূল চ্যালেঞ্জ হলো রিয়েল-টাইমে লাখ লাখ ইউজারের জন্য তাদের ফলো করা বন্ধুদের পোস্টগুলোকে সঠিক ক্রমানুসারে সাজিয়ে প্রদর্শন করা।
- ফ্যানআউট আর্কিটেকচার (Fan-out on Write vs Read): যখন কোনো ইউজার একটি নতুন পোস্ট করে, তখন সেই পোস্টটি তার সমস্ত ফলোয়ারের নিউজ ফিডে পৌঁছে দেওয়ার প্রক্রিয়াকে Fan-out বলা হয়। এখানে দুটি আর্কিটেকচারাল মডেল রয়েছে। প্রথমটি হলো Fan-out on Write (Push Model)। একজন সাধারণ ইউজার যখন পোস্ট করে, তখন আমাদের ব্যাকএন্ড সার্ভিস তার সমস্ত ফলোয়ারের লিস্ট বের করে এবং প্রতিটি ফলোয়ারের ইন-মেমরি ফিড ক্যাশে (Redis Timeline) সরাসরি পোস্টটি পুশ করে দেয়। এর সুবিধা হলো, ফলোয়ার যখন অ্যাপ খোলে, তখন তার ফিড আগে থেকেই তৈরি থাকে এবং লোড হতে কোনো সময় লাগে না।
- সেলেব্রেটি প্রবলেম ও হাইব্রিড সলিউশন: কিন্তু এই Push Model-এ একটি বড় সমস্যা হলো "Celebrity Problem"। ধরুন, কোনো বিখ্যাত সেলিব্রেটির ৫ কোটি ফলোয়ার রয়েছে। তিনি যখন একটি পোস্ট করবেন, তখন ৫ কোটি ইউজারের ক্যাশে সেই পোস্ট পুশ করতে গেলে আমাদের সার্ভারে বিশাল Write Storm তৈরি হবে এবং সিস্টেম ক্র্যাশ করতে পারে। তাই সেলিব্রেটিদের ক্ষেত্রে আমরা Fan-out on Read (Pull Model) ব্যবহার করি। সেলিব্রেটি পোস্ট করলে তা শুধুমাত্র তার নিজের টাইমলাইন ডেটাবেজে সেভ হয়। যখন তার কোনো ফলোয়ার অ্যাপ ওপেন করে, তখন আমাদের Feed Generation Service সাধারণ বন্ধুদের পোস্টগুলো ইন-মেমরি ক্যাশ থেকে নেয় এবং সেলিব্রেটির পোস্টটি মূল ডেটাবেজ থেকে Pull করে এনে একত্রিত করে ফিড তৈরি করে। এই হাইব্রিড মডেলটিই ফেসবুক এবং টুইটার প্রোডাকশনে ব্যবহার করে।
কেস স্টাডি ৭গ: Video Streaming প্ল্যাটফর্ম ডিজাইন (YouTube বা Netflix স্টাইল)
একটি ভিডিও স্ট্রিমিং প্ল্যাটফর্মের প্রধান চ্যালেঞ্জ হলো বিশাল আকারের ভিডিও ফাইল হ্যান্ডেল করা, নেটওয়ার্ক ব্যান্ডউইথ অপ্টিমাইজ করা এবং যেকোনো ইন্টারনেটের গতিতে বাফারিং ছাড়া ভিডিও প্রদর্শন করা।
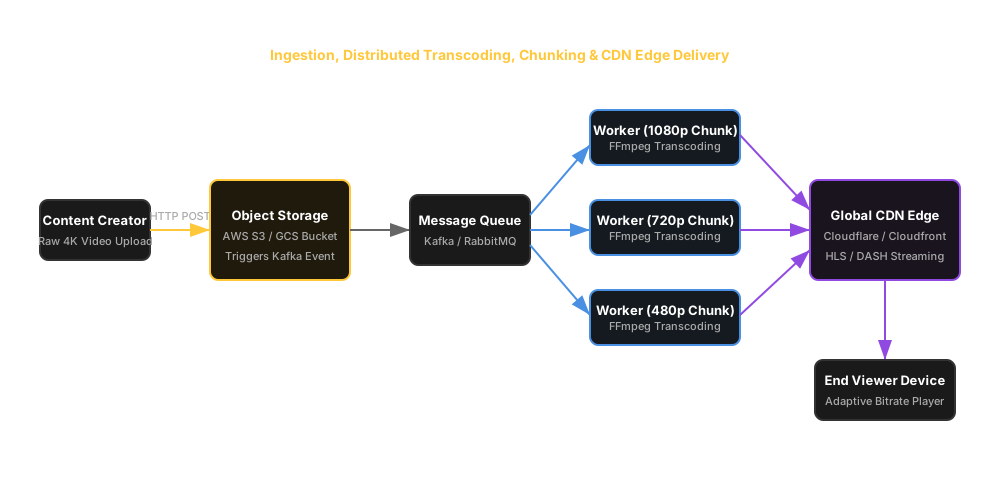
- ভিডিও ইনজেশন ও ডিস্ট্রিবিউটেড ট্রান্সকোডিং: যখন কোনো কন্টেন্ট ক্রিয়েটর একটি ৪কে (4K) রেজোলিউশনের র-ভিডিও আপলোড করে, তখন সেটি সরাসরি ক্লায়েন্টকে দেখানো অসম্ভব। আপলোড হওয়া ভিডিওটি প্রথমে একটি Object Storage (যেমন: AWS S3 বা Google Cloud Storage)-এ সেভ হয়। এরপর আমাদের সিস্টেম একটি Message Queue (Kafka)-এ একটি ট্রান্সকোডিং ইভেন্ট পুশ করে। আমাদের ব্যাকগ্রাউন্ডে থাকা শত শত Transcoding Workers সেই ইভেন্ট গ্রহণ করে এবং FFmpeg টুল ব্যবহার করে মূল ভিডিওটিকে বিভিন্ন রেজোলিউশনে (1080p, 720p, 480p, 360p) রূপান্তর বা Transcode করে।
- চাঙ্কিং ও অ্যাডাপ্টিভ বিটরেট স্ট্রিমিং (ABR): ট্রান্সকোডিং করার সময় প্রতিটি রেজোলিউশনের ভিডিওকে ছোট ছোট ২ থেকে ৪ সেকেন্ডের টুকরো বা Chunks-এ ভাগ করা হয় (যেমন:
.tsবা.m4sফাইল) এবং একটি Master Playlist বা Manifest ফাইল (যেমন:.m3u8বা.mpd) তৈরি করা হয়। এই পুরো প্রক্রিয়াকে Adaptive Bitrate Streaming (HLS বা DASH প্রোটোকল) বলা হয়। - সিডিএন এজ ডেলিভারি ও ক্লায়েন্ট প্লেয়ার: এই সমস্ত ছোট ছোট ভিডিও চঙ্ক এবং ম্যানিফেসট ফাইলগুলো আমরা Global CDN Edge Servers-এ পাঠিয়ে দিই। যখন কোনো ইউজার ভিডিও প্লে করে, তখন তার ব্রাউজারের ভিডিও প্লেয়ার প্রথমে ম্যানিফেসট ফাইলটি ডাউনলোড করে। ইউজারের ইন্টারনেটের গতি যদি ভালো থাকে, তবে প্লেয়ার স্বয়ংক্রিয়ভাবে 1080p রেজোলিউশনের চঙ্কগুলো সিডিএন থেকে ডাউনলোড করে প্লে করে। আর যদি ইন্টারনেটের গতি হঠাৎ কমে যায়, তবে প্লেয়ার ভিডিও থামিয়ে বাফারিং না করে পরবর্তী চঙ্কটি 360p রেজোলিউশনে ডাউনলোড করে স্মুথ প্লেব্যাক বজায় রাখে।
ডেভেলপার চেকলিস্ট ও প্রোডাকশন গাইডলাইন
একটি সফল সিস্টেম ডিজাইন হলো সঠিক সময়ে সঠিক ট্রেড-অফটি বেছে নেওয়া। আপনি যখনই কোনো নতুন প্রজেক্টের আর্কিটেকচার ডিজাইন করবেন বা পুরনো সিস্টেম রিফ্যাক্টর করবেন, তখন নিচের প্রোডাকশন-রেডি চেকলিস্টটি মিলিয়ে নেবেন। এটি আপনাকে সম্ভাব্য ইঞ্জিনিয়ারিং বিপর্যয় থেকে রক্ষা করবে।
- স্কেলেবিলিটি ও স্টেটলেসনেস: আপনার Web Server এবং API সার্ভারগুলো কি সম্পূর্ণ Stateless হিসেবে কনফিগার করা হয়েছে? কোনো সার্ভার হঠাৎ বন্ধ হয়ে গেলে ক্লায়েন্টের সেশন বা ডেটা নষ্ট হবে না তো?
- ক্যাশিং ও এক্সপাইরি পলিসি: আপনার ক্যাশ মেমরিতে কি সঠিক LRU বা LFU Eviction Policy সেট করা আছে? প্রতিটি ক্যাশ কি (Key)-এর সাথে কি যৌক্তিক TTL (Time To Live) নির্ধারণ করা হয়েছে যাতে মেমরি লিক না হয়?
- ডেটাবেজ ও ইনডেক্সিং: ডেটাবেজের যে কলামগুলো দিয়ে ঘন ঘন সার্চ বা ফিল্টার করা হয়, সেগুলোতে কি B-Tree Indexing করা হয়েছে? আপনার কুয়েরিগুলো কি Full Table Scan করছে নাকি Index Scan করছে তা
EXPLAIN ANALYZEচালিয়ে যাচাই করেছেন কি? - সিঙ্ক্রোনাস বনাম অ্যাসিঙ্ক্রোনাস: যে সমস্ত টাস্কের ইনস্ট্যান্ট উত্তরের প্রয়োজন নেই (যেমন: ইমেইল পাঠানো, পিডিএফ জেনারেশন, অ্যানালিটিক্স ডেটা সেভ করা), সেগুলো কি Message Queue (Kafka/RabbitMQ) দিয়ে ব্যাকগ্রাউন্ড ওয়ারকারে পাঠানো হচ্ছে?
- ফল্ট টলারেন্স ও সার্কিট ব্রেকার: থার্ড-পার্টি সার্ভিস বা মাইক্রোসার্ভিস কলের সময় কি সঠিক Timeout এবং Circuit Breaker Pattern ইমপ্লিমেন্ট করা হয়েছে, যাতে Cascading Failure রোধ করা যায়?
- রেট লিমিটিং ও সিকিউরিটি: আপনার API Gateway-তে কি Token Bucket অ্যালগরিদম ব্যবহার করে Rate Limiting কনফিগার করা আছে, যাতে হ্যাকারদের ও ক্ষতিকারক বট অ্যাটাক থেকে সার্ভার সুরক্ষিত থাকে?
- সিঙ্গেল পয়েন্ট অব ফেইলার (SPOF): আপনার আর্কিটেকচারের প্রতিটি লেয়ারে (লোড ব্যালেন্সার, ডেটাবেজ, ক্যাশ ক্লাস্টার) কি Redundancy বা ব্যাকআপ নোড রাখা হয়েছে? কোনো একটি মেশিন পুড়ে গেলেও কি সিস্টেম শূন্য ডাউনটাইমে চলতে পারবে?
- অবজারভেবিলিটি ও অ্যালার্টিং: প্রোডাকশন সার্ভারের রিয়েল-টাইম মেট্রিক্স (CPU, Memory, Latency) দেখার জন্য কি Prometheus এবং Grafana ড্যাশবোর্ড সেটআপ করা হয়েছে? কোনো সার্ভিস ডাউন হলে আপনার অন-কল ইঞ্জিনিয়ারের কাছে স্বয়ংক্রিয় অ্যালার্ট পৌঁছানোর ব্যবস্থা আছে কি?