Distributed Systems-এ Transactional Outbox Pattern এবং Idempotency আসলে Under-the-Hood কীভাবে কাজ করে?
On this page
মনোলিথিক আর্কিটেকচার থেকে মাইক্রোসার্ভিসে শিফট করার পর আমরা যে সবচেয়ে বড় এবং ভয়ঙ্কর সমস্যার মুখোমুখি হই, তা হলো Distributed Transactions এবং Data Consistency হ্যান্ডেল করা। মনোলিথিক অ্যাপ্লিকেশনে একটি সিঙ্গেল রিলেশনাল ডেটাবেজ থাকে, যেখানে আমরা খুব সহজেই ACID ট্রানজেকশন ব্যবহার করে ডেটার পারমাণবিকতা নিশ্চিত করতে পারি। কিন্তু যখন আমরা মাইক্রোসার্ভিস আর্কিটেকচারে চলে আসি, তখন প্রতিটি সার্ভিসের নিজস্ব ডেটাবেজ থাকে এবং সার্ভিসগুলো পরস্পরের সাথে যোগাযোগ করার জন্য নেটওয়ার্ক বা মেসেজ ব্রোকারের উপর নির্ভর করে। এই জায়গায় তৈরি হয় একটি জটিল আর্কিটেকচারাল মিস্ট্রি যা সঠিক সিস্টেমে সমাধান না করলে আপনার প্রোডাকশন ডেটাবেজ সাইলেন্টলি করাপ্টেড হয়ে যেতে পারে।
আজকের এই Deep Dive সেশনে আমরা সরাসরি কথা বলব কেন সাধারণ রিট্রাই মেকানিজম বা ট্রাই-ক্যাচ ব্লক লার্জ-স্কেল ডিস্ট্রিবিউটেড সিস্টেমে ফেইল করে, এবং কীভাবে Transactional Outbox Pattern ও Idempotent Consumer মেকানিজম ব্যবহার করে আমরা একটি প্রোডাকশন-গ্রেড, ফল্ট-টল্যারেন্ট সিস্টেম ডিজাইন করতে পারি। আসুন, একদম Under-the-hood লেভেল থেকে বিষয়টি বিশ্লেষণ করা যাক।
১. The Core Mystery এবং Why It Matters
যখন কোনো একটি সার্ভিস তার লোকাল ডেটাবেজ আপডেট করার পাশাপাশি একটি এক্সটার্নাল মেসেজ ব্রোকারে (যেমন: Apache Kafka বা RabbitMQ) ইভেন্ট পাবলিশ করে, তখন সেই প্যাটার্নটিকে আমরা বলি Dual-Write। আপাতদৃষ্টিতে এটি খুব সাধারণ এবং সহজ একটি লজিক মনে হতে পারে, কিন্তু সিস্টেম আর্কিটেকচারের দৃষ্টিকোণ থেকে এটি একটি মারাত্মক Anti-Pattern। আপনি যখন একই কোড ব্লকের ভেতরে দুটি সম্পূর্ণ ভিন্ন এবং স্বাধীন স্টোরেজ ইঞ্জিনে রাইট অপারেশন চালাতে যান, তখন নেটওয়ার্ক ল্যাটেন্সি এবং আংশিক ফেইলরের কারণে সিস্টেমটি খুব দ্রুত একটি ইনকন্সিস্টেন্ট স্টেটে চলে যায়।
ধরুন, আপনি একটি ই-কমার্স প্ল্যাটফর্মের Order Service তৈরি করছেন। যখন কোনো ইউজার একটি অর্ডার প্লেস করে, তখন আপনার কোড প্রথমে ডেটাবেজে অর্ডারের তথ্য সেভ করে এবং তারপর কাফকা ব্রোকারে একটি OrderCreated ইভেন্ট পাঠায় যাতে Inventory Service স্টক কমাতে পারে এবং Payment Service পেমেন্ট প্রসেস করতে পারে। এখন চিন্তা করুন, আপনার ডেটাবেজ ট্রানজেকশন সাকসেসফুল হলো এবং অর্ডার টেবিলে ডেটা সেভ হয়ে গেল, কিন্তু ঠিক সেই মুহূর্তে কাফকা ব্রোকার ডাউন হয়ে গেল অথবা আপনার নেটওয়ার্ক কানেকশন ড্রপ করল। ফলে কাফকাতে ইভেন্টটি পাবলিশ হলো না। এখন আপনার Order Service মনে করছে অর্ডার সফল, কিন্তু Inventory এবং Payment Service এই অর্ডারের ব্যাপারে কিছুই জানে না। এই অবস্থাকেই বলা হয় সাইলেন্ট ডেটা করাপশন, যা বিজনেস লজিককে পুরোপুরি ধ্বংস করে দেয়।
অনেক সিনিয়র ইঞ্জিনিয়ার এই সমস্যার সমাধানে সাধারণ ট্রাই-ক্যাচ ব্লক বা রিট্রাই মেকানিজমের উপর নির্ভর করেন। তারা মনে করেন, কাফকাতে ইভেন্ট পাঠানো ফেইল করলে কোড কয়েকবার রিট্রাই করবে অথবা এক্সেপশন থ্রো করে ডেটাবেজ ট্রানজেকশন রোলব্যাক করে দেবে। কিন্তু ডিস্ট্রিবিউটেড সিস্টেমে এই ধারণাটি সম্পূর্ণ ভুল। যদি আপনার মেসেজটি কাফকা ব্রোকারে ঠিকই পৌঁছায়, কিন্তু ব্রোকার থেকে আপনার অ্যাপ্লিকেশনে একনলেজমেন্ট আসার পথে নেটওয়ার্ক পার্টিশন হয়, তখন আপনার অ্যাপ্লিকেশন মনে করবে মেসেজটি যায়নি। ফলে আপনি যদি রিট্রাই করেন, তবে কাফকাতে একই মেসেজ দুইবার চলে যাবে। আবার যদি আপনি ডেটাবেজ রোলব্যাক করে দেন, তাহলে কাফকাতে মেসেজ থেকে যাবে অথচ ডেটাবেজে কোনো রেকর্ড থাকবে না। এই লজিক্যাল ডেথ ট্র্যাপ থেকে বের হওয়ার একমাত্র উপায় হলো ডেটাবেজের পারমাণবিক ক্ষমতা ব্যবহার করা।
২. The Foundational Mental Model এবং Analogy
Transactional Outbox Pattern-এর মূল কনসেপ্ট খুবই সহজ এবং চমৎকার। আমরা রিয়েল-টাইমে এক্সটার্নাল মেসেজ ব্রোকারে ডেটা পাঠানোর চেষ্টা পুরোপুরি বাদ দেব। এর পরিবর্তে, আমরা আমাদের লোকাল ডেটাবেজের পারমাণবিক ক্ষমতা বা ACID প্রোপার্টি ব্যবহার করব। যখন কোনো বিজনেস ট্রানজেকশন ঘটবে, তখন আমরা মূল বিজনেস টেবিলের সাথে একই ট্রানজেকশনের ভেতরে আরেকটি বিশেষ টেবিলে ইভেন্টের তথ্য সেভ করে রাখব। এই বিশেষ টেবিলটিকে বলা হয় outbox_messages টেবিল। যেহেতু দুটি টেবিলই একই ডেটাবেজের ভেতরে আছে এবং একই ট্রানজেকশনের অংশ, তাই ডেটাবেজ ইঞ্জিন গ্যারান্টি দেবে যে হয় দুটি টেবিলেই ডেটা সেভ হবে, অথবা কোনোটিতেই হবে না।
বিষয়টি পরিষ্কার করার জন্য আমরা একটি রিয়েল-ওয়ার্ল্ড অ্যানালজি বিবেচনা করতে পারি। ধরুন, আপনি একটি ব্যাংকের কাউন্টারে দাঁড়িয়ে আছেন এবং অন্য একটি ব্যাংকের অ্যাকাউন্টে টাকা পাঠাতে চান। ক্যাশিয়ার যদি সরাসরি আপনার সামনে দাঁড়িয়ে অন্য ব্যাংকের সার্ভারে রিয়েল-টাইমে কানেক্ট করার চেষ্টা করেন, এবং সেই মুহূর্তে তাদের নেটওয়ার্ক স্লো থাকে, তবে আপনার লেনদেন আটকে যাবে অথবা ভুল হবে। এর বদলে ক্যাশিয়ার যা করেন তা হলো: তিনি প্রথমে আপনার অ্যাকাউন্ট থেকে টাকা কাটার এন্ট্রি তার লোকাল লেজারে লিখে রাখেন, এবং ঠিক সেই লেজারেরই একটি আউটবক্স সেকশনে লিখে রাখেন যে অন্য ব্যাংকে একটি চেক পাঠাতে হবে। এই পুরো কাজটি তিনি এক কলমের খোঁচায় সম্পন্ন করেন। পরবর্তীতে ব্যাংকের ব্যাকগ্রাউন্ড স্টাফরা সেই আউটবক্স সেকশন থেকে চেকগুলো সংগ্রহ করে নিরাপদ সময়ে অন্য ব্যাংকে পাঠিয়ে দেয়।
ডিস্ট্রিবিউটেড সিস্টেমে এই মানসিক মডেলটিকে আমরা বলি Eventual Consistency। আমরা স্ট্রং কন্সিস্টেন্সি বা রিয়েল-টাইম সিঙ্ক্রোনাইজেশনের আশা ছেড়ে দিয়ে সিস্টেমকে এমনভাবে ডিজাইন করি যেন কিছু মিলিসেকেন্ড বা সেকেন্ডের মধ্যে পুরো সিস্টেমের ডেটা নিজেদের মধ্যে সিঙ্ক হয়ে যায়। হাই-স্কেল এবং হাই-থ্রুপুট সিস্টেমে রিয়েল-টাইম লকিং ব্যবহার করা অসম্ভব, তাই Eventual Consistency-ই প্রোডাকশন আর্কিটেকচারের একমাত্র বাস্তবসম্মত সমাধান।
৩. Under-The-Hood Architecture (The Core Deep Dive)
এখন আমরা দেখব এই পুরো প্রক্রিয়াটি Under-the-hood বা ইঞ্জিনের একদম মেমোরি ও ডিস্ক লেভেলে কীভাবে কাজ করে। আপনি যখন রিলেশনাল ডেটাবেজে (যেমন: PostgreSQL বা MySQL) একটি ট্রানজেকশন শুরু করেন, তখন ডেটাবেজ ইঞ্জিন সরাসরি আপনার মেইন ডেটা ফাইলে হাত দেয় না। এর পরিবর্তে সে Write-Ahead Log (WAL) নামক একটি অপ্টিমাইজড, সিকোয়েনশিয়াল ডিস্ক ফাইলে আপনার পরিবর্তনের নির্দেশগুলো রেকর্ড করে। আপনি যখন একই ট্রানজেকশনের ভেতরে orders টেবিল এবং outbox_messages টেবিলে ডেটা ইনসার্ট করেন, তখন ডেটাবেজ ইঞ্জিন সেই দুটি রাইট অপারেশনকে একই WAL এন্ট্রির অংশ হিসেবে মেমোরি বাফারে এবং পরবর্তীতে ডিস্কে ফ্লাশ করে।
যখন আপনি COMMIT কমান্ড দেন, তখন ডেটাবেজ ইঞ্জিন নিশ্চিত করে যে WAL ফাইলে দুটি টেবিলের পরিবর্তনই পারমাণবিক বা Atomic ভাবে লেখা হয়েছে। যদি ডিস্ক রাইট হওয়ার সময় কারেন্ট চলে যায় বা সার্ভার ক্র্যাশ করে, তবে ডেটাবেজ রিস্টার্ট হওয়ার সময় WAL ফাইল রিড করে পুরো ট্রানজেকশনটি রোলব্যাক করে দেবে। ফলে আপনার বিজনেস ডেটা এবং আউটবক্স ইভেন্টের মধ্যে ১oo% সিঙ্ক বজায় থাকে। এখানে কোনো এক্সটার্নাল নেটওয়ার্ক কলের ঝুঁকি নেই, কারণ পুরো প্রসেসটি ডেটাবেজের ইন্টারনাল স্টোরেজ ইঞ্জিনের ভেতরেই ঘটছে।
আউটবক্স প্যাটার্ন আমাদের ডেটাবেজ লেভেলে কন্সিস্টেন্সি দিলেও, মেসেজ ব্রোকার থেকে কনজিউমার সার্ভিসে ডেটা যাওয়ার সময় আমাদের Message Delivery Guarantees নিয়ে খুব সতর্ক থাকতে হয়। ডিস্ট্রিবিউটেড সিস্টেমে তিন ধরনের ডেলিভারি গ্যারান্টি দেখা যায়: At-most-once, At-least-once, এবং Exactly-once। আউটবক্স প্যাটার্ন ডিফল্টভাবে আমাদের At-least-once ডেলিভারি গ্যারান্টি প্রদান করে। এর মানে হলো, আপনার ইভেন্টটি কমপক্ষে একবার কনজিউমার সার্ভিসের কাছে পৌঁছাবেই, কিন্তু নেটওয়ার্ক রিট্রাই বা ফেইলর রিকভারির কারণে একই ইভেন্ট একাধিকবারও পৌঁছাতে পারে।
অনেকেই মনে করেন কাফকা বা আধুনিক ব্রোকারগুলো Exactly-once ডেলিভারি দিতে পারে, কিন্তু ডিস্ট্রিবিউটেড সিস্টেমের লো-লেভেল রিয়েলিটিতে End-to-End Exactly-once ডেলিভারি থিওরিটিক্যালি এবং প্র্যাকটিক্যালি অসম্ভব। ব্রোকার হয়তো তার নিজের লেয়ারে ডুপ্লিকেট আটকাতে পারে, কিন্তু নেটওয়ার্ক ল্যাটেন্সির কারণে আপনার ব্যাকগ্রাউন্ড পোলার বা কনজিউমার সার্ভিস একই মেসেজ দুইবার প্রসেস করতেই পারে। তাই প্র্যাকটিক্যাল প্রোডাকশন আর্কিটেকচারে আমরা সবসময় At-least-once ডেলিভারি গ্যারান্টির সাথে কনজিউমার এন্ডে Idempotency লজিক যুক্ত করে Exactly-once প্রসেসিং নিশ্চিত করি।
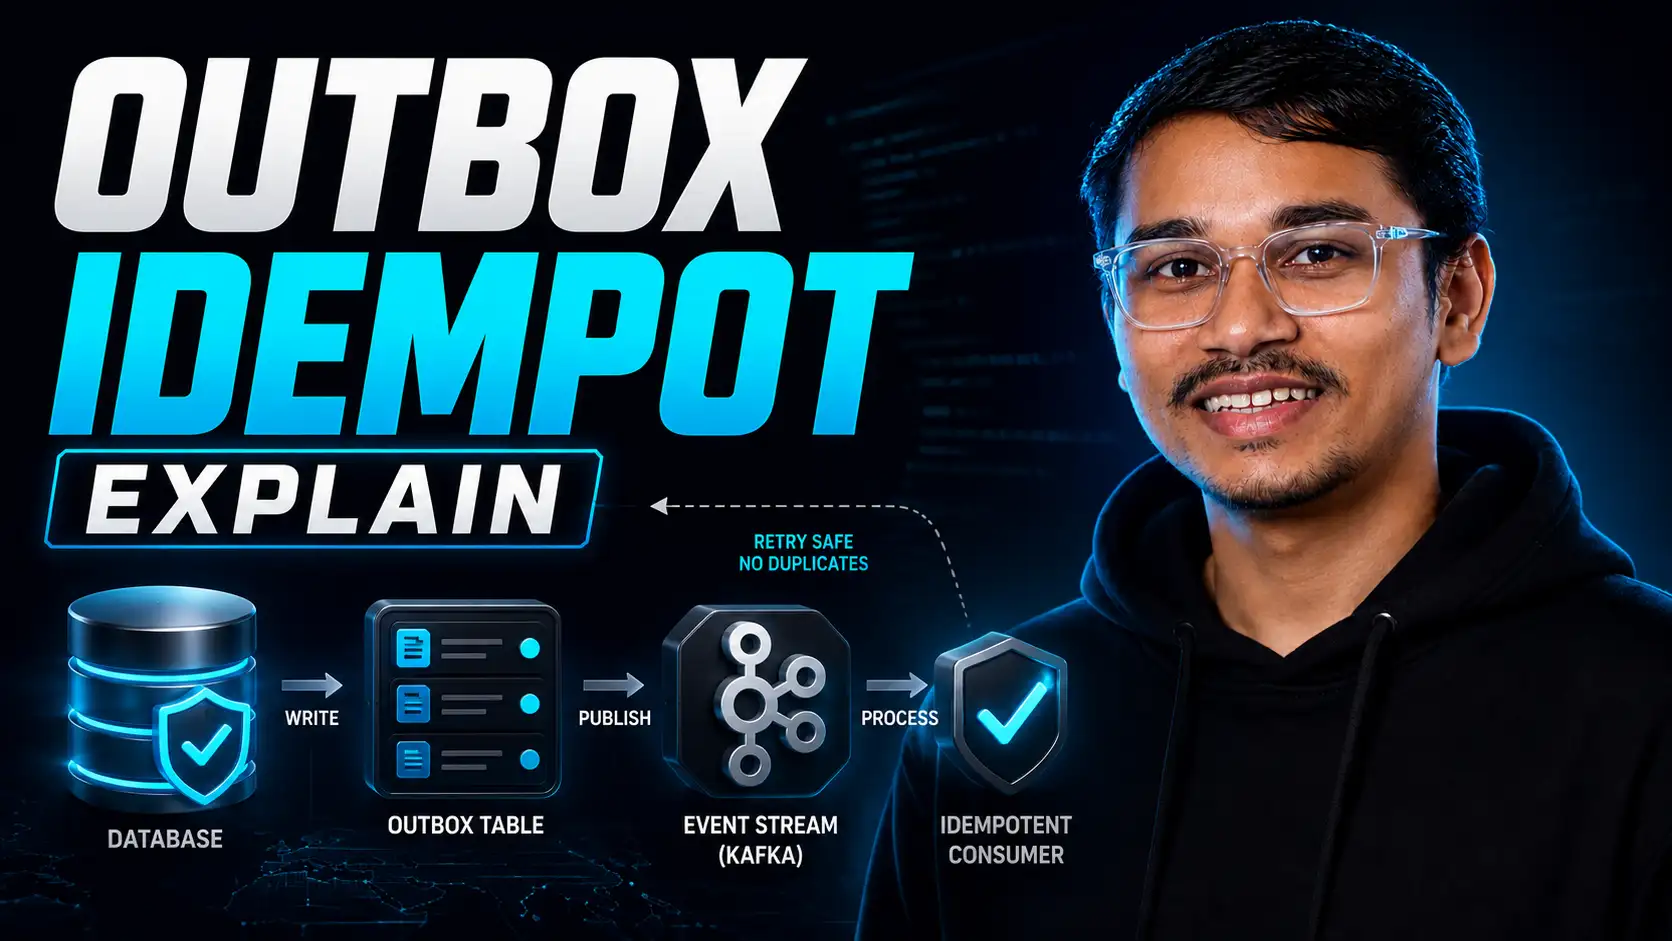
উপরে দেখানো আর্কিটেকচারাল ডায়াগ্রামটিতে আপনি দেখতে পাচ্ছেন কীভাবে আমাদের মূল অ্যাপ্লিকেশন একটি একক ট্রানজেকশনের মাধ্যমে ডেটাবেজের বিজনেস টেবিল এবং আউটবক্স টেবিল আপডেট করছে। পরবর্তীতে একটি ব্যাকগ্রাউন্ড প্রসেস বা Change Data Capture (CDC) ইঞ্জিন সেই আউটবক্স টেবিল থেকে ডেটা রিড করে মেসেজ ব্রোকারে পাঠাচ্ছে, যা শেষ পর্যন্ত কনজিউমার সার্ভিস রিসিভ করে ইডেমপোটেন্সি চেক করার মাধ্যমে প্রসেস করছে।
৪. Step-by-Step Execution Trace এবং Code Mechanics
একটি প্রোডাকশন-রেডি আর্কিটেকচার ডিজাইন করার জন্য আমাদের প্রথমে ডেটাবেজ স্কিমা এবং ব্যাকএন্ড কোডের মেকানিজম বুঝতে হবে। আসুন আমরা ধাপে ধাপে পুরো এক্সিকিউশন ট্রেসটি দেখে নিই।
ধাপ ১: SQL Schema Design-এর ব্লুপ্রিন্ট
আমাদের ডেটাবেজে আউটবক্স মেসেজগুলো স্টোর করার জন্য একটি সুনির্দিষ্ট স্কিমা প্রয়োজন। এই টেবিলে ইভেন্টের পেলোড, স্ট্যাটাস এবং রিট্রাই ট্র্যাকিংয়ের ব্যবস্থা থাকতে হবে। একই সাথে কনজিউমার সার্ভিসের ডেটাবেজে ডুপ্লিকেট মেসেজ রোখার জন্য একটি ইডেমপোটেন্সি টেবিল তৈরি করতে হবে।
-- প্রডিউসার সার্ভিসের ডেটাবেজে Outbox টেবিলCREATE TABLE outbox_messages (    id UUID PRIMARY KEY DEFAULT gen_random_uuid(),    aggregate_type VARCHAR(255) NOT NULL, -- যেমন: 'ORDER'    aggregate_id VARCHAR(255) NOT NULL,   -- যেমন: Order ID    event_type VARCHAR(255) NOT NULL,     -- যেমন: 'ORDER_CREATED'    payload JSONB NOT NULL,               -- সম্পূর্ণ ইভেন্ট ডেটা    status VARCHAR(50) DEFAULT 'PENDING', -- PENDING, PROCESSED, FAILED    retry_count INT DEFAULT 0,    created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP,    processed_at TIMESTAMP WITH TIME ZONE);
-- কনজিউমার সার্ভিসের ডেটাবেজে Idempotency টেবিলCREATE TABLE idempotent_consumers (    message_id UUID PRIMARY KEY,          -- Outbox টেবিলের ID এখানে ইউনিক কি হিসেবে বসবে    processed_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP,    status VARCHAR(50) NOT NULL           -- SUCCESS বা FAILED);
ধাপ ২: Atomic Transaction-এর ইমপ্লিমেন্টেশন কোড
এখন আমরা Node.js এবং Prisma ORM ব্যবহার করে দেখব কীভাবে একটি একক ট্রানজেকশন ব্লকের ভেতরে অর্ডার ক্রিয়েট এবং আউটবক্স এন্ট্রি ইনসার্ট করা হয়। এখানে আমরা কোনো এক্সটার্নাল কাফকা বা নেটওয়ার্ক কল করব না।
import { PrismaClient } from '@prisma/client';import { randomUUID } from 'crypto';
const prisma = new PrismaClient();
async function createOrderWithOutbox(userId: string, totalAmount: number, items: any[]) {  const orderId = randomUUID();  const eventId = randomUUID();
  // একটি একক Atomic Transaction শুরু করা হচ্ছে  try {    const result = await prisma.$transaction(async (tx) => {      // ১. মূল বিজনেস টেবিলে অর্ডার সেভ করা      const newOrder = await tx.orders.create({        data: {          id: orderId,          userId: userId,          totalAmount: totalAmount,          status: 'CREATED',        },      });
      // ২. আউটবক্স টেবিলে ইভেন্ট পেলোড সেভ করা      await tx.outbox_messages.create({        data: {          id: eventId,          aggregate_type: 'ORDER',          aggregate_id: orderId,          event_type: 'ORDER_CREATED',          payload: JSON.stringify({            orderId: newOrder.id,            userId: newOrder.userId,            amount: newOrder.totalAmount,            items: items,          }),          status: 'PENDING',        },      });
      return newOrder;    });
    console.log(`Order and Outbox entry created atomically with ID: ${result.id}`);    return result;  } catch (error) {    // ডেটাবেজে কোনো সমস্যা হলে দুটি টেবিলের রাইট অপারেশনই একসাথে রোলব্যাক হয়ে যাবে    console.error('Failed to execute atomic transaction, rollback completed.', error);    throw error;  }}
Warning
External Network Calls Inside DB Transactions: আপনার লোকাল ডেটাবেজ ট্রানজেকশনের ভেতরে কখনোই এক্সটার্নাল মেসেজ ব্রোকারের পাবলিশ কোড (যেমন: await kafka.send()) রাখবেন না। এক্সটার্নাল নেটওয়ার্ক কল যদি কোনো কারণে স্লো হয় বা টাইমআউট হয়, তবে তা আপনার মূল ডেটাবেজের কানেকশন পুল লকিং পিরিয়ড বাড়িয়ে দেবে। এর ফলে অন্য ইউজাররা ডেটাবেজ কানেকশন পাবে না এবং পুরো অ্যাপ্লিকেশন ক্যাসকেডিং ফেইলরের মাধ্যমে ডাউন হয়ে যাবে।
ধাপ ৩: The Outbox Publisher (Poller vs CDC)
আমাদের ডেটাবেজে এখন ইভেন্টগুলো PENDING স্টেটে জমা হচ্ছে। এগুলোকে মেসেজ ব্রোকারে পাঠানোর জন্য আমাদের একটি ব্যাকগ্রাউন্ড ওয়ার্কার প্রয়োজন। এই কাজটির জন্য মূলত দুটি মেকানিজম ব্যবহার করা হয়: Custom Polling এবং Change Data Capture (CDC)।
কাস্টম পোলিং মেকানিজমে আপনার অ্যাপ্লিকেশনে একটি ক্রন-জব বা ব্যাকগ্রাউন্ড থ্রেড থাকে, যা প্রতি কয়েক মিলিসেকেন্ড পর পর ডেটাবেজে SELECT * FROM outbox_messages WHERE status = 'PENDING' ORDER BY created_at ASC LIMIT 100 কুয়েরি চালায়। মেসেজগুলো রিড করে সে কাফকাতে পাঠায় এবং পাঠানোর পর ডেটাবেজে মেসেজের স্ট্যাটাস PROCESSED করে দেয়। ছোট বা মাঝারি স্কেলের অ্যাপ্লিকেশনের জন্য এটি চমৎকার কাজ করে, কিন্তু হাই-থ্রুপুট সিস্টেমে এটি ডেটাবেজের উপর মারাত্মক রিড-রাইট প্রেসার তৈরি করে।
এই সমস্যার প্রোডাকশন সমাধান হলো Change Data Capture (CDC) টুল ব্যবহার করা, যার মধ্যে Debezium সবচেয়ে জনপ্রিয়। Debezium সরাসরি আপনার ডেটাবেজে কোনো কুয়েরি চালায় না। এর পরিবর্তে সে আপনার ডেটাবেজ ইঞ্জিনের Write-Ahead Log (WAL) বা বাইনারি লগ ফাইলকে লো-লেভেল বাইট স্ট্রিম হিসেবে সরাসরি রিড করে। যখনই outbox_messages টেবিলে কোনো নতুন রো ইনসার্ট হয়, Debezium সেই লগ ফাইল থেকে ইভেন্টটি ধরে ফেলে এবং মিলিসেকেন্ডের মধ্যে কোনো ডেটাবেজ লকিং ছাড়াই কাফকা ব্রোকারে পুশ করে দেয়।
উপরে দেখানো টাইমলাইন ডায়াগ্রামটিতে আপনি ক্লায়েন্ট রিকোয়েস্ট আসার পর থেকে শুরু করে ডেটাবেজ কমিট, সিডিসি ইঞ্জিনের লগ রিডিং, কাফকা ব্রোকারে মেসেজ পাবলিশ এবং কনজিউমার সার্ভিসের ইডেমপোটেন্ট প্রসেসিং পর্যন্ত পুরো এক্সিকিউশন ফ্লোটির মিলিসেকেন্ড-লেভেল ট্রেস দেখতে পাচ্ছেন।
৫. Distributed Failure Modes (What Breaks & How to Fix)
একটি আর্কিটেকচার কতটুকু শক্তিশালী তা বোঝা যায় সিস্টেম ফেইল করার সময় সে কেমন আচরণ করে তা দেখে। আসুন আমরা ডিস্ট্রিবিউটেড সিস্টেমের তিনটি বাস্তব ফেইলর সিনারিও এবং সেগুলোর আর্কিটেকচারাল সমাধান বিশ্লেষণ করি।
সিনারিও ১: মেসেজ ব্রোকার সম্পূর্ণ ডাউন (Broker Goes Down)
- The Architectural Disaster: আপনার আউটবক্স পাবলিশার বা সিডিসি ইঞ্জিন কাফকা ব্রোকারে মেসেজ পাঠানোর চেষ্টা করছে, কিন্তু ব্রোকার ক্র্যাশ করার কারণে কোনো কানেকশন তৈরি হচ্ছে না। ফলে আউটবক্স টেবিলে হাজার হাজার
PENDINGমেসেজের ব্যাকলগ তৈরি হচ্ছে এবং ব্যাকগ্রাউন্ড ওয়ার্কার বারবার রিট্রাই করে ডেটাবেজের কানেকশন পুল এক্সজস্ট করে ফেলছে। - The Structural Solution: এই পরিস্থিতিতে আপনাকে Exponential Backoff with Jitter মেকানিজম ইমপ্লিমেন্ট করতে হবে। ব্যাকগ্রাউন্ড ওয়ার্কার ইমিডিয়েটলি রিট্রাই না করে প্রতিবার ফেইল করার পর অপেক্ষার সময় বাড়িয়ে দেবে (যেমন: ২ সেকেন্ড, ৪ সেকেন্ড, ৮ সেকেন্ড, ১৬ সেকেন্ড)। এর সাথে একটি রেন্ডম টাইম বা Jitter যোগ করতে হবে যাতে সমস্ত ওয়ার্কার একই সময়ে ডেটাবেজ বা ব্রোকারে হিট করে Thundering Herd প্রবলেম তৈরি না করে।
সিনারিও ২: ডুপ্লিকেট মেসেজ ডেলিভারি (Dual Message Delivery)
- The Structural Solution: এই সমস্যার সমাধান হলো কনজিউমার সার্ভিসে Idempotent Consumer Layer তৈরি করা। যখন কোনো মেসেজ কনজিউমারে আসবে, তখন সে সরাসরি বিজনেস লজিক এক্সিকিউট করবে না। সে প্রথমে মেসেজের ইউনিক
message_idনিয়ে নিজের ডেটাবেজেরidempotent_consumersটেবিলে চেক করবে। যদি আইডিটি আগে থেকেই থাকে, তবে সে অপারেশনটি স্কিপ করবে এবং কাফকাকে সাকসেস একনলেজমেন্ট পাঠিয়ে দেবে। আর যদি আইডিটি না থাকে, তবে সে একই ডেটাবেজ ট্রানজেকশনের ভেতরে বিজনেস লজিক এক্সিকিউট করবে এবংidempotent_consumersটেবিলে সেই আইডিটি ইনসার্ট করবে।
Tip
High-Throughput Distributed Locking: ইডেমপোটেন্সি চেক করার সময় যদি আপনার কনজিউমার সার্ভিসে প্রতি সেকেন্ডে লাখ লাখ রিকোয়েস্ট আসে, তবে বারবার ডেটাবেজে রিড-রাইট করা ডেটাবেজকে স্লো করতে পারে। এই ধরনের হাই-থ্রুপুট সিনারিওতে আপনি Redis Distributed Lock (যেমন: Redlock অ্যালগরিদম) ব্যবহার করে মেমোরি লেভেলেই ইডেমপোটেন্সি চেক সম্পন্ন করতে পারেন। তবে মনে রাখবেন, ফাইনাল সেফটি নেট হিসেবে ডেটাবেজ লেভেলে ইউনিক কনস্ট্রেইন্ট (Unique Key Constraint) রাখাটাই সবচেয়ে সেফ ডেটা গার্ড।
সিনারিও ৩: আউট-অফ-অর্ডার ইভেন্ট প্রসেসিং (Out-of-Order Events)
- The Architectural Disaster: নেটওয়ার্ক ল্যাটেন্সি বা কাফকা পার্টিশন রি-ব্যালেন্সিংয়ের কারণে মেসেজের ক্রম পরিবর্তন হয়ে গেছে। ধরুন,
Order_Createdইভেন্ট আসার আগেই কোনোভাবেOrder_UpdatedবাOrder_Cancelledইভেন্ট কনজিউমার সার্ভিসে চলে এসেছে। কনজিউমার যদি এই ইভেন্টটি আগে প্রসেস করে, তবে সে ডেটাবেজে কোনো অর্ডার খুঁজে পাবে না এবং পুরো প্রসেস ফেইল করবে। - The Structural Solution: এই সমস্যা সমাধানের জন্য আপনার ইভেন্ট পেলোডে ডেটাবেজের Incremental Version বা Timestamp ট্র্যাকিং রাখতে হবে। কনজিউমার সার্ভিসে একটি State Machine লজিক থাকবে যা চেক করবে ইনকামিং ইভেন্টের ভার্সন কারেন্ট ডেটাবেজ রেকর্ডের ভার্সনের চেয়ে বড় কিনা। যদি কোনো ইভেন্ট আউট-অফ-অর্ডার আসে, তবে কনজিউমার সেটিকে একটি Dead Letter Queue (DLQ) বা সাময়িক বাফারে রেখে দেবে এবং সঠিক ক্রমের ইভেন্ট আসার পর সেটিকে রি-প্রসেস করবে।
৬. High-Throughput Performance Tuning
যখন আপনার সিস্টেমে প্রতি সেকেন্ডে ১০,০০০ বা তার বেশি ইভেন্ট জেনারেট হয়, তখন সাধারণ ইমপ্লিমেন্টেশন খুব দ্রুত পারফরম্যান্স বটেলনেকে পরিণত হয়। এই লার্জ স্কেলে পারফরম্যান্স ড্রপ ছাড়াই সিস্টেম চালানোর জন্য কিছু লো-লেভেল অপ্টিমাইজেশন লজিক প্রয়োগ করতে হয়।
প্রথমত, আমরা কেন প্রোডাকশনে কাস্টম পোলিংয়ের চেয়ে Change Data Capture (CDC) বা Debezium-কে বেছে নিই তার টেকনিক্যাল জাস্টিফিকেশন বোঝা দরকার। আপনি যখন প্রতি সেকেন্ডে শত শত বার SELECT * FROM outbox_messages WHERE status = 'PENDING' কুয়েরি চালান, তখন ডেটাবেজ ইঞ্জিনকে বারবার টেবিল স্ক্যান করতে হয়। এছাড়া, মেসেজ প্রসেস হওয়ার পর যখন আপনি হাজার হাজার রেকর্ডের স্ট্যাটাস আপডেট করেন (UPDATE outbox_messages SET status = 'PROCESSED'), তখন ডেটাবেজে Row-level Lock তৈরি হয়। এই লকিং এবং কনস্ট্যান্ট রিড-রাইট আপনার মূল বিজনেস ট্রানজেকশনকে মারাত্মকভাবে স্লো করে দেয়। অন্যদিকে, Debezium সরাসরি ডেটাবেজের স্টোরেজ ইঞ্জিনের বাইরে থেকে WAL ফাইল রিড করে। ফলে ডেটাবেজের উপর রিড বা লকিংয়ের কোনো প্রেসারই পড়ে না, এবং আপনার মূল অ্যাপ্লিকেশন সর্বোচ্চ পারফরম্যান্সে কাজ করতে পারে।
দ্বিতীয়ত, যদি আপনি ছোট স্কেলে পোলিং মেকানিজম ব্যবহার করতেই চান, তবে আপনার ডেটাবেজে একটি অপ্টিমাইজড Indexing Strategy থাকতে হবে। আউটবক্স টেবিলে শুধুমাত্র status কলামের উপর ইনডেক্স তৈরি করলে সেটি খুব একটা লাভজনক হয় না, কারণ টেবিলে বেশিরভাগ রেকর্ডের স্ট্যাটাসই একসময় PROCESSED হয়ে যায় (Low Cardinality)। এর বদলে আপনাকে (status, created_at) কলামের উপর একটি কম্পোজিট বি-ট্রি (B-Tree) ইনডেক্স তৈরি করতে হবে। এতে ডেটাবেজ ইঞ্জিন কোনো ফুল টেবিল স্ক্যান ছাড়াই একদম ও-অফ-লগ-এন টাইম কমপ্লেক্সিটিতে দ্রুততম সময়ের মধ্যে সবচেয়ে পুরনো পেন্ডিং মেসেজগুলো খুঁজে বের করতে পারবে।
তৃতীয়ত, মেসেজ ব্রোকারে ডেটা পাঠানোর সময় সিঙ্গেল নেটওয়ার্ক কলের বদলে Batching & Pipelining ব্যবহার করতে হবে। প্রতিবার একটি মেসেজ রিড করে কাফকাতে পাঠানোর জন্য টিসিপি (TCP) হ্যান্ডশেক এবং নেটওয়ার্ক রাউন্ড-ট্রিপ টাইম (RTT) নষ্ট করা বোকামি। এর বদলে আপনি একবারে ৫০০ বা ১০০০ মেসেজ মেমোরি বাফারে রিড করবেন এবং কাফকা প্রডিউসারের ব্যাচিং এপিআই ব্যবহার করে সিঙ্গেল নেটওয়ার্ক রিকোয়েস্টে পুরো পে-লোডটি পাঠিয়ে দেবেন। এতে আপনার নেটওয়ার্ক থ্রুপুট বহুগুণ বেড়ে যাবে এবং সিস্টেম ল্যাটেন্সি ড্রাস্টিক্যালি কমে আসবে।
Important
Outbox Table Cleanup / Purge Policy: আউটবক্স টেবিলকে কখনোই পার্মানেন্ট স্টোরেজ হিসেবে ব্যবহার করবেন না। মেসেজ সাকসেসফুলি ব্রোকারে পাবলিশ হওয়ার পর টেবিলটিতে কোটি কোটি PROCESSED রেকর্ড জমে যেতে পারে। এই অতিরিক্ত ডেটা টেবিলের সাইজ বাড়িয়ে দেয় এবং ইনডেক্সগুলোকে স্লো করে ফেলে। একটি নির্দিষ্ট সময় পর পর (যেমন: প্রতিদিন রাত ৩টায়) পুরনো প্রসেসড রেকর্ডগুলো ডিলিট বা আর্কাইভ করার জন্য একটি ডেডিকেটেড ক্রন-জব বা Purge Policy চালু রাখা বাধ্যতামূলক।
৭. Alternative Solutions & Trade-off Matrix
একজন সিনিয়র আর্কিটেক্টের মূল দায়িত্ব হলো অন্ধভাবে কোনো প্যাটার্ন ইমপ্লিমেন্ট না করে বিভিন্ন সলিউশনের ট্রেড-অফ বা সুবিধা-অসুবিধা বিশ্লেষণ করা। আউটবক্স প্যাটার্ন ছাড়াও ইন্ডাস্ট্রিতে ডেটা কন্সিস্টেন্সি হ্যান্ডেল করার জন্য আরও কিছু পদ্ধতি রয়েছে। আসুন আমরা সেগুলোর সাথে একটি সরাসরি তুলনা দেখে নিই।
টু-ফেজ কমিট (2PC) হলো একটি ক্লাসিক ডিস্ট্রিবিউটেড ট্রানজেকশন প্রটোকল, যেখানে একটি কোঅর্ডিনেটর সার্ভিস সমস্ত ডেটাবেজ এবং ব্রোকারকে প্রথমে ট্রানজেকশনের জন্য প্রস্তুত হতে বলে (Prepare Phase) এবং সবাই রাজি হলে একসাথে কমিট করার নির্দেশ দেয় (Commit Phase)। এটি স্ট্রং কন্সিস্টেন্সি গ্যারান্টি দেয়, কিন্তু এর সবচেয়ে বড় সমস্যা হলো এটি একটি ব্লকিং প্রটোকল। কোনো একটি নোড স্লো হলে পুরো সিস্টেমের সমস্ত ট্রানজেকশন লক হয়ে বসে থাকে, যা আধুনিক হাই-স্কেল মাইক্রোসার্ভিসে সম্পূর্ণ অচল।
নিচের কম্প্যারিসন টেবিল থেকে আপনি বিভিন্ন আর্কিটেকচারাল অ্যাপ্রোচের ট্রেড-অফ খুব সহজেই বুঝতে পারবেন:
| Architectural Approach | Data Consistency | System Complexity | Performance / Latency |
|---|---|---|---|
| Dual Write (Anti-Pattern) | Very Low (Partial failure prone) | Low | Low Latency (High Risk) |
| Two-Phase Commit (2PC) | High (Strict synchronous) | Very High | High Latency (Blocking) |
| Transactional Outbox | Guaranteed Eventual Consistency | Medium | Low Latency (Asynchronous) |
এই ম্যাট্রিক্স থেকে স্পষ্ট দেখা যাচ্ছে যে, আমরা যখন সিস্টেম কমপ্লেক্সিটি এবং ল্যাটেন্সির মধ্যে একটি সঠিক ব্যালেন্স চাই, তখন Transactional Outbox Pattern আমাদের সবচেয়ে নির্ভরযোগ্য এবং প্রোডাকশন-রেডি সমাধান প্রদান করে।
৮. Summary & Production Decision Rules
পুরো Deep Dive সেশন থেকে আমরা যা শিখলাম, তা এখন আপনার দৈনন্দিন কোডিং এবং সিস্টেম ডিজাইনে প্রয়োগ করার সময় এসেছে। কিন্তু মনে রাখবেন, সব জায়গায় এই প্যাটার্ন ব্যবহার করার প্রয়োজন নেই। একটি সঠিক আর্কিটেকচারাল সিদ্ধান্ত নেওয়ার জন্য নিচের প্রোডাকশন ডিসিশন রুলসগুলো মেনে চলুন:
- কখন আউটবক্স প্যাটার্ন ব্যবহার করবেন: যদি আপনার অ্যাপ্লিকেশনে এমন কোনো বিজনেস ট্রানজেকশন থাকে যেখানে ডেটা লস হওয়া বা ইনকন্সিস্টেন্ট হওয়া কোনোভাবেই গ্রহণযোগ্য নয়-যেমন ফাইনান্সিয়াল ট্রানজেকশন, পেমেন্ট প্রসেসিং, অর্ডার প্লেসমেন্ট, বা ইনভেন্টরি ম্যানেজমেন্ট-তবে সেখানে Transactional Outbox এবং Idempotency ব্যবহার করা বাধ্যতামূলক।
- কখন সাধারণ ইভেন্ট পাবলিশিং যথেষ্ট: যদি আপনার ইভেন্টটি শুধুমাত্র কোনো অ্যানালিটিক্স ডেটা, ইউজার অ্যাক্টিভিটি ট্র্যাকিং, বা নন-ক্রিটিক্যাল নোটিফিকেশন পাঠানোর জন্য হয়, যেখানে দুই-একটি মেসেজ হারিয়ে গেলে বা ডুপ্লিকেট হলে বিজনেসে কোনো ক্ষতি হবে না, সেখানে আপনি সরাসরি ব্রোকারে ইভেন্ট পাঠাতে পারেন। সেখানে আউটবক্স প্যাটার্নের অতিরিক্ত কমপ্লেক্সিটি যোগ করার কোনো প্রয়োজন নেই।
- আর্কিটেক্ট মাইন্ডসেট শিফট: একজন জুনিয়র বা মিড-লেভেল ডেভেলপার সবসময় মনে করে যে তার কোড এবং নেটওয়ার্ক সবসময় ১oo% পারফেক্টলি কাজ করবে। কিন্তু একজন সিনিয়র আর্কিটেক্ট কোড লেখার সময় ডিফল্টভাবেই ধরে নেন যে নেটওয়ার্ক ফেইল করবে, ডেটাবেজ স্লো হবে, এবং মেসেজ ডুপ্লিকেট হবে। এই মানসিকতার পরিবর্তনই আপনাকে একটি সাধারণ অ্যাপ্লিকেশন তৈরি করা থেকে একটি রেজিলিয়েন্ট, ফল্ট-টল্যারেন্ট ডিস্ট্রিবিউটেড সিস্টেম ডিজাইন করার দিকে এগিয়ে নিয়ে যাবে।
ডিস্ট্রিবিউটেড সিস্টেমের এই Under-the-hood মেকানিজমগুলো সঠিকভাবে বুঝতে পারলে এবং আপনার প্রোডাকশন আর্কিটেকচারে ইমপ্লিমেন্ট করতে পারলে, আপনার সিস্টেম যেকোনো হাই-ট্রাফিক লোড বা নেটওয়ার্ক ফেইলর অত্যন্ত সাবলীলভাবে হ্যান্ডেল করতে সক্ষম হবে।