Cloudflare WAF দিয়ে AI Crawlers ব্লক করুন (SEO ট্রাফিক ঠিক রেখে)
আজকালকার দিনে AI Scraper এবং LLM Crawlers (যেমন ChatGPT-User, ClaudeBot, Perplexity) কোনো পারমিশন ছাড়াই ওয়েবসাইটের পুরো কনটেন্ট স্ক্র্যাপ করে নিয়ে যাচ্ছে। এর ফলে আপনার সার্ভার রিসোর্স এবং Bandwidth অযথা নষ্ট হচ্ছে, কিন্তু সাইট কোনো অর্গানিক ট্রাফিক বা ক্রেডিট পাচ্ছে না। অনেকেই এই সমস্যা সমাধান করতে Cloudflare WAF-এ গিয়ে ঢালাওভাবে একটি Custom Rule বানিয়ে দেন। সমস্যা হলো, এই ভুল অ্যাপ্রোচের কারণে অনেক সময় Google Search Console (GSC)-এর /sitemap.xml এবং legitimate SEO Crawlers (যেমন Googlebot, Bingbot) ব্লক হয়ে যায়। এর ফলে Google Search Console-এ General HTTP error: 403 এরর দেখায় এবং সাইটের অর্গানিক র্যাঙ্কিং ধসে পড়ে। আমাদের আজকের এন্ড গোল হলো এমন একটি Production-Grade, Resilient Cloudflare WAF Rule আর্কিটেক্ট করা, যা শুধুমাত্র Unverified AI Scrapers এবং Bots-দের ব্লক করবে, কিন্তু Google বা Bing-এর মতো Verified Search Engine এবং সাধারণ ভিজিটরদের কোনো বাধা ছাড়া smooth access দেবে।
এই কনফিগারেশন শুরু করার আগে আপনার কিছু প্রাথমিক প্রস্তুতি ও Tooling দরকার হবে। প্রথমত, আপনার ডোমেইনের Cloudflare DNS এবং WAF Dashboard-এ Active Admin বা Operator access থাকতে হবে। দ্বিতীয়ত, টেস্টিংয়ের জন্য আপনার Terminal-এ curl অথবা Postman এবং একটি Google Search Console (GSC) অ্যাকাউন্ট লাগবে। পাশাপাশি Cloudflare WAF-এর Expression Builder এবং HTTP Header (বিশেষ করে User-Agent) সম্পর্কে প্রাথমিক ধারণা থাকলে এই সেটআপটি বোঝা আপনার জন্য অনেক সহজ হবে।
Edge Layer Blocking আসলে কীভাবে কাজ করে, তা বোঝার জন্য একটি বাস্তব অ্যানালজি চিন্তা করা যাক। যখন কোনো রিকোয়েস্ট আপনার সার্ভারে আসে, তখন অরিজিন সার্ভারে পৌঁছানোর আগেই Cloudflare-এর Edge Network সেই রিকোয়েস্ট ইন্টারসেপ্ট করে। ধরুন আপনার অফিসের গেইটে একজন সিকিউরিটি গার্ড দাঁড়িয়ে আছে। আপনি তাকে বললেন, "কেউ যদি মুখে বলে সে পুলিশের লোক, তাকে ঢুকতে দিও না।" এখন একজন আসল পুলিশ অফিসার এসে আইডি কার্ড দেখানোর পরেও যদি গার্ড তাকে শুধু মুখের কথার ওপর ভিত্তি করে আটকে দেয়, তবে বিপদ! সাধারণ User-Agent ব্লকিং ঠিক এই কাজটাই করে। আমাদের আজকের সলিউশন হলো সিকিউরিটি গার্ডকে শেখানো যে সে যেন মুখের কথা (User-Agent) বিশ্বাস না করে, বরং অফিসিয়াল ভেরিফায়েড আইডি ব্যাজ (cf.client.bot) চেক করে আসল সার্চ ইঞ্জিন আর নকল AI স্ক্র্যাপারদের আলাদা করতে পারে।
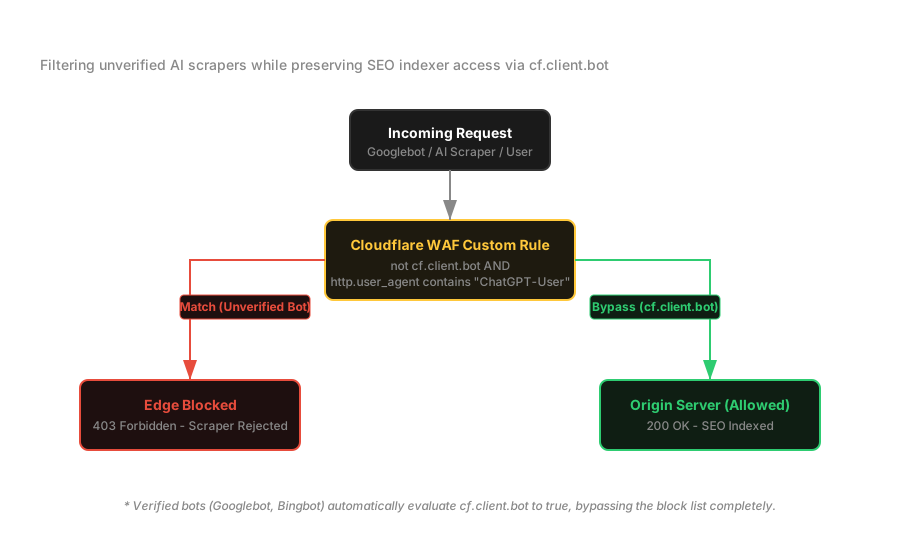
এবার আমরা Step-by-Step Implementation শুরু করব। প্রথম স্টেপে আপনাকে Cloudflare Dashboard-এ লগইন করে আপনার টার্গেট ডোমেইন সিলেক্ট করতে হবে। এরপর বাম পাশের সাইডবার থেকে Security > Security rules সেকশনে যান এবং Custom rules ট্যাবে ক্লিক করুন। নতুন রুল তৈরি করার জন্য Create rule বাটনে ক্লিক করুন। রুলের একটি মিনিংফুল নাম দিন, যেমন: AI Crawl Control - Block Unverified Scrapers। রুলগুলোর মধ্যে অর্ডারিং ঠিক রাখুন, যেন এটি অন্যান্য নরমাল রাউটিং রুলের আগে এক্সিকিউট হয়। দ্বিতীয় স্টেপে আমরা Visual Expression Builder-এর পরিবর্তে কোড-লেভেল লজিক ব্যবহারের জন্য Advanced Editor ব্যবহার করব। Expression Preview বক্সের ডান পাশে থাকা নীল রঙের Edit expression লিংকে ক্লিক করুন। এতে আপনি সরাসরি SQL-like syntax লেখার অপশন পাবেন।
তৃতীয় স্টেপে আমরা Core AI Bot Blocking Logic ইনজেক্ট করব। নিচের এক্সপ্রেশনটি এডিটরে পেস্ট করুন। এটি মূলত পরিচিত AI Scraper-দের User-Agent টার্গেট করে এবং /robots.txt ফাইলকে ব্লকিংয়ের বাইরে রাখে যাতে ক্রলাররা আপনার সাইটের নিয়ম পড়তে পারে:
(http.request.uri.path ne "/robots.txt" and (http.user_agent contains "Applebot" or http.user_agent contains "archive.org_bot" or http.user_agent contains "ChatGPT-User" or http.user_agent contains "ClaudeBot" or http.user_agent contains "DuckAssistBot" or http.user_agent contains "MistralAI-User" or http.user_agent contains "OAI-SearchBot" or http.user_agent contains "Perplexity-User" or http.user_agent contains "PerplexityBot"))চতুর্থ স্টেপে আমরা এই রুলটিকে Verified Bot Protection দিয়ে আপগ্রেড করব। শুধু User-Agent ব্লক করা নিরাপদ নয়, কারণ চালাক Scraper-রা নিজেদের Googlebot হিসেবে স্পুফ (Spoof) করতে পারে। আবার আমরা যদি ম্যানুয়ালি Googlebot বাদ দিতে যাই, তবে ভুল হওয়ার সম্ভাবনা থাকে। তাই আমরা Cloudflare-এর নেটিভ cf.client.bot ফিল্ড ইন্টিগ্রেট করব। Cloudflare নিজে Reverse DNS এবং IP Reputation দিয়ে ভেরিফাই করে কারা আসল সার্চ ইঞ্জিন। আপনার এক্সপ্রেশনের শুরুতে not cf.client.bot and যোগ করে ফাইনাল কোডটি এভাবে সেট করুন:
(not cf.client.bot and http.request.uri.path ne "/robots.txt" and (http.user_agent contains "Applebot" or http.user_agent contains "archive.org_bot" or http.user_agent contains "ChatGPT-User" or http.user_agent contains "ClaudeBot" or http.user_agent contains "DuckAssistBot" or http.user_agent contains "MistralAI-User" or http.user_agent contains "OAI-SearchBot" or http.user_agent contains "Perplexity-User" or http.user_agent contains "PerplexityBot"))নিচে Action সেকশন থেকে Block সিলেক্ট করুন এবং Deploy বাটনে ক্লিক করে রুলটি লাইভ করুন।
Important
কেন not cf.client.bot ব্যবহার করবেন?
কোনো Scraper যদি তার User-Agent-এ Googlebot লিখে আপনার সার্ভারে হিট করে, Cloudflare ব্যাকএন্ডে চেক করে দেখবে আইপিটি সত্যিই গুগলের কি না। যদি না হয়, তবে cf.client.bot false রিটার্ন করবে এবং Scraper-টি সাথে সাথে ব্লক হয়ে যাবে। এটি আপনার সাইটকে স্পুফিং অ্যাটাক থেকে 100% সুরক্ষিত রাখবে।
ডেপ্লয়মেন্ট শেষ হলে এবার Verification এবং Testing-এর পালা। প্রথমত, আপনার টার্মিনাল ওপেন করুন এবং একটি AI Bot-এর User-Agent সাজিয়ে সাইটে রিকোয়েস্ট পাঠান। আপনি 403 Forbidden রেসপন্স পাবেন:
curl -I -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot" https://yourdomain.com/sitemap.xmlএবার একটি নরমাল ব্রাউজার User-Agent দিয়ে টেস্ট করুন। আপনি 200 OK স্ট্যাটাস দেখতে পাবেন:
curl -I -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36" https://yourdomain.comদ্বিতীয়ত, Cloudflare Dashboard থেকে Security > Events-এ যান। অ্যাক্টিভিটি লগে দেখুন আপনার সদ্য তৈরি করা রুলটি ট্রিগার হচ্ছে কি না। সেখানে ব্লক হওয়া রিকোয়েস্টগুলোর IP, User-Agent এবং Action status (Block) ভেরিফাই করুন। তৃতীয়ত, সরাসরি Google Search Console-এ যান এবং আপনার সাইটের Sitemaps সেকশনে ক্লিক করুন। আপনার /sitemap.xml ফাইলটি রিসিঙ্ক বা পুনরায় সাবমিট করুন। কিছুক্ষণের মধ্যেই দেখবেন স্ট্যাটাস Success হয়ে গেছে এবং কোনো 403 এরর আর আসছে না।
Warning
কমন ডিবাগিং টিপ:
রুল ডেপ্লয় করার পরেও যদি Google Search Console-এ 403 এরর পান, তবে চেক করুন আপনার রুলে কোথাও ভুলবশত not cf.client.bot বাদ পড়েছে কি না অথবা অন্য কোনো পুরনো Firewalls বা Rate Limiting রুল গুগলকে ব্লক করছে কি না।
পরিশেষে, এই রুলটি অ্যাপ্লাই করার কিছু ট্রেড-অফ (Trade-offs) মাথায় রাখা জরুরি। আপনার ইউজাররা যদি কখনো সরাসরি আপনার সাইটের কোনো লিংক ChatGPT বা Perplexity-র চ্যাটবক্সে দিয়ে সামারাইজ বা অ্যানালাইজ করতে বলে, তবে AI সেটি পড়তে পারবে না (কারণ AI ক্রলার ব্লক খাবে)। আপনার বিজনেস মডেল যদি AI-driven ডিরেক্ট লিংক রিডিংয়ের ওপর নির্ভরশীল হয়, তবে এই ব্লক না রাখাই ভালো। ফিউচার স্কেলিং ও মেইনটেন্যান্সের জন্য মনে রাখবেন, AI ইন্ডাস্ট্রি খুব দ্রুত পরিবর্তন হচ্ছে এবং নতুন নতুন বট প্রতিদিন তৈরি হচ্ছে। প্রতি মাসে একবার Cloudflare-এর Security > Events লগ চেক করে নতুন কোনো Unverified Scraper চোখে পড়লে তাদের User-Agent আপনার WAF এক্সপ্রেশনে অ্যাড করে নেবেন। প্রয়োজনে প্রিমিয়াম Cloudflare Bot Management ফিচারও এক্সপ্লোর করতে পারেন।