AI Agent কেন Double Charge করে: Crash-Safe Tool Execution Under the Hood

On this page
ধরুন আপনার team একটা Subscription Renewal Agent বানিয়েছে। কাজটা সোজা: customer এর card charge করো, তারপর তার account এ entitlement grant করো। এক সকালে support team জানাল, একজন customer এর card থেকে একই renewal এর জন্য দুইবার টাকা কেটেছে। প্রথমে সবাই ধরে নিল, Agent বোধহয় hallucinate করেছে। কিন্তু Log খুলে দেখা গেল, Agent আসলে ঠিক সেটাই করেছে যা framework তাকে শিখিয়ে রেখেছিল: Timeout পেলে retry করো। Model এর কোনো দোষ ছিল না, দোষটা ছিল retry এর জায়গায়।
এই ধরনের incident এর একটা অদ্ভুত দিক আছে। Payment provider এর Idempotency Key পুরোপুরি ঠিক থাকলেও duplicate charge হতে পারে, কারণ retry যদি Key যে layer এ আছে তার এক layer উপরে হয়, তাহলে provider এর চোখে সেটা একদম নতুন একটা request। ইন্টারনেটে এ নিয়ে অনেক ছোট ছোট পোস্ট আছে, যেগুলো বলে "প্রতিটা write tool এ Idempotency Key বসান"। কথাটা ঠিক, কিন্তু অসম্পূর্ণ। কোন Key, কে বানাবে, কোথায় জমা থাকবে, আর crash ঠিক কোন মুহূর্তে হলে কী ঘটবে, এই প্রশ্নগুলোর উত্তর না জানলে Key বসিয়েও আপনি নিরাপদ নন।
এই ব্লগের মূল বক্তব্য একটাই: Idempotency একটা single call এর property না, এটা পুরো execution path এর property। আমরা কোনো theory ধার করে বসাব না। একটা ছোট Agent Runtime বানিয়ে প্রতিটা critical মুহূর্তে process kill করব, Database এ duplicate side effect গুনব, তারপর ছয় ধাপের একটা Guard Ladder বেয়ে উঠব: Naive Resume থেকে শুরু করে Durable Execution, Atomic Commit আর UNKNOWN State পর্যন্ত। প্রতিটা ধাপ শুরু হবে আগের ধাপ ঠিক কোথায় ভাঙে সেটা দেখিয়ে। শেষে আপনার হাতে থাকবে একটা Decision Flowchart আর একটা Production Checklist। এটা আমার আগের Exactly Once Delivery আর Distributed Locks লেখার ধারাবাহিকতা, তাই ওই দুটো পড়া থাকলে যোগসূত্র সহজে ধরতে পারবেন।
Table of Contents
- Step 1: The Incident Anatomy
- Step 2: Intent vs Attempt, The Mental Model
- Step 3: Anatomy of a Tool Call and the Four Crash Windows
- Step 4: Building the Crash Injection Lab
- Step 5: The Guard Ladder
- Step 6: Results, What the Matrix Tells Us
- Step 7: How Production Systems Do It
- Recap and Production Checklist
Step 1: The Incident Anatomy
প্রথমে ঘটনার ক্রমটা পরিষ্কার করে নিই। Agent প্রথমে charge tool কে ডাকে, tool wrapper Stripe কে request পাঠায়, আর Stripe card থেকে টাকা কেটে নেয়। কিন্তু Response ফেরার পথে network error হয়, ফলে wrapper কখনো জানতেই পারে না যে charge সফল হয়েছে। Wrapper একটা Error সহ Agent এর কাছে ফেরত দেয়। Framework এর default retry policy তখন পুরো step টা আবার চালায়, আর সেই step এর ভেতরে charge এবং entitlement grant দুটোই ছিল। ফলে Stripe এ দ্বিতীয় charge যায়, তারপর grant হয়।
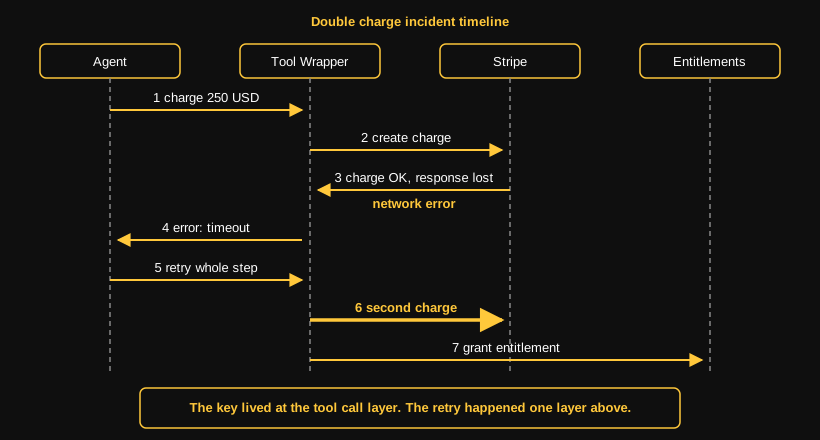
একটা বিষয় খেয়াল করুন: Stripe এর কাছে দ্বিতীয় request টা কোনো retry ছিল না, ছিল একটা সম্পূর্ণ নতুন charge এর অনুরোধ। এই ধরনের incident এ সাধারণত Key বানানো হয় tool wrapper এর ভেতরে, প্রতিটা call এ নতুন করে। Retry ঘটে wrapper এর উপরের layer এ, তাই wrapper আবার নতুন Key বানায়। Idempotency layer পুরোপুরি ঠিকঠাক কাজ করছিল, কিন্তু সে ভুল প্রশ্নের উত্তর দিচ্ছিল। এ ধরনের একটা real post mortem আপনি এই লেখায় (opens in a new tab) পাবেন, যেখানে charge আর entitlement grant দুটোই duplicate হয়েছিল, কারণ retry ছিল Key এর এক layer উপরে।
Hallucination না, Retry Boundary
Double charge দেখতে ঠিক দুইটা সফল tool call এর মতো। তাই Agent এর reasoning ঘেঁটে কারণ খুঁজে লাভ নেই। কারণটা লুকিয়ে থাকে retry কোন layer এ ঘটছে আর Key কোন layer এ আছে, সেই দুইয়ের অমিলে।
Step 2: Intent vs Attempt, The Mental Model
একটা Restaurant এর অ্যানালজি দিয়ে শুরু করি। ওয়েটার আপনার অর্ডার নিয়ে কিচেনে গেল। কিচেন রান্না শুরু করল, কিন্তু ওয়েটার ফেরার পথে কিচেনের সাথে তার ফোন সংযোগ কেটে গেল। ওয়েটার জানে না অর্ডার পৌঁছেছে কিনা, তাই সে আবার অর্ডার দিল, আর আপনার টেবিলে দুইটা খাবার এল। সমাধান হলো প্রতিটা অর্ডারে একটা টোকেন নম্বর লিখে দেওয়া, যাতে কিচেন বলতে পারে "এই নম্বর আমি আগেই পেয়েছি"। এই টোকেন নম্বরই Idempotency Key। কিন্তু একটা প্রশ্ন থেকে যায়: ওয়েটার যদি নিজের খাতাটাই হারিয়ে ফেলে, তাহলে সে কি একই টোকেন নম্বর আবার লিখতে পারবে? ব্লগের বাকি অংশ আসলে এই প্রশ্নেরই উত্তর।
এই অ্যানালজি থেকে দুইটা শব্দ আলাদা করে নেওয়া জরুরি: Intent আর Attempt। Model যখন একটা tool call emit করে, সেটা একটা Intent, মানে "এই customer কে ২৫০ ডলার refund করো" এই সিদ্ধান্ত। Network error, timeout বা crash এর পর যতবার সেই কাজ আবার চেষ্টা করা হয়, প্রতিটা একটা Attempt। Idempotency এর পুরো কাজ হলো অনেকগুলো Attempt কে একটা Intent এ collapse করা। যে Key প্রতি Attempt এ নতুন বানানো হয়, সেটা Attempt এর পরিচয় বহন করে, Intent এর না, তাই সেই Key কোনো কাজেই আসে না।
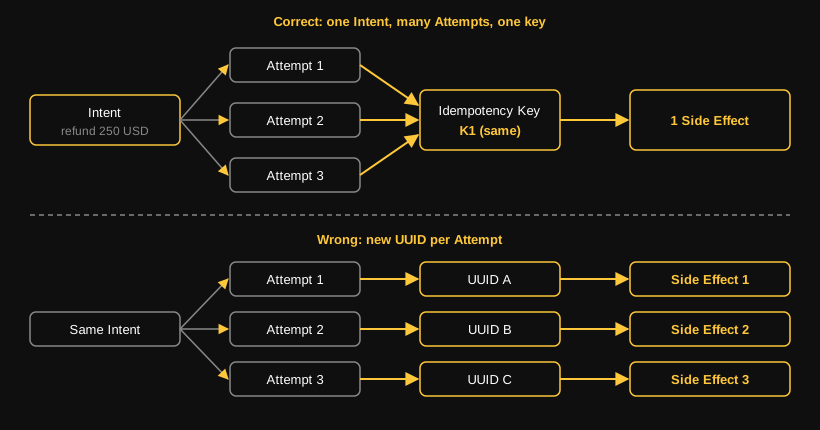
Delivery semantics নিয়ে বিস্তারিত আগের ব্লগে লিখেছি, তাই এখানে শুধু মূল কথাটুকু। Network এ সৎ guarantee আছে দুটো: At-most-once আর At-least-once। Exactly-once আসলে At-least-once delivery আর idempotent processing এর যোগফল, আলাদা কোনো জাদু না। Temporal এর মতো Durable Execution engine এও এই কথা খাটে: Workflow একবারই complete হয় এবং প্রতিটা Activity এর result একবারই record হয়, কিন্তু Activity নিজে at-least-once চলে। Record হওয়া আর execute হওয়া দুটো আলাদা জিনিস, আর duplicate side effect এর জন্ম ঠিক এই ফাঁকে।
একটা প্রশ্ন সবসময় নিজেকে করুন
আমার system এ "result record হওয়া" আর "effect ঘটা" কি একই মুহূর্তে ঘটে? যদি না ঘটে, তাহলে ওই দুই মুহূর্তের মাঝখানে একটা crash window আছে, আর সেখানেই আপনার duplicate লুকিয়ে আছে।
Step 3: Anatomy of a Tool Call and the Four Crash Windows
Agent loop এর ভেতরে একটা tool call এর জীবনচক্র মোটামুটি এরকম: LLM একটা tool বাছে, runtime সেই intent log করে, tool provider এর কাছে effect ঘটায়, runtime completion record লেখে, তারপর result LLM এর কাছে ফেরত যায়। এই পাঁচটা ঘটনার মাঝখানে চারটা ফাঁক আছে, আর আমরা সেগুলোকে বলব W1 থেকে W4।
| Window | ফাঁকটা কোথায় | Crash হলে কী অবস্থা |
|---|---|---|
| W1 | LLM এর সিদ্ধান্তের পরে, intent log হওয়ার আগে | কিছুই ঘটেনি |
| W2 | Intent log হয়েছে, effect provider এ পৌঁছায়নি | Intent আছে, effect নেই |
| W3 | Effect commit হয়েছে, completion record লেখা হয়নি | Effect আছে, কোনো প্রমাণ নেই |
| W4 | Completion record লেখা হয়েছে, LLM কে জানানো হয়নি | সব ঠিক, শুধু পরের step বাকি |
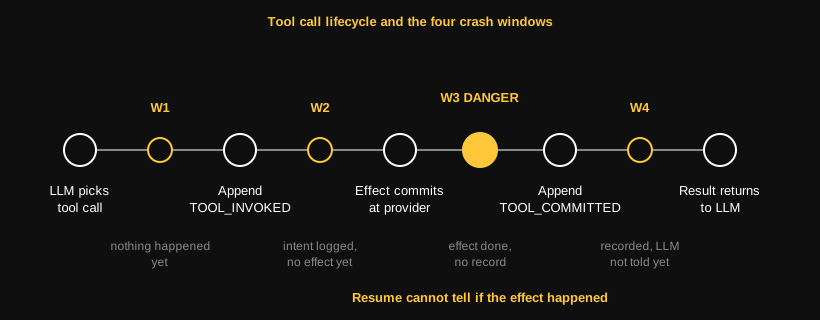
W3 সবচেয়ে ভয়ংকর, কারণ সেখানে external service ইতিমধ্যে commit করে ফেলেছে, কিন্তু আমাদের local record এ তার কোনো চিহ্ন নেই। Crash এর পর process আবার উঠলে সে দেখে intent লেখা আছে অথচ completion নেই, আর সে কিছুতেই বলতে পারে না effect ঘটেছিল কিনা। এই অনিশ্চয়তাকে আমরা বলব UNKNOWN state। Naive resume এখানে সবসময় ধরে নেয় effect ঘটেনি, আর ঠিক সেই ধারণাই duplicate এর জন্ম দেয়। Durable Agent Runtime (opens in a new tab) নামের একটা open source project এ ৬০টা crash point পরীক্ষা করা হয়েছিল। এর মধ্যে ৩৪টা crash পড়েছিল effect এর পরে, আর naive baseline সেগুলোর ৫২.৯% এ কাজটা আবার করে ফেলেছে, মোট ৪৪টা বাড়তি action।
Timeout মানে Failure না
Local timeout দেখে কখনো সিদ্ধান্ত নেবেন না যে remote effect ঘটেনি। Timeout শুধু বলে "আমি উত্তর পাইনি", কাজ হয়েছে কিনা সেটা বলে না। এই একটা ভুল ধারণা থেকেই বেশিরভাগ double charge এর জন্ম।
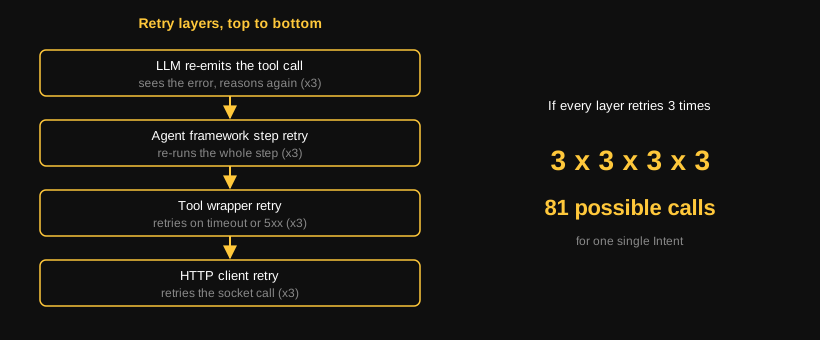
ব্যাপারটা আরও জটিল হয় কারণ একটা Agent এ retry একটা layer এ ঘটে না। HTTP client নিজে retry করে, tool wrapper retry করে, agent framework step retry করে, আর LLM নিজেও error দেখে আবার একই tool call emit করে। প্রতিটা layer আলাদাভাবে যুক্তিসঙ্গত, কিন্তু একসাথে তারা গুণ হয়ে যায়। প্রতি layer এ তিনবার করে retry হলে একটা মাত্র Intent এর জন্য সর্বোচ্চ ৮১টা call যেতে পারে। এখন বুঝতে পারছেন কেন Key রাখার জায়গাটা এত গুরুত্বপূর্ণ: Key যদি সবচেয়ে ভেতরের layer এ থাকে আর retry যদি সবচেয়ে বাইরের layer এ হয়, তাহলে বাইরের layer প্রতিবার নতুন Intent এর মতো আচরণ করবে।
Step 4: Building the Crash Injection Lab
Theory যথেষ্ট, এবার হাতে-কলমে দেখব। Lab এর design খুব সহজ: একটা scripted LLM (যাতে আচরণ deterministic থাকে), তিনটা tool (charge, send_email, grant_entitlement), আর একটা Side-Effect Ledger Database যেখানে প্রতিটা বাস্তব effect একটা row হিসেবে পড়ে। একটা Crash Injector নির্দিষ্ট window তে process কে SIGKILL করে, তারপর আমরা resume চালাই। সবশেষে একটা Oracle crash-free run এর ledger এর সাথে আমাদের ledger তুলনা করে duplicate এবং lost effect গোনে।
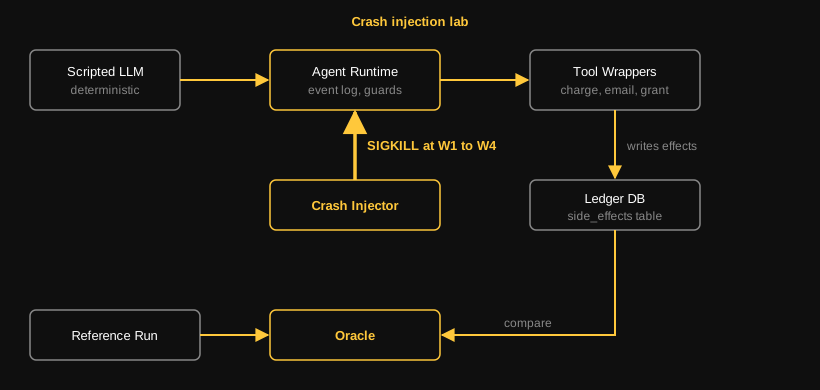
Crash Injector টা আশ্চর্য রকম ছোট। সে শুধু একটা environment variable দেখে, মিলে গেলে নিজের process কে মেরে ফেলে। Runtime এর প্রতিটা ফাঁকে আমরা একটা crashPoint call বসাই।
// crash.tsexport type CrashWindow = "W1" | "W2" | "W3" | "W4";
export function crashPoint(window: CrashWindow) { if (process.env.CRASH_AT === window) { console.error(`[lab] simulated crash at ${window}`); process.kill(process.pid, "SIGKILL"); // no cleanup, no finally blocks, like a real crash }}// runtime.ts (the four windows are exactly the four gaps in the tool call lifecycle)async function runStep(run: Run, call: ToolCall) { crashPoint("W1"); // nothing happened yet await appendEvent(run.id, "TOOL_INVOKED", call); // intent is durable now crashPoint("W2"); // intent logged, no effect yet const result = await tools[call.tool](call.args, call); // effect reaches the provider crashPoint("W3"); // effect done, no record await appendEvent(run.id, "TOOL_COMMITTED", { callId: call.id, result }); crashPoint("W4"); // recorded, LLM not told yet return result;}Ledger আর Oracle এর জন্য আমাদের একটাই table আর একটাই query লাগে। Tool এর বাস্তব effect, মানে "টাকা কাটা" বা "email যাওয়া", প্রতিবার এই table এ একটা row যোগ করে। Oracle শুধু গোনে প্রতিটা tool কতবার চলেছে।
CREATE TABLE side_effects (  id         BIGSERIAL PRIMARY KEY,  run_id     TEXT NOT NULL,  tool       TEXT NOT NULL,  detail     JSONB NOT NULL,  created_at TIMESTAMPTZ NOT NULL DEFAULT now());
-- Oracle: expected result is exactly one row per toolSELECT tool, count(*) AS timesFROM side_effectsWHERE run_id = $1GROUP BY tool;
প্রতিটা Guard Level আর প্রতিটা Window এর জন্য আমরা একটা করে crash চালাই, কোনো sampling ছাড়া। একটা ছোট shell loop পুরো matrix চালিয়ে দেয়: প্রথম run SIGKILL এ মরে, দ্বিতীয় run resume করে, তারপর Oracle ফলাফল CSV তে লেখে।
for level in 0 1 2 3 4 5; do for w in W1 W2 W3 W4; do pnpm lab:reset LEVEL=$level CRASH_AT=$w pnpm lab:run || true # first run dies by SIGKILL LEVEL=$level pnpm lab:run # resume run, no crash pnpm lab:oracle --level $level --window $w >> results/summary.csv donedoneআমরা মাপব চারটা জিনিস: Duplicate Side Effect Count, Lost Side Effect Count, Resume Time, আর বাড়তি LLM call। Seed fixed থাকবে, পুরো lab এক কমান্ডে চলবে, আর ফলাফল CSV হিসেবে repo তে commit করা থাকবে।
Step 5: The Guard Ladder
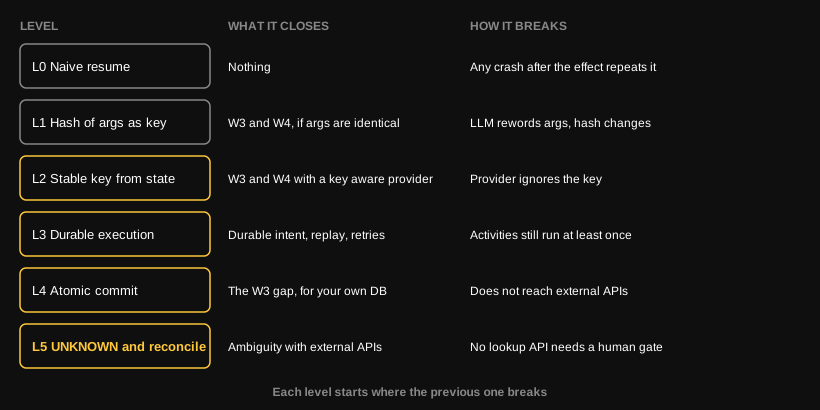
এবার মূল কাজ। আমরা ছয়টা Guard Level একটার পর একটা বসাব। প্রতিটা Level এর একটা নির্দিষ্ট ক্ষমতা আছে আর একটা নির্দিষ্ট ভাঙার জায়গা আছে। পদ্ধতিটা সহজ: Level N এ উঠে আমরা প্রথমে দেখাব আগের Level কোথায় ব্যর্থ হয়, তারপর সেই ফাঁক বন্ধ করব, আর তারপর দেখব নতুন Level নিজে কোথায় ভাঙে।
Level 0: Naive Resume
কোনো guard নেই। Crash এর পর runtime কোনো log দেখে না, পুরো plan শুরু থেকে আবার চালায়। এটা সবচেয়ে সাধারণ অবস্থা, কারণ বেশিরভাগ prototype এভাবেই লেখা হয়।
async function resumeNaive(run: Run) { // no event log, no key: start the whole plan again return runAgent(run.input);}W1 আর W2 তে crash হলে কোনো সমস্যা নেই, কারণ তখনো কোনো effect ঘটেনি। কিন্তু W3 আর W4 এ crash হলে effect ঘটে গেছে, আর resume সেটা আবার ঘটায়। এখানেই duplicate এর জন্ম।
Level 1: Hash of Args as Key
প্রথম সহজ সমাধান: tool এর arguments এর hash কে Idempotency Key বানানো। শুনতে যুক্তিসঙ্গত, আর যতক্ষণ args হুবহু এক থাকে, কাজও করে। সমস্যাটা শুরু হয় ঠিক তখন, যখন retry আসে LLM এর হাত ধরে। LLM retry তে আগের HTTP request replay করে না। সে error সহ নতুন context নিয়ে আবার reason করে নতুন একটা tool call বানায়, আর তখন args এর শব্দ বদলে যায়, field এর ক্রম বদলে যায়, কখনো নতুন field এসে যায়।
import { createHash } from "node:crypto";
const sha = (v: unknown) =>  createHash("sha256").update(JSON.stringify(v)).digest("hex");
// the first attemptconst first = { customer: "cus_42", amount: 25000, currency: "usd" };
// the retry: same intent, but the model re-reasoned and reworded the argsconst second = { currency: "usd", amount: 250, customer: "cus_42", unit: "dollars" };
console.log(sha(first) === sha(second)); // false, so two keys, so two charges
নিঃশব্দ Failure
এই ব্যর্থতায় কোনো error আসে না। Dedup check সফলভাবে পাশ হয়ে যায়, কারণ key টা সত্যিই নতুন। শুধু effect টা দ্বিতীয়বার চলে। Level 1 এর পরীক্ষা সবসময় সবুজ থাকবে, যতক্ষণ না আপনার model সত্যিকারের retry তে args reword করছে।
Level 2: Stable Key from Durable State
সমাধানের মূল নীতি: Key কখনো Model এর output থেকে আসবে না, আসবে Runtime এর durable state থেকে। Model যে tool call block emit করে, তার নিজের একটা ID থাকে। Orchestrator যখন একই turn retry করে, সে একই block ID আবার replay করে, তাই এই ID স্থিতিশীল। আমরা এর সাথে runId আর step মিলিয়ে Key বানাই। কিন্তু একটা শর্ত আছে, আর সেটা অনেকেই মিস করেন: intent কে আগে log এ লিখে ফেলতে হবে (W1 পেরোনোর আগেই)। না লিখলে crash এর পর LLM আবার ডাকা হবে, সে নতুন block ID দেবে, আর আপনি আবার নতুন Key পেয়ে যাবেন।
import { createHash } from "node:crypto";
export function idemKey(runId: string, step: number, toolCallId: string) {  return createHash("sha256").update(`${runId}:${step}:${toolCallId}`).digest("hex");}
// canonical JSON: sorted keys, so field order never mattersfunction canonical(v: unknown): string {  if (Array.isArray(v)) return `[${v.map(canonical).join(",")}]`;  if (v && typeof v === "object") {    const o = v as Record<string, unknown>;    return `{${Object.keys(o).sort().map((k) => `${JSON.stringify(k)}:${canonical(o[k])}`).join(",")}}`;  }  return JSON.stringify(v);}
// the fingerprint is NOT the key. It only detects "same key, different args"export const fingerprint = (args: unknown) =>  createHash("sha256").update(canonical(args)).digest("hex");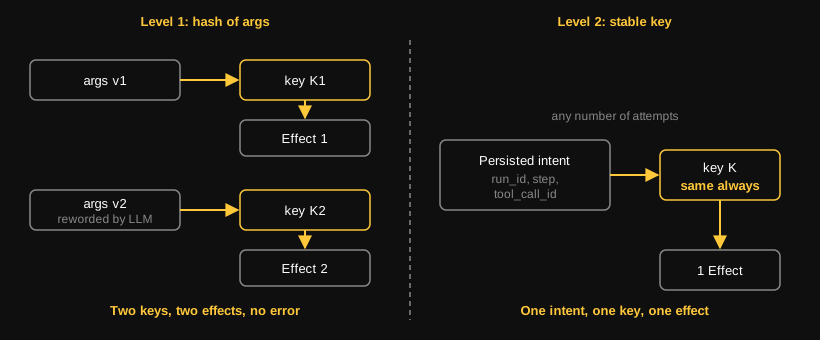
Provider যদি Idempotency Key সাপোর্ট করে, তাহলে এই Key টা তার কাছে পাঠিয়ে দিন। তাহলে W3 তে crash হলেও resume এ একই Key যাবে, আর provider আগের ফলাফলই ফেরত দেবে।
const intent = await stripe.paymentIntents.create( { amount: 25000, currency: "usd", customer: "cus_42", payment_method: pm, confirm: true, off_session: true, metadata: { idem_key: key }, // makes later lookup possible (Level 5) }, { idempotencyKey: key }, // the provider dedupes on this);Key এর সাথে তিনটা নিয়ম
প্রথমত, Key কে সবসময় caller অনুযায়ী scope করুন, যেমন (account_id, key) জোড়া, কখনো global না। দ্বিতীয়ত, একই Key দিয়ে ভিন্ন args এলে fail fast করুন (এজন্যই fingerprint)। তৃতীয়ত, TTL আপনার সবচেয়ে লম্বা agent run এর চেয়ে বড় রাখুন। Stripe এ Key মোটামুটি ২৪ ঘণ্টা থাকে, আর কোনো Key দিয়ে 400 error এলে retry তেও একই 400 ফেরত আসে, তাই recover করতে হলে নতুন Key লাগে।
Level 2 এর দুর্বলতা পরিষ্কার: এটা শুধু তখনই কাজ করে যখন provider Key মানে। Provider যদি Key উপেক্ষা করে, তাহলে W3 তে crash এর পর আপনার local record এ কিছু নেই, আর provider এ আবার request গেলে নতুন effect ঘটে যায়।
Level 3: Durable Execution
এবার আরেক ধাপ উপরে উঠি। Temporal এর মতো Durable Execution engine প্রতিটা Workflow এর প্রতিটা ধাপ একটা Event History তে লেখে। Worker crash করলে আরেকটা Worker সেই History replay করে state আবার তৈরি করে নেয়। যে Activity আগেই complete হয়েছে, তার result History থেকে পড়া হয়, Activity আবার চলে না। এই কারণেই Workflow code কে deterministic হতে হয়: Workflow এর ভেতরে Date.now() বা random ডাকা যায় না, কারণ replay তে ভিন্ন মান এলে History আর code মিলবে না। বদলে workflow.now() আর workflow.uuid4() এর মতো Temporal এর নিজস্ব primitive ব্যবহার করতে হয়, যেগুলো replay তেও একই মান দেয়।
from datetime import timedeltafrom temporalio import activity, workflowfrom temporalio.common import RetryPolicy
# `payments` and `entitlements` are your own client wrappers (imports omitted)
@activity.defnasync def charge_customer(customer_id: str, amount_cents: int) -> str:    info = activity.info()    key = f"{info.workflow_id}:{info.activity_id}"   # stable across retries    payment = await payments.charge(customer_id, amount_cents, idempotency_key=key)    return payment.id
@activity.defnasync def grant_entitlement(customer_id: str, payment_id: str) -> None:    info = activity.info()    key = f"{info.workflow_id}:{info.activity_id}"    await entitlements.grant(customer_id, payment_id, idempotency_key=key)
@workflow.defnclass RenewalWorkflow:    @workflow.run    async def run(self, customer_id: str, amount_cents: int) -> str:        payment_id = await workflow.execute_activity(            charge_customer,            args=[customer_id, amount_cents],            start_to_close_timeout=timedelta(seconds=30),            retry_policy=RetryPolicy(maximum_attempts=5),        )        await workflow.execute_activity(            grant_entitlement,            args=[customer_id, payment_id],            start_to_close_timeout=timedelta(seconds=15),        )        return payment_id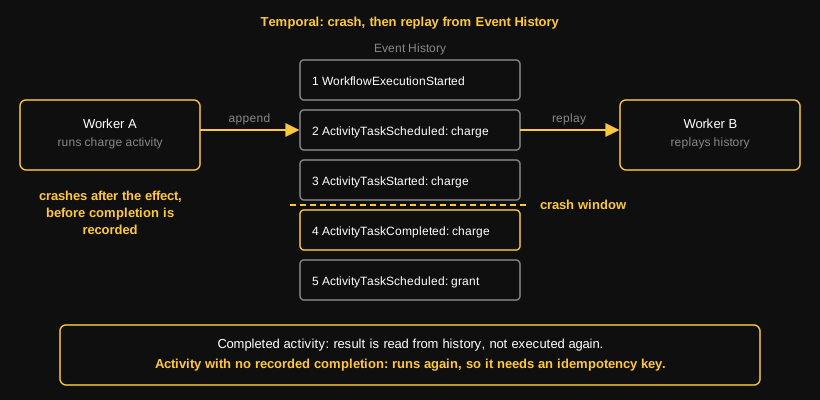
কিন্তু এখানে Level 3 এর সবচেয়ে বড় শিক্ষাটা লুকিয়ে আছে। Temporal Activity কে at-least-once চালায়। Worker যদি Activity সফলভাবে শেষ করে কিন্তু Temporal Service কে জানানোর আগেই crash করে, তাহলে Activity আবার চলবে। এটাই W3 এর হুবহু প্রতিরূপ, শুধু নামটা আলাদা। তাই Temporal এর নিজের docs ও বলছে, Activity কে idempotent হতে হবে, আর Key বানাতে Workflow ID এর সাথে Activity ID ব্যবহার করা যায়। (Docs Run ID এর সাথে Activity ID এর কথা বলে। আমি এখানে Workflow ID ব্যবহার করেছি, কারণ business level dedup এর জন্য ID টা Workflow এর run বদলালেও একই থাকে। আপনার use case অনুযায়ী ভেবে বেছে নিন।)
Heartbeat এর ফাঁদ
Heartbeat Timeout ছোট করলে Temporal মৃত Worker দ্রুত ধরে ফেলে, ফলে retry দ্রুত হয়। কিন্তু দ্রুত retry মানে বেশি retry, আর বেশি retry মানে বেশি duplicate এর সুযোগ। Heartbeat এ ঘাবড়াবেন না, শুধু মনে রাখুন এতে Key এর গুরুত্ব কমে না, বরং বাড়ে। Local Activity তেও একই সতর্কতা: Workflow Task fail হলে ওই task এর সব Local Activity আবার চলে।
Saga এবং compensation নিয়েও একটা কথা। "Step 3 fail করলে Step 2 আর Step 1 undo করো" শুনতে সুন্দর, কিন্তু compensation নিজেও একটা side effect। Refund tool কে দুইবার চালালে দুইবার refund যায়, তাই compensation কেও একই Key নিয়মে idempotent হতে হবে। Durable Execution ঝামেলা কমায়, ঝামেলা শূন্য করে না।
Level 4: Atomic Effect and Completion Record
এবার একটা মৌলিক নীতিতে আসি: যদি effect আর তার completion record একই Database transaction এ commit হয়, তাহলে ওদের মাঝখানে crash হওয়ার কোনো মুহূর্তই থাকে না। W3 নামের ফাঁকটা তখন অস্তিত্বহীন হয়ে যায়। এই কাজটা সম্ভব যখন effect আপনার নিজের Database এ ঘটে, যেমন entitlement grant, ledger এ credit, বা order status বদলানো।
export async function grantEntitlementAtomic(  runId: string, step: number, customerId: string, plan: string,) {  const key = `${runId}:${step}:grant`;  const client = await pool.connect();  try {    await client.query("BEGIN");
    const ins = await client.query(      `INSERT INTO entitlements (idem_key, customer_id, plan)       VALUES ($1, $2, $3)       ON CONFLICT (idem_key) DO NOTHING       RETURNING idem_key`,      [key, customerId, plan],    );
    await client.query(      `INSERT INTO run_events (run_id, seq, type, payload)       VALUES ($1, $2, 'STEP_COMPLETED', $3)       ON CONFLICT (run_id, seq) DO NOTHING`,      [runId, step, JSON.stringify({ key, applied: ins.rowCount === 1 })],    );
    await client.query("COMMIT"); // both rows, or neither  } catch (e) {    await client.query("ROLLBACK");    throw e;  } finally {    client.release();  }}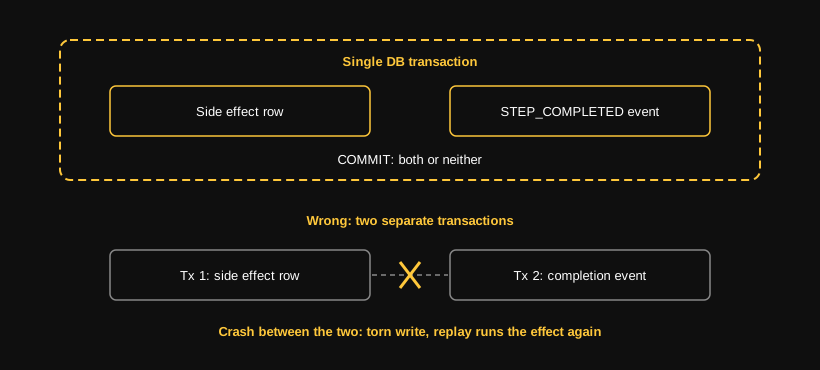
এই design এর আরেকটা সুবিধা আছে। প্রতিটা STEP_COMPLETED event একটা append-only log এ জমা হয়, আর agent এর state আলাদা করে serialize করার দরকারই পড়ে না: log replay করলেই state ফিরে আসে। এটা আপনার আগের Transactional Outbox আর Inbox এর ব্লগের সাথে সরাসরি সম্পর্কিত। সেখানে আমরা message পাঠানো আর state বদলানোকে একটা transaction এ বেঁধেছিলাম, এখানে tool effect আর completion record কে বাঁধছি।
Level 4 এর সীমা
Atomic commit শুধু তখনই কাজ করে যখন effect আর record একই Database এ থাকে। Stripe এ টাকা কাটা বা Gmail এ email পাঠানো কখনো আপনার Postgres transaction এর অংশ হতে পারে না। ওগুলোর জন্য Level 5 লাগবে।
Level 5: UNKNOWN State and Reconciliation
শেষ ধাপটা সবচেয়ে সৎ। যখন external API Key সাপোর্ট করে না, আর effect আপনার নিজের Database এও নেই, তখন W3 এর অনিশ্চয়তা মুছে ফেলা যায় না। সেটা স্বীকার করে নিয়ে design করতে হয়। এজন্য প্রতিটা tool operation এর একটা স্পষ্ট state machine থাকবে: PENDING, INVOKED, COMMITTED, UNKNOWN, FAILED। আর নিয়ম একটাই: agent কখনো timeout দেখে সিদ্ধান্ত নেবে না যে effect হয়েছে কিনা। সে operation কে UNKNOWN চিহ্নিত করবে, তারপর provider কে জিজ্ঞেস করবে।
CREATE TABLE tool_operations ( idem_key TEXT PRIMARY KEY, run_id TEXT NOT NULL, tool TEXT NOT NULL, args_fingerprint TEXT NOT NULL, state TEXT NOT NULL CHECK (state IN ('PENDING','INVOKED','COMMITTED','UNKNOWN','FAILED')), result JSONB, updated_at TIMESTAMPTZ NOT NULL DEFAULT now());async function setState(key: string, state: string, result?: unknown) { await pool.query( `UPDATE tool_operations SET state = $2, result = COALESCE($3, result), updated_at = now() WHERE idem_key = $1`, [key, state, result === undefined ? null : JSON.stringify(result)], );}
export async function executeOnce( call: ToolCall, effect: (key: string) => Promise<unknown>, lookup?: (key: string) => Promise<unknown | null>, // ask the provider "did this happen?") { const key = idemKey(call.runId, call.step, call.toolCallId); const fp = fingerprint(call.args);
// atomic claim: only one attempt wins the INSERT const claim = await pool.query( `INSERT INTO tool_operations (idem_key, run_id, tool, args_fingerprint, state) VALUES ($1, $2, $3, $4, 'INVOKED') ON CONFLICT (idem_key) DO NOTHING RETURNING idem_key`, [key, call.runId, call.tool, fp], );
if (claim.rowCount === 0) { const { rows } = await pool.query( `SELECT state, result, args_fingerprint FROM tool_operations WHERE idem_key = $1`, [key], ); const op = rows[0]; if (op.args_fingerprint !== fp) throw new Error("IDEMPOTENCY_KEY_REUSED_WITH_DIFFERENT_ARGS"); if (op.state === "COMMITTED") return op.result; // replay the recorded result if (op.state === "FAILED") throw new Error("OPERATION_PREVIOUSLY_FAILED");
// INVOKED or UNKNOWN: an earlier attempt may have reached the provider if (!lookup) { await setState(key, "UNKNOWN"); throw new NeedsHumanApproval(call, key); // no way to know, so ask a human } const found = await lookup(key); if (found) { await setState(key, "COMMITTED", found); return found; } // provider has no record: fall through and run the effect once more }
try { const result = await effect(key); await setState(key, "COMMITTED", result); return result; } catch (err) { // 4xx validation error before any effect: FAILED. Anything ambiguous: UNKNOWN await setState(key, isDefinitelyNotSent(err) ? "FAILED" : "UNKNOWN"); throw err; }}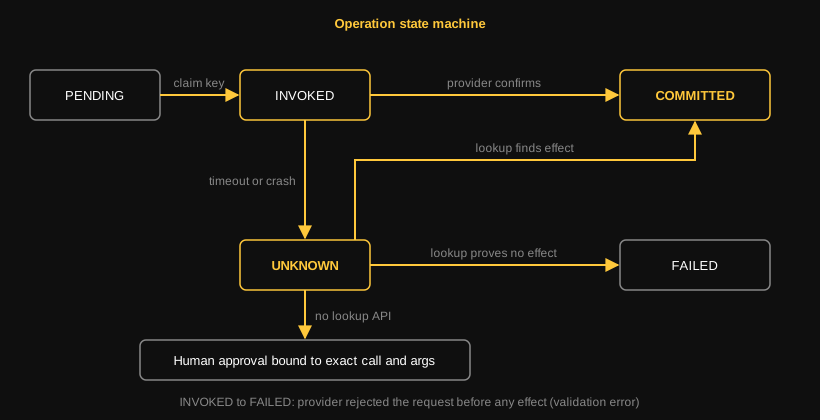
"Lookup এ কিছু নেই" মানে "Effect হয়নি" না
কিছু search API তে নতুন data দেখা যেতে কিছুটা delay হয়। তাই lookup খালি এলেই ধরে নেবেন না যে effect ঘটেনি। Retry করার সময় যেখানে সম্ভব একই Key ব্যবহার করুন। Production এ INVOKED state এর সাথে একটা lease (যেমন locked_until) যোগ করবেন, যাতে একই সময়ে চলতে থাকা দুটো attempt একে অপরকে ভুল বুঝে duplicate না বানায়।
যে operation কে idempotent করা অসম্ভব, যেমন একটা irreversible production deploy, সেখানে শেষ ভরসা Human Approval। কিন্তু approval টা বাঁধতে হবে হুবহু ওই tool call আর ওই args এর সাথে, নইলে "X অনুমোদন দিলাম, Y চলে গেল" ধরনের ফাঁক তৈরি হয়। এর সাথে প্রতিটা tool কে retry classification দিন: safe, idempotent আর unsafe। আর error response এ ফেরত পাঠান retryable আর retry_after_seconds, যাতে Agent একই retry logic সব failure তে প্রয়োগ না করে। 400 এ retry করে লাভ নেই, 503 এ হয়তো আছে।
Step 6: Results, What the Matrix Tells Us
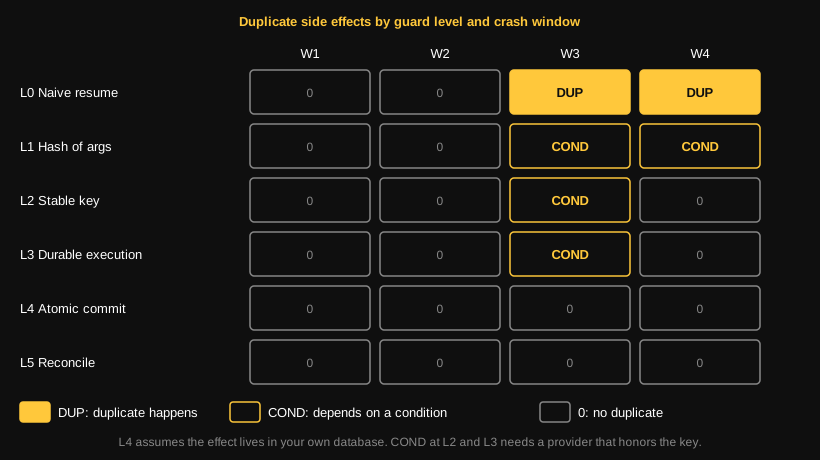
ছয় Level আর চার Window মিলিয়ে চব্বিশটা ঘর। নিচের Matrix টা প্রতিটা Level এর design guarantee দেখায়: কোন window তে duplicate ঘটে, কোথায় ঘটে না, আর কোথায় একটা শর্তের উপর নির্ভর করে।
সংখ্যাগুলো আপনি নিজে বের করুন
Matrix এর ঘরগুলো প্রতিটা Level এর design থেকে আসা যৌক্তিক ফলাফল। সঠিক duplicate count আপনি lab চালালে results/summary.csv এ পাবেন। Lab এর repo: agent-crash-lab।
Matrix থেকে তিনটা জিনিস চোখে পড়ে। প্রথমত, W1 আর W2 কোনো Level এই সমস্যা না, কারণ তখনো কোনো effect ঘটেনি। দ্বিতীয়ত, সব কঠিন লড়াই W3 তে। Level 2 আর Level 3 এ W3 এখনো শর্তসাপেক্ষ, কারণ তারা provider এর Key মানার উপর নির্ভর করে। তৃতীয়ত, শূন্যে পৌঁছানোর দুটো উপায় আছে, আর দুটোই আলাদা ধরনের: Level 4 ফাঁকটাই মুছে দেয় (শুধু নিজের Database এর জন্য), আর Level 5 ফাঁকটা স্বীকার করে তার উপর reconcile করে।
প্রতিটা Level এর একটা মূল্যও আছে, আর বিনা মূল্যে কোনো guarantee মেলে না।
| Level | বাড়তি storage | বাড়তি latency | Complexity |
|---|---|---|---|
| L0 Naive | নেই | নেই | Low |
| L1 Hash key | ছোট একটা key store | একটা lookup | Low |
| L2 Stable key | Key আর fingerprint table | প্রতি call এ একটা write | Medium |
| L3 Durable execution | Event History আর workflow service | Scheduling hop | High |
| L4 Atomic commit | একই Database এ বাড়তি row | বাড়তি network call নেই | Medium |
| L5 UNKNOWN আর reconcile | Operation table আর reconcile path | Ambiguity তে একটা lookup | High |
Latency এর ব্যাপারে একটা সংখ্যা দেওয়া যায়: Temporal এর নিজের docs অনুযায়ী Temporal Cloud এ একটা regular Activity এর scheduling overhead মোটামুটি ৫০ ms এর কাছাকাছি। কথাটা মনে রাখবেন, কারণ Level 3 বেছে নেওয়ার সময় এটা আপনার latency budget এ ঢুকবে।
এই Lab এর সীমাবদ্ধতা
Lab এ LLM scripted, তাই এটা বলে না বাস্তবে আপনার model কতবার args reword করে। Provider simulated, আর পুরো ব্যাপারটা একটা node এর একটা Postgres এ চলে। Lab প্রমাণ করে কোন design কোন crash window বন্ধ করে। Production এর load, network partition আর clock skew এখানে নেই, সেগুলো আলাদা পরীক্ষা চায়।
Step 7: How Production Systems Do It
Stripe এর কাছ থেকে শুরু করা যাক, কারণ Idempotency Key এর এই pattern তাদের হাত ধরেই জনপ্রিয় হয়েছে। Stripe Key টা মোটামুটি ২৪ ঘণ্টা ধরে রাখে, আর Brandur Leach এর reference implementation (opens in a new tab) এ একটা recovery_point field আছে। এর মানে multi-step request crash করলে সে শুরু থেকে আবার চলে না, সবশেষ সম্পন্ন ধাপ থেকে resume করে। এটা আমাদের Level 5 এর state machine এর কাছাকাছি, শুধু granularity টা আরও সূক্ষ্ম।
Durable Execution এর দিকে তাকালে, The New Stack এর একটা রিপোর্ট অনুযায়ী Temporal ৩০০০ এর বেশি paying customer এ পৌঁছেছে, আর তাদের পরীক্ষায় agentic worker মাঝপথে kill করলেও data loss বা double charge হয়নি। AI Agent এর জগতে "durable by default" এখন প্রায় একটা procurement শর্ত হয়ে উঠছে। MCP র দিকেও একই চাপ আসছে। Stateless Streamable HTTP তে stream ভাঙলে in-flight request হারিয়ে যায় আর client সেটা আবার পাঠায়, তাই MCP server এর প্রতিটা write idempotent হওয়া এখন সরাসরি production এর প্রয়োজন। Agent framework এর checkpointer ও একটা ভুল বোঝাবুঝির জায়গা: checkpointer থাকলে crash এর পর resume প্রায় তাৎক্ষণিক হয়, কিন্তু checkpoint লেখা হয় step শেষ হওয়ার পর। Effect আর checkpoint এর মাঝের ফাঁকে crash হলে effect আবার চলবেই, তাই checkpointer নিজে duplicate ঠেকায় না।
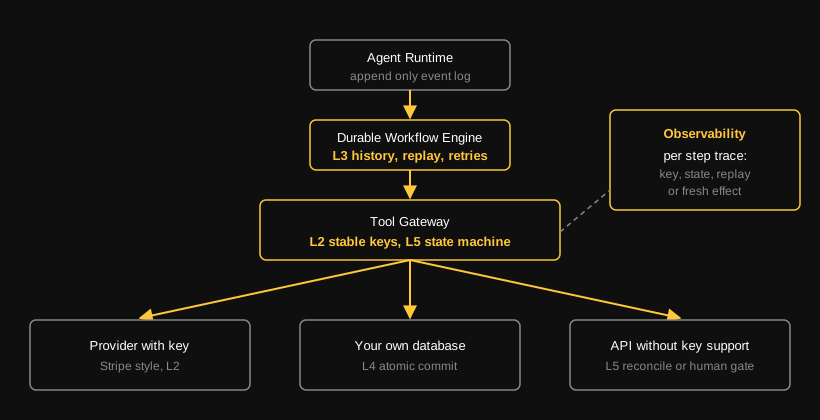
Observability নিয়ে একটা কথা। একটা agent observability guide এর হিসাব অনুযায়ী production এ tool call ৩ থেকে ১৫ শতাংশ সময় fail করে, আর এক জায়গার failure চুপচাপ পুরো workflow এ ছড়িয়ে যেতে পারে। তাই retry আসবেই, প্রশ্ন শুধু আপনি প্রস্তুত কিনা। Incident এ প্রমাণ পাওয়ার জন্য প্রতিটা tool step এর trace এ তিনটা জিনিস রাখুন: derive করা Key, operation এর state, আর ওই attempt টা replay ছিল নাকি fresh effect। এই তিনটা না থাকলে "ঠিক একবার charge হয়েছে" দাবিটার কোনো প্রমাণ আপনার হাতে থাকে না।
Recap and Production Checklist
পুরো ব্লগের সারকথা এক লাইনে: Retry আর Duplicate এর সম্পর্ক ভাঙতে হলে Key বানাতে হবে Durable State থেকে, LLM এর output থেকে না, আর Key কে থাকতে হবে সেই layer এ যেখানে retry ঘটে। W3 নামের ফাঁকটা মুছে ফেলা যায় (Level 4) অথবা স্বীকার করে reconcile করা যায় (Level 5), কিন্তু উপেক্ষা করা যায় না। আর "Exactly-once" আসলে At-least-once delivery আর idempotent effect এর যোগফল, কোনো জাদু না।
কোন Level আপনার দরকার, সেটা ঠিক হয় একটাই প্রশ্নে: tool এর effect ঠিক কোথায় ঘটে?
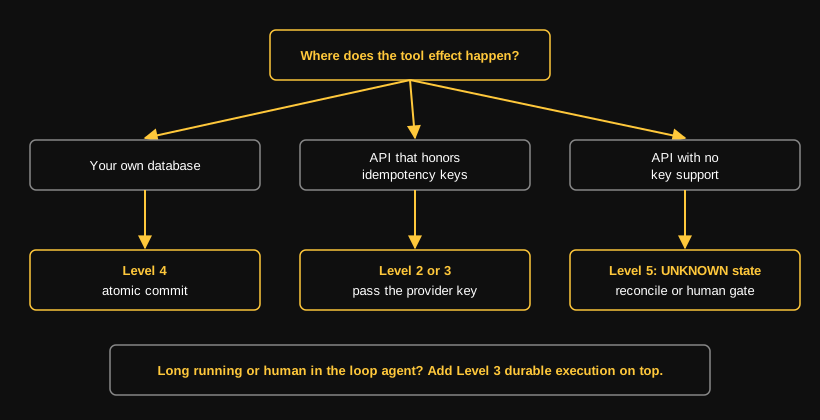
Production এ যাওয়ার আগে নিজেকে এই প্রশ্নগুলো করুন:
- আমার প্রতিটা write tool কি একটা caller-supplied Idempotency Key নেয়?
- Key কি Durable State থেকে derive হয় (
runId,step, tool call ID), নাকি args এর hash থেকে? - Intent কি tool চালানোর আগে log এ লেখা হয়?
- Retry কোন layer এ ঘটে আর Key কোন layer এ আছে? দুটো কি একই layer?
- W3 এ crash করলে আমার system কী করে? আমি কি কখনো এটা সত্যিই পরীক্ষা করেছি?
- External API dedupe না করলে আমার কি
UNKNOWNstate আর reconcile path আছে? - যে operation কে idempotent করা যায় না, সেখানে কি exact call আর args এ বাঁধা Human Approval আছে?
- Key এর TTL কি আমার সবচেয়ে লম্বা agent run এর চেয়ে বড়?
- Compensation (refund, rollback) কি নিজেও idempotent?
- প্রতিটা tool step এর trace এ Key, state আর replay-or-fresh লেখা থাকে?
আরও পড়ার জন্য:
- Exactly Once Delivery Myth এবং Distributed Locks
- Stripe: Designing robust and predictable APIs with idempotency (opens in a new tab)
- Brandur Leach: Implementing Stripe-like Idempotency Keys in Postgres (opens in a new tab)
- Temporal: Error handling in the Python SDK (opens in a new tab)
- Durable Agent Runtime, crash resume পরীক্ষার একটা open source উদাহরণ (opens in a new tab)
- Lab repo: agent-crash-lab